MySQL innodb_redo_log_capacity 동적 변경 실험: 줄어든 플러시 1,807페이지는 어디로 갔을까
대량 UPDATE가 느리고 디스크 쓰기가 많을 때, 가장 먼저 떠오르는 대책 중 하나가 Redo Log 용량을 늘리는 것입니다. Redo 공간에 여유가 생기면 Checkpoint에 쫓겨 페이지를 급하게 내려쓰는 일이 줄어든다는 논리입니다.
이 논리가 실제로 맞는지 MySQL 8.4.11에서 Redo Log를 100MB와 256MB로 바꿔 가며 같은 UPDATE를 실행해 보았습니다. 결과는 반만 맞았습니다.
- 256MB에서 UPDATE 중 플러시된 페이지는 20.3% 줄었습니다.
- 그런데 UPDATE 시간은 7.5% 늘었습니다.
- 그리고 줄어든 플러시 페이지 수(1,807)는 종료 직후 더 남아 있던 Dirty Page 수(1,802)와 거의 같았습니다.
세 번째 결과가 이 글의 핵심입니다. Redo Log를 늘려도 쓰기 작업이 없어지지는 않았습니다. 시점이 뒤로 미뤄졌을 뿐입니다.
Redo Log 용량이 플러시에 영향을 주는 이유
InnoDB는 데이터를 바꿀 때 먼저 변경 내용을 Redo Log에 기록합니다. 실제 데이터 페이지는 버퍼 풀(메모리)에서만 바꿉니다. 메모리에서는 바뀌었지만 아직 디스크에 쓰지 않은 페이지를 Dirty Page라고 합니다.
Redo Log는 정해진 크기의 공간을 돌려 가며 씁니다. 오래된 Redo 영역을 재사용하려면, 그 Redo가 가리키는 Dirty Page가 디스크에 먼저 써져 있어야 합니다. 이 기준점을 앞으로 옮기는 것이 Checkpoint입니다. 마지막으로 기록한 위치(Current LSN)와 Checkpoint 위치(Checkpoint LSN)의 간격을 Checkpoint Age라고 부릅니다.
Checkpoint Age가 Redo 용량에 가까워질수록 InnoDB는 Dirty Page를 더 적극적으로 디스크에 씁니다(Adaptive Flushing). 따라서 Redo 용량이 크면 Dirty Page를 메모리에 더 오래 둘 수 있습니다. 같은 페이지가 여러 번 바뀌면 한 번만 쓰면 되므로 쓰기가 줄어들 여지도 생깁니다.
하지만 플러시는 Redo 공간만 보고 결정되지 않습니다. 버퍼 풀의 Dirty Page 비율, 새 페이지를 읽어 들일 빈 공간 확보도 함께 영향을 줍니다. 이 실험의 버퍼 풀은 128MB로 작아서, 이 점이 결과에 드러났습니다.
참고로 MySQL 8.0.30부터는 innodb_redo_log_capacity 하나로 Redo 용량을 정하고, 서버를 재시작하지 않고도 바꿀 수 있습니다. 이전 버전의 innodb_log_file_size × innodb_log_files_in_group 방식과는 다릅니다. Redo 파일은 데이터 디렉터리의 #innodb_redo 폴더에 32개 파일로 나뉘어 관리됩니다.
실험 환경과 측정 방법
테스트 서버 상태
sql
SELECT
    VERSION() AS mysql_version,
    ROUND(@@GLOBAL.innodb_buffer_pool_size / 1024 / 1024, 1) AS buffer_pool_mb,
    ROUND(@@GLOBAL.innodb_redo_log_capacity / 1024 / 1024, 1) AS configured_redo_mb,
    (
        SELECT ROUND(CAST(VARIABLE_VALUE AS UNSIGNED) / 1024 / 1024, 1)
        FROM performance_schema.global_status
        WHERE VARIABLE_NAME = 'Innodb_redo_log_capacity_resized'
    ) AS applied_redo_mb,
    (
        SELECT VARIABLE_VALUE
        FROM performance_schema.global_status
        WHERE VARIABLE_NAME = 'Innodb_redo_log_resize_status'
    ) AS resize_status,
    @@GLOBAL.innodb_io_capacity AS io_capacity,
    @@GLOBAL.innodb_io_capacity_max AS io_capacity_max;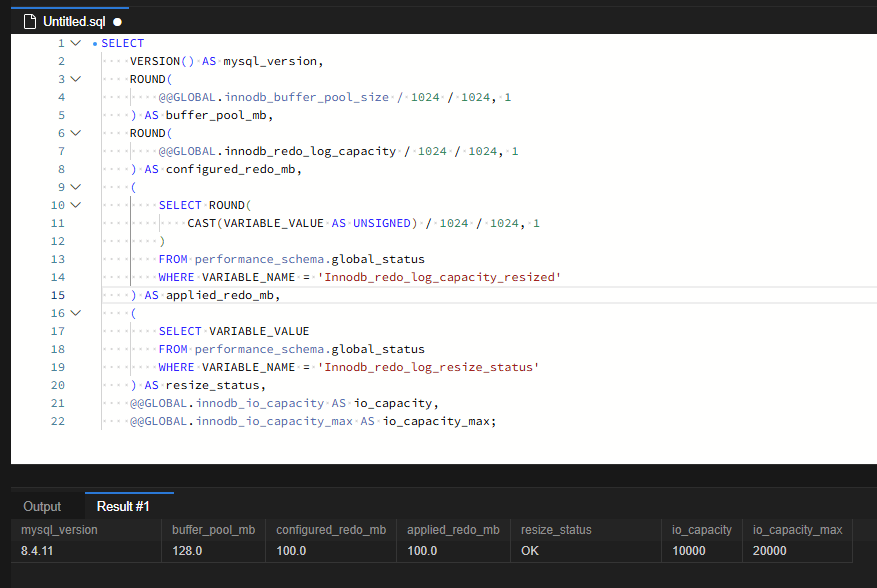
| 항목 | 값 |
|---|---|
| 서버 | MySQL Community Server 8.4.11, Windows 노트북, MySQL Workbench |
| 버퍼 풀 | 128MB (16KB 페이지 기준 8,192페이지) |
| Redo Log | 설정 100MB, 실제 적용 100MB, 상태 OK |
| innodb_io_capacity / max | 10000 / 20000 |
| UPDATE 범위 | id 1~100,000, 5만 행씩 2회 UPDATE 후 각각 COMMIT |
설정값(@@GLOBAL.innodb_redo_log_capacity)과 실제 적용값(Innodb_redo_log_capacity_resized)을 함께 조회한 이유가 있습니다. 동적 변경 직후에는 두 값이 일시적으로 다를 수 있기 때문입니다.
I/O Capacity 10000/20000은 이 서버에 원래 설정되어 있던 값입니다. 노트북 SSD 기준으로는 높은 편이며, 권장값이라는 뜻은 아닙니다.
본문의 MB는 캡처 표기에 맞춘 것이고, 실제 계산은 바이트를 1024²로 나눈 MiB 기준입니다.
UPDATE 시나리오
실험 테이블은 dba_lab.redo_checkpoint_test입니다. 측정 전에 대상 행의 redo_payload를 모두 512바이트로 채워 두었습니다. 첫 UPDATE에서만 행 길이가 늘어나 페이지 분할이 생기는 영향을 없애기 위해서입니다.
100MB 실험은 ‘A’, 256MB 실험은 ‘B’로 같은 길이의 값을 덮어썼습니다. 값을 바꾼 이유도 있습니다. 같은 값으로 UPDATE하면 InnoDB가 실제로 바뀐 것이 없다고 보고 변경을 건너뛸 수 있습니다.
sql
START TRANSACTION;

UPDATE dba_lab.redo_checkpoint_test
SET redo_payload = REPEAT('A', 512),
    updated_at = NOW(6)
WHERE id BETWEEN 1 AND 50000;

COMMIT;

START TRANSACTION;

UPDATE dba_lab.redo_checkpoint_test
SET redo_payload = REPEAT('A', 512),
    updated_at = NOW(6)
WHERE id BETWEEN 50001 AND 100000;

COMMIT;
측정 시간에는 두 UPDATE와 COMMIT, Workbench와 서버 사이의 왕복 시간이 모두 포함됩니다.
상태값을 기록한 방법
UPDATE 직전(before), 직후(after), 약 10초 뒤(idle)에 InnoDB 상태값을 redo_lab_snapshots 테이블에 저장했습니다. 저장한 항목은 다음과 같습니다.
| 컬럼 | 의미 | 출처 상태값 |
|---|---|---|
| current_lsn | 마지막으로 기록된 Redo 위치 | Innodb_redo_log_current_lsn |
| checkpoint_lsn | 마지막 Checkpoint 위치 | Innodb_redo_log_checkpoint_lsn |
| redo_bytes | Redo 누적 기록 바이트 | Innodb_os_log_written |
| pages_flushed | 버퍼 풀 누적 플러시 페이지 | Innodb_buffer_pool_pages_flushed |
| dirty_pages | 현재 Dirty Page 수 | Innodb_buffer_pool_pages_dirty |
before와 after의 차이를 계산하면 UPDATE 구간의 증가량이 나옵니다. 저장 방법의 예시는 다음과 같습니다.
sql
INSERT INTO dba_lab.redo_lab_snapshots
    (phase, captured_at, current_lsn, checkpoint_lsn,
     redo_bytes, pages_flushed, dirty_pages)
SELECT
    '100_before',
    NOW(6),
    MAX(CASE WHEN VARIABLE_NAME = 'Innodb_redo_log_current_lsn'     THEN VARIABLE_VALUE END),
    MAX(CASE WHEN VARIABLE_NAME = 'Innodb_redo_log_checkpoint_lsn'  THEN VARIABLE_VALUE END),
    MAX(CASE WHEN VARIABLE_NAME = 'Innodb_os_log_written'           THEN VARIABLE_VALUE END),
    MAX(CASE WHEN VARIABLE_NAME = 'Innodb_buffer_pool_pages_flushed' THEN VARIABLE_VALUE END),
    MAX(CASE WHEN VARIABLE_NAME = 'Innodb_buffer_pool_pages_dirty'  THEN VARIABLE_VALUE END)
FROM performance_schema.global_status
WHERE VARIABLE_NAME IN (
    'Innodb_redo_log_current_lsn',
    'Innodb_redo_log_checkpoint_lsn',
    'Innodb_os_log_written',
    'Innodb_buffer_pool_pages_flushed',
    'Innodb_buffer_pool_pages_dirty'
);
재시작 없이 256MB로 늘리기
먼저 원복에 쓸 원래 값을 기록합니다.
sql
SELECT @@GLOBAL.innodb_redo_log_capacity;
-- 104857600 (100MB)
그다음 256MB로 변경합니다.
sql
SET GLOBAL innodb_redo_log_capacity = 268435456;SET GLOBAL은 서버 전체에 즉시 적용됩니다. 재시작하면 원래 값으로 돌아갑니다. 영구 적용하려면 SET PERSIST를 쓰거나 설정 파일을 고쳐야 합니다. 이번 실험은 테스트용이라 SET GLOBAL만 사용했습니다.
명령이 성공했다고 해서 변경이 끝난 것은 아닙니다. 실제 적용 상태를 다시 확인합니다.
sql
SELECT
    ROUND(@@GLOBAL.innodb_redo_log_capacity / 1024 / 1024, 1) AS configured_redo_mb,
    MAX(CASE WHEN VARIABLE_NAME = 'Innodb_redo_log_capacity_resized'
             THEN ROUND(CAST(VARIABLE_VALUE AS UNSIGNED) / 1024 / 1024, 1)
        END) AS applied_redo_mb,
    MAX(CASE WHEN VARIABLE_NAME = 'Innodb_redo_log_resize_status'
             THEN VARIABLE_VALUE
        END) AS resize_status
FROM performance_schema.global_status
WHERE VARIABLE_NAME IN (
    'Innodb_redo_log_capacity_resized',
    'Innodb_redo_log_resize_status'
);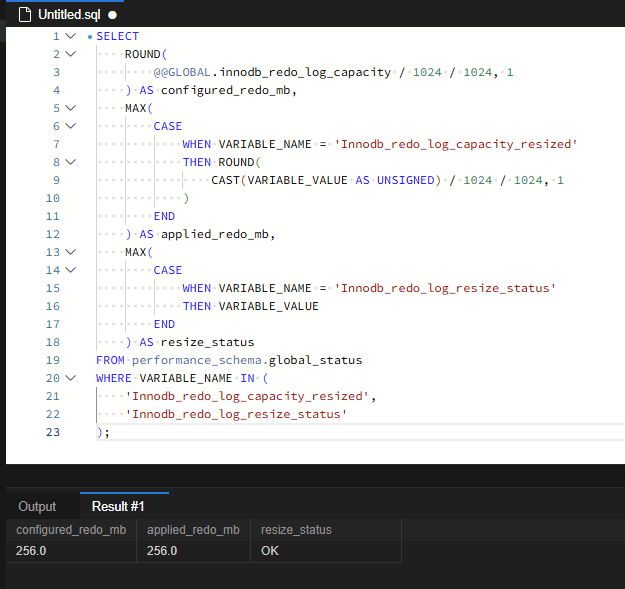
설정값과 실제 적용값이 모두 256MB이고, 상태는 OK입니다.
늘릴 때와 줄일 때는 다르게 동작합니다. 늘릴 때는 새 공간을 바로 쓸 수 있어서 대개 즉시 OK가 됩니다. 반면 줄일 때는 현재 Checkpoint Age가 새 용량 안에 들어올 때까지 기다려야 합니다. 그동안 상태값에 축소 진행 중이라는 표시가 남아 있고, 이 과정에서 플러시가 일시적으로 늘어날 수 있습니다.
결과: 플러시는 20% 줄고, 시간은 7.5% 늘었습니다
두 실험의 before와 after 스냅숏 차이를 한 번에 계산했습니다.
sql
SELECT
    CONCAT(s.capacity_mb, ' MB') AS redo_capacity,
    100000 AS updated_rows,
    MAX(CASE WHEN s.stage = 'after' THEN s.elapsed_ms END) AS elapsed_ms,
    ROUND(
        (MAX(CASE WHEN s.stage = 'after'  THEN s.redo_bytes END)
       - MAX(CASE WHEN s.stage = 'before' THEN s.redo_bytes END)) / 1024 / 1024, 2
    ) AS redo_written_mb,
    MAX(CASE WHEN s.stage = 'after'  THEN s.pages_flushed END)
  - MAX(CASE WHEN s.stage = 'before' THEN s.pages_flushed END) AS pages_flushed_delta,
    MAX(CASE WHEN s.stage = 'after' THEN s.dirty_pages END) AS dirty_pages_after,
    ROUND(
        MAX(CASE WHEN s.stage = 'after' THEN s.current_lsn - s.checkpoint_lsn END)
        / 1024 / 1024, 2
    ) AS checkpoint_age_mb
FROM (
    SELECT
        CAST(SUBSTRING_INDEX(phase, '_', 1) AS UNSIGNED) AS capacity_mb,
        SUBSTRING_INDEX(phase, '_', -1) AS stage,
        elapsed_ms, redo_bytes, pages_flushed,
        dirty_pages, current_lsn, checkpoint_lsn
    FROM redo_lab_snapshots
    WHERE phase IN ('100_before', '100_after', '256_before', '256_after')
) AS s
GROUP BY s.capacity_mb
ORDER BY s.capacity_mb;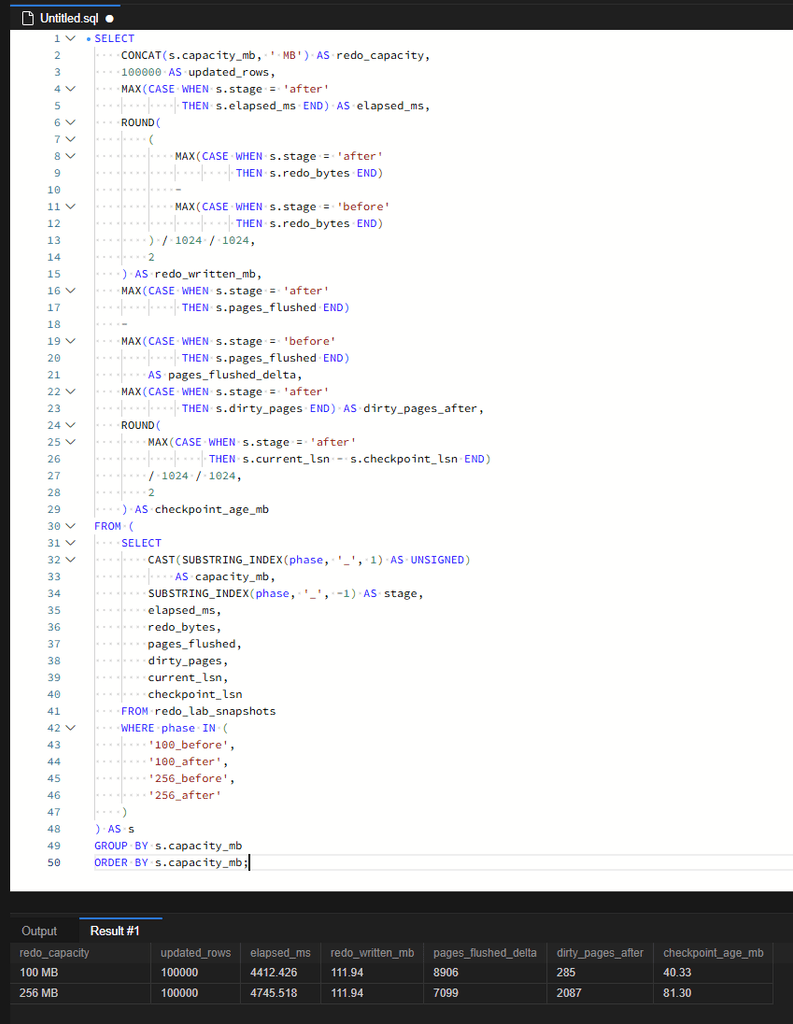
| 측정 항목 | Redo 100MB | Redo 256MB | 차이 |
|---|---|---|---|
| UPDATE 행 수 | 100,000 | 100,000 | 같음 |
| 측정 시간 | 4,412ms | 4,746ms | +333ms (+7.5%) |
| Redo 기록량 | 111.94MB | 111.94MB | 같음 |
| 플러시 페이지 증가 | 8,906 | 7,099 | −1,807 (−20.3%) |
| 종료 직후 Dirty Page | 285 | 2,087 | +1,802 |
| 종료 직후 Checkpoint Age | 40.33MB | 81.30MB | +40.97MB |
Redo 기록량이 두 실험에서 똑같이 111.94MB라는 점부터 확인할 수 있습니다. 같은 행 수, 같은 데이터 길이의 변경이었다는 뜻입니다. 행당 약 1.15KB의 Redo가 생겼습니다. 512바이트 값을 바꿨는데 그 두 배 이상이 기록된 이유는, Redo에 데이터 변경뿐 아니라 언두 로그 기록과 페이지 메타데이터 변경도 함께 들어가기 때문입니다.
줄어든 플러시 1,807페이지는 어디로 갔을까
256MB에서 플러시가 1,807페이지 줄었습니다. 그리고 종료 직후 Dirty Page는 1,802페이지 더 많았습니다. 두 숫자가 다섯 페이지 차이로 거의 같습니다.
즉 256MB에서는 디스크에 쓰지 않은 만큼이 거의 그대로 메모리에 Dirty Page로 남아 있었습니다. Redo 여유 공간이 늘어난 효과는 쓰기를 없앤 것이 아니라, UPDATE가 끝날 때까지 미뤄 둔 것이었습니다. 이 페이지들은 뒤에서 볼 것처럼 10초 안에 모두 디스크에 써졌습니다.
같은 페이지가 반복해서 바뀌는 작업이었다면, 미뤄 둔 덕분에 여러 번의 쓰기를 한 번으로 합칠 수 있었을 것입니다. 하지만 이번 UPDATE는 id 순서대로 각 행을 한 번씩만 바꿨기 때문에, 미뤄도 합칠 쓰기가 많지 않았던 것으로 보입니다.
버퍼 풀 비율로 보면 차이가 더 분명합니다. 128MB 버퍼 풀은 8,192페이지입니다.
- 100MB: Dirty Page 285 → 버퍼 풀의 3.5%
- 256MB: Dirty Page 2,087 → 버퍼 풀의 25.5%
256MB에서는 버퍼 풀의 4분의 1이 Dirty Page로 차 있었습니다. 작은 버퍼 풀에서 Dirty Page가 많으면 새 페이지를 읽어 올 빈 공간을 만들기 위해 플러시를 기다리는 일이 생길 수 있습니다. 256MB가 333ms 느렸던 원인 후보 중 하나입니다.
다만 각 설정을 한 번씩만 실행했기 때문에, 333ms 차이가 이 원인 때문인지 노트북의 다른 작업 때문인지는 이 실험만으로 가릴 수 없습니다. 분명하게 말할 수 있는 것은 “Redo를 늘렸더니 UPDATE가 빨라졌다”는 결과는 나오지 않았다는 점입니다.
100MB 로그에 111.94MB를 기록할 수 있는 이유
Redo 용량 100MB보다 기록량 111.94MB가 크지만 오류가 아닙니다. Redo Log는 원형 버퍼처럼 동작해서, Checkpoint가 앞으로 이동한 만큼 오래된 영역을 다시 씁니다.
용량이 정하는 것은 기록 총량이 아니라 Checkpoint Age의 상한입니다. 100MB 실험에서 UPDATE 중 Checkpoint가 계속 따라오며 공간을 비워 주었기 때문에 111.94MB를 쓸 수 있었습니다. 이렇게 Checkpoint가 계속 따라오도록 만든 것이 바로 8,906페이지의 플러시입니다.
UPDATE가 끝난 뒤 10초
UPDATE 직후(after)와 약 10초 뒤(idle)의 스냅숏을 비교했습니다.
sql
SELECT
    phase,
    captured_at,
    current_lsn,
    checkpoint_lsn,
    ROUND((current_lsn - checkpoint_lsn) / 1024 / 1024, 2) AS checkpoint_age_mb,
    dirty_pages
FROM redo_lab_snapshots
WHERE phase IN ('100_after', '100_idle', '256_after', '256_idle')
ORDER BY phase;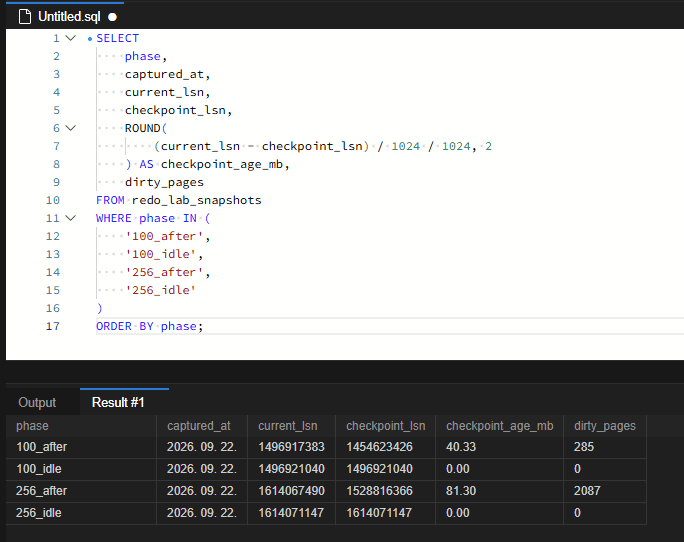
| 시점 | Current LSN | Checkpoint LSN | Checkpoint Age | Dirty Page |
|---|---|---|---|---|
| 100MB 직후 | 1,496,917,383 | 1,454,623,426 | 40.33MB | 285 |
| 100MB 10초 후 | 1,496,921,040 | 1,496,921,040 | 0.00MB | 0 |
| 256MB 직후 | 1,614,067,490 | 1,528,816,366 | 81.30MB | 2,087 |
| 256MB 10초 후 | 1,614,071,147 | 1,614,071,147 | 0.00MB | 0 |
두 설정 모두 10초 안에 Dirty Page가 0이 되었고, Checkpoint LSN이 Current LSN을 따라잡았습니다. 256MB에서 미뤄졌던 2,087페이지도 이 사이에 모두 디스크에 써졌습니다. UPDATE 시간에 잡히지 않았을 뿐, 쓰기 작업 자체는 결국 일어났습니다.
idle 시점의 Current LSN은 after보다 3,657바이트 앞서 있습니다(두 실험 모두 같은 값). 사용자 쿼리가 없어도 InnoDB 내부 작업이 소량의 Redo를 남긴다는 뜻입니다.
Checkpoint Age는 두 LSN 사이의 거리일 뿐, Dirty Page의 용량이나 미완료 트랜잭션의 크기를 뜻하지 않습니다. 또 이 값들은 특정 시점의 스냅숏입니다. UPDATE 도중의 최대 Checkpoint Age는 측정하지 않았습니다.
용량 대비 비율로 보면 달라지는 것
Checkpoint Age를 절대값이 아닌 Redo 용량 대비 비율로 바꿔 보면 결과가 다르게 보입니다.
| Checkpoint Age | Redo 용량 | 비율 | |
|---|---|---|---|
| 100MB | 40.33MB | 100MB | 40.3% |
| 256MB | 81.30MB | 256MB | 31.8% |
256MB에서 Checkpoint Age는 두 배로 커졌지만, 용량 대비 비율은 오히려 낮습니다. InnoDB의 Adaptive Flushing은 innodb_adaptive_flushing_lwm(기본 10%)을 넘으면 Redo 생성 속도에 맞춰 플러시를 강화합니다. 두 실험 모두 이 기준을 넘었으므로 Adaptive Flushing은 양쪽에서 모두 작동했습니다. 256MB 쪽이 상한까지 여유가 더 있어서 덜 서둘렀다고 해석할 수 있습니다.
운영 서버에서도 Checkpoint Age는 MB 숫자보다 이 비율로 보는 것이 판단하기 쉽습니다. 다음 쿼리로 현재 값을 확인할 수 있습니다.
sql
SELECT
    ROUND((cur.v - chk.v) / 1024 / 1024, 2) AS checkpoint_age_mb,
    ROUND(@@GLOBAL.innodb_redo_log_capacity / 1024 / 1024) AS redo_capacity_mb,
    ROUND((cur.v - chk.v) / @@GLOBAL.innodb_redo_log_capacity * 100, 1) AS age_pct
FROM
    (SELECT CAST(VARIABLE_VALUE AS UNSIGNED) AS v
       FROM performance_schema.global_status
      WHERE VARIABLE_NAME = 'Innodb_redo_log_current_lsn') AS cur,
    (SELECT CAST(VARIABLE_VALUE AS UNSIGNED) AS v
       FROM performance_schema.global_status
      WHERE VARIABLE_NAME = 'Innodb_redo_log_checkpoint_lsn') AS chk;
업무 부하가 이어지는 서버에서 Checkpoint Age가 0일 필요는 없습니다. 판단 기준은 다음과 같습니다.
- 일정한 비율에서 안정적으로 머무르면 정상입니다.
- 피크 시간마다 비율이 높게 치솟고 그때 쓰기 지연이 함께 늘어난다면, Redo 용량이 그 부하를 감당하기에 작다는 신호입니다.
이번 실험 같은 단발성 측정이 아니라, 이 비율의 추이가 Redo 용량을 늘릴지 판단하는 근거가 됩니다.
100MB로 되돌리기
실험이 끝난 뒤 원래 값으로 복구했습니다.
sql
SET GLOBAL innodb_redo_log_capacity = 104857600;같은 상태 조회 쿼리로 확인했습니다.
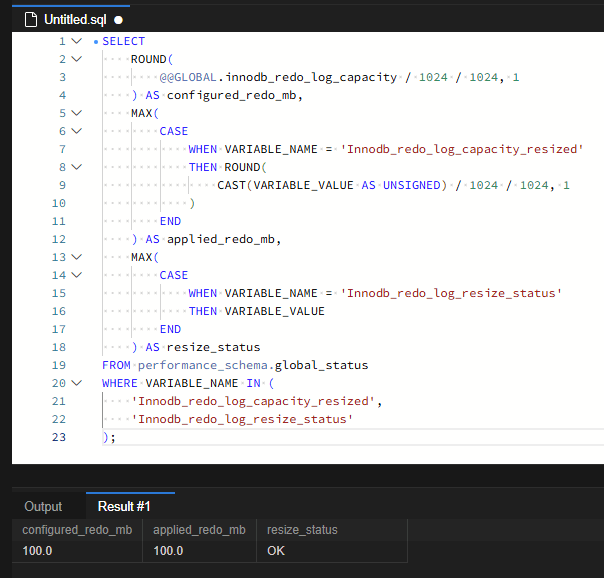
설정값과 실제 적용값이 모두 100MB, 상태는 OK입니다. 이번에는 직전 실험의 Dirty Page가 이미 모두 플러시되어 Checkpoint Age가 0이었기 때문에, 축소가 기다림 없이 끝났습니다.
운영 중 부하가 있는 상태에서 줄이면 상황이 다릅니다. 현재 Checkpoint Age가 새 용량보다 크면, InnoDB는 그만큼을 플러시해 Checkpoint를 앞당긴 뒤에야 축소를 마칩니다. 결국 축소 자체가 쓰기 부하를 만듭니다. 동적으로 바꿀 수 있다고 해서 아무 때나 줄여도 되는 것은 아니며, 한가한 시간에 위의 비율 쿼리로 Checkpoint Age를 확인한 뒤 진행하는 것이 안전합니다.
이번 실험에서는 Redo 용량 외의 서버 설정은 바꾸지 않았고, SET PERSIST도 사용하지 않았습니다.
이 결과를 운영 판단에 쓰려면
이번 실험에서 확인된 것은 세 가지입니다.
- Redo 용량은 재시작 없이 늘리고 줄일 수 있었습니다.
- 용량을 늘리자 UPDATE 중의 플러시가 줄었습니다.
- 줄어든 만큼이 Dirty Page로 남았다가 UPDATE 후에 써졌습니다.
반면 UPDATE 시간은 줄지 않았습니다.
그래서 Redo 확대가 효과를 보는 경우는 이렇게 정리할 수 있습니다.
- 효과가 있을 수 있는 경우: 쓰기가 짧은 시간에 몰렸다가 잦아드는 부하에서, 피크 동안 Checkpoint 압박으로 쓰기가 지연될 때입니다. 미룬 쓰기를 한가한 시간에 처리할 수 있으면 피크 구간이 부드러워집니다. 같은 페이지를 반복해서 바꾸는 작업이라면 쓰기 자체도 줄어듭니다.
- 효과가 없는 경우: 쓰기 부하가 계속 이어져 스토리지가 감당할 수 있는 지속 처리량을 넘을 때입니다. 미룬 쓰기를 처리할 한가한 시간이 오지 않으므로, Redo를 늘려도 Dirty Page와 Checkpoint Age가 상한까지 차오르는 시점만 늦춰질 뿐입니다.
또한 Redo가 클수록 장애가 났을 때 다시 적용해야 할 Redo 범위가 길어져 복구 시간이 늘어날 수 있습니다. 디스크 공간도 그만큼 필요합니다.
이번 측정은 각 설정에서 한 번씩만 실행했습니다. 333ms의 시간 차이가 의미 있는지 판단하려면 다음이 필요합니다.
- 100MB와 256MB의 실행 순서를 번갈아 바꿔 가며 여러 번 측정합니다.
- 중앙값으로 비교합니다.
- 버퍼 풀을 실제 운영과 비슷한 크기로 맞춥니다.

댓글 0
첫 댓글을 남겨보세요.