MySQL 날짜 컬럼에 DATE 함수를 쓰면 느려지는 이유: 인덱스 전체 스캔을 범위 스캔으로 바꾼 실험
특정 날짜의 주문 건수를 세는 SQL에는 WHERE DATE(created_at) = '2026-02-15' 같은 조건이 자주 쓰입니다. 날짜 컬럼에는 인덱스가 있고 실행계획에도 그 인덱스 이름이 보이므로 문제가 없어 보입니다. 하지만 실제로 읽은 행 수를 확인하면 결과가 달라집니다.
MySQL 8.4.11에서 100만 건을 만들고 같은 날짜를 두 가지 조건으로 조회했습니다. DATE 함수 조건은 날짜 인덱스 100만 행을 모두 읽었고 551ms가 걸렸습니다. 컬럼을 가공하지 않은 범위 조건은 같은 인덱스에서 1만 행만 읽었고 4.15ms에 끝났습니다. 두 조건이 반환한 건수는 모두 10,000건이었습니다.
이 글에서는 EXPLAIN ANALYZE 출력을 노드 단위로 읽으면서 두 실행계획의 차이가 어디서 생기는지 확인합니다. 이어서 조건을 바꾼 뒤 결과가 같은지 검증하는 쿼리, BETWEEN과 23:59:59 종료값의 함정, 애플리케이션에서 날짜 범위를 만드는 방법을 다룹니다.
문제의 SQL: 결과는 숫자 하나지만 처리량은 다릅니다
일별 주문 건수나 접속 이력 집계처럼, 날짜와 시간이 함께 저장된 컬럼에서 특정 날짜의 건수만 세는 SQL입니다.
SELECT COUNT(*) AS matched_rows
FROM date_filter_events
WHERE DATE(created_at) = '2026-02-15';
조회 대상은 하루이고 결과는 한 행입니다. 그러나 결과가 작다고 해서 데이터베이스가 적게 읽는 것은 아닙니다. 이 차이를 수치로 확인하기 위해 별도 스키마에 테스트 데이터를 구성했습니다.
테스트 환경과 재현 데이터
환경 구성
| 항목 | 실제 확인한 값 |
|---|---|
| 실행 환경 | Windows 로컬 MySQL, Workbench |
| MySQL 버전 | 8.4.11 |
| 스키마 / 테이블 | dba_date_filter_lab / date_filter_events |
| 데이터 건수 | 1,000,000건 (100일 × 하루 10,000건) |
| 날짜 범위 | 2026-01-01 00:00:00.000000 ~ 2026-04-10 23:59:59.999999 |
| 날짜 자료형 | DATETIME(6), NOT NULL |
| 인덱스 | PRIMARY(id), idx_created_at(created_at) |
| 버퍼 풀 | 128MiB |
| 격리 수준 | REPEATABLE-READ |
| 조회 대상 | 2026-02-15의 10,000건 (전체의 1%) |
| 비교 도구 | EXPLAIN ANALYZE |
환경 값은 다음 쿼리 하나로 확인했습니다. 버전, 버퍼 풀, 격리 수준, 데이터 범위, 컬럼 자료형, 인덱스 구성을 한 화면에서 확인할 수 있어 다른 환경에서 재현할 때도 그대로 사용할 수 있습니다.
SELECT 'mysql_version' AS item, VERSION() AS value

UNION ALL

SELECT
    'buffer_pool_MiB',
    CAST(
        ROUND(@@innodb_buffer_pool_size / 1024 / 1024, 1)
        AS CHAR
    )

UNION ALL

SELECT 'isolation', @@transaction_isolation

UNION ALL

SELECT 'row_count', CAST(COUNT(*) AS CHAR)
FROM date_filter_events

UNION ALL

SELECT
    'datetime_range',
    CONCAT(MIN(created_at), ' ~ ', MAX(created_at))
FROM date_filter_events

UNION ALL

SELECT 'created_at_type', COLUMN_TYPE
FROM information_schema.COLUMNS
WHERE TABLE_SCHEMA = 'dba_date_filter_lab'
  AND TABLE_NAME = 'date_filter_events'
  AND COLUMN_NAME = 'created_at'

UNION ALL

SELECT
    'index_definition',
    GROUP_CONCAT(
        CONCAT(INDEX_NAME, '(', COLUMN_NAME, ')')
        ORDER BY INDEX_NAME, SEQ_IN_INDEX
        SEPARATOR ', '
    )
FROM information_schema.STATISTICS
WHERE TABLE_SCHEMA = 'dba_date_filter_lab'
  AND TABLE_NAME = 'date_filter_events';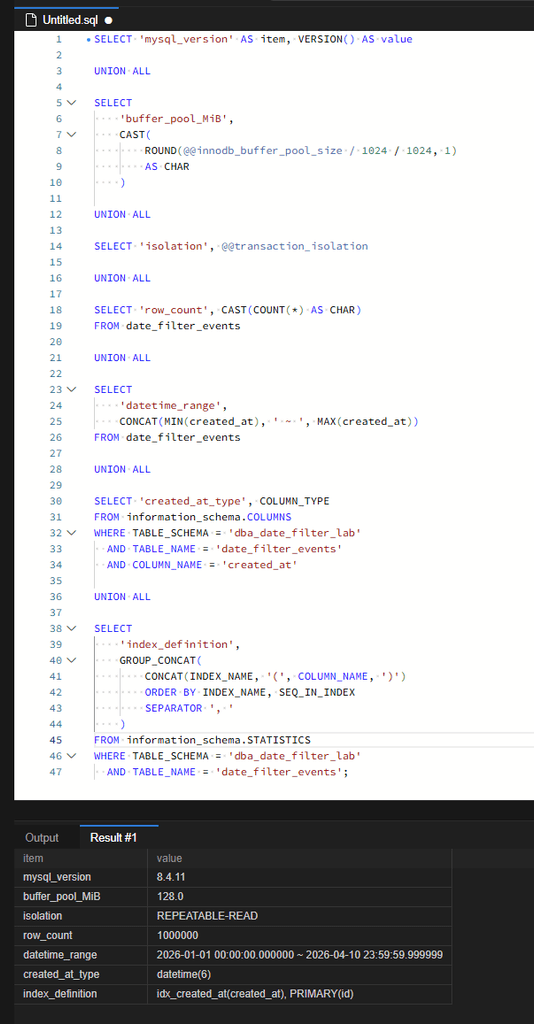
재현용 테이블과 데이터 생성 SQL
다음 SQL은 별도 테스트 스키마에서 한 번 실행합니다. 같은 이름의 스키마나 테이블이 이미 있다면 충돌 여부를 먼저 확인합니다.
CREATE DATABASE IF NOT EXISTS dba_date_filter_lab;
USE dba_date_filter_lab;

CREATE TABLE date_filter_events (
    id BIGINT UNSIGNED NOT NULL,
    created_at DATETIME(6) NOT NULL,
    payload VARCHAR(200) NOT NULL,
    PRIMARY KEY (id),
    KEY idx_created_at (created_at)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

INSERT INTO date_filter_events (id, created_at, payload)
WITH digits AS (
    SELECT 0 AS d UNION ALL SELECT 1 UNION ALL SELECT 2
    UNION ALL SELECT 3 UNION ALL SELECT 4 UNION ALL SELECT 5
    UNION ALL SELECT 6 UNION ALL SELECT 7 UNION ALL SELECT 8
    UNION ALL SELECT 9
),
numbers AS (
    SELECT a.d + b.d * 10 + c.d * 100
         + d.d * 1000 + e.d * 10000 + f.d * 100000 AS n
    FROM digits a
    CROSS JOIN digits b
    CROSS JOIN digits c
    CROSS JOIN digits d
    CROSS JOIN digits e
    CROSS JOIN digits f
)
SELECT
    n + 1,
    TIMESTAMPADD(
        MICROSECOND,
        CASE
            WHEN MOD(n, 10000) = 9999 THEN 86399999999
            ELSE MOD(n, 10000) * 8640000
        END,
        TIMESTAMPADD(
            DAY, n DIV 10000, '2026-01-01 00:00:00.000000'
        )
    ),
    REPEAT('x', 100)
FROM numbers
ORDER BY n;

COMMIT;
ANALYZE TABLE date_filter_events;
데이터는 다음 규칙으로 만들어집니다. 이 규칙을 알아 두면 뒤에서 경계 행을 검증할 때 어떤 ID를 봐야 하는지 바로 알 수 있습니다.
- 0~9 숫자 집합 여섯 개를 교차 결합해 0부터 999,999까지 100만 개의 번호 n을 만듭니다.
n DIV 10000으로 날짜를 정하므로 하루에 정확히 10,000건씩 100일치가 생성됩니다.- 하루 안에서는 8.64초 간격으로 시각을 배치하되, 하루의 마지막 행만
23:59:59.999999로 지정했습니다. 따라서 매일 첫 행은 자정 정각, 마지막 행은 자정 직전 마이크로초에 위치합니다. - id는 n + 1이므로 2026-02-15 데이터는 ID 450,001부터 460,000까지입니다.
- payload는 100바이트 문자열이므로 테이블 행은 날짜 인덱스 항목보다 큽니다.
측정값을 해석하는 기준
본문의 시간은 각 쿼리를 EXPLAIN ANALYZE로 실행했을 때 기록된 1회 관측값입니다. 반복 측정 평균이 아니고 예열과 캐시 상태도 통제하지 않았으므로, 비교의 중심은 시간보다 읽은 행 수와 접근 방식에 둡니다. 또한 EXPLAIN ANALYZE의 시간에는 노드별 계측 비용이 포함되어 애플리케이션이 체감하는 응답 시간과 같지 않습니다.
직접 재현할 때는 데이터 입력이 끝나고 다른 변경 작업이 없는 상태에서 측정합니다. 시간까지 비교하려면 두 쿼리를 한 번씩 예열한 뒤 번갈아 세 차례 이상 실행하고 중앙값을 비교하는 것이 좋습니다.
DATE() 조건: 날짜 인덱스를 처음부터 끝까지 읽었습니다
먼저 함수 조건의 실제 실행계획을 확인했습니다.
EXPLAIN ANALYZE
SELECT COUNT(*) AS matched_rows
FROM date_filter_events
WHERE DATE(created_at) = '2026-02-15';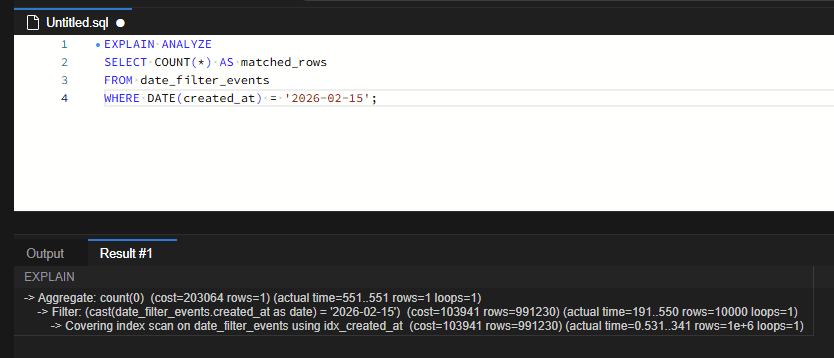
EXPLAIN ANALYZE는 안쪽 노드부터 읽습니다
트리 형태의 출력에서는 들여쓰기가 가장 깊은 노드가 먼저 실행되어 바로 위 노드로 행을 넘깁니다. 각 노드의 괄호에는 두 묶음의 값이 있습니다. 앞쪽의 cost와 rows는 실행 전 옵티마이저의 추정치이고, 뒤쪽의 actual time, rows, loops는 실제 실행 결과입니다.
actual time의 두 값은 첫 행을 넘긴 시점과 마지막 행을 넘긴 시점(ms)입니다. 실제 rows는 반복 1회당 평균 행 수이며, 이번 쿼리는 모든 노드가 loops=1이므로 그대로 전체 행 수로 읽으면 됩니다. 캡처의 값을 실행 순서대로 정리하면 다음과 같습니다.
| 실행 순서 | 노드 | 추정 rows | 실제 rows | actual time(ms) |
|---|---|---|---|---|
| 1 | Covering index scan (idx_created_at) | 991,230 | 1,000,000 | 0.531..341 |
| 2 | Filter: cast(created_at as date) = '2026-02-15' | 991,230 | 10,000 | 191..550 |
| 3 | Aggregate: count(0) | 1 | 1 | 551..551 |
스캔 노드의 rows=1e+6은 1,000,000행을 뜻합니다. 스캔 노드는 인덱스 항목 100만 개를 모두 Filter로 넘겼고, Filter는 그중 99만 행을 버리고 1만 행만 Aggregate에 전달했습니다. 최종 결과에 필요한 행의 100배를 읽은 셈입니다.
Filter가 첫 행을 넘긴 시점이 191ms라는 점도 이 흐름과 맞습니다. 인덱스는 created_at 순서로 정렬되어 있고 2월 15일은 46번째 날이므로, 앞선 45일치 45만 행을 읽고 버린 뒤에야 첫 일치 행이 나온 것으로 해석할 수 있습니다.
최상단 Aggregate의 rows=1은 조건에 맞는 데이터가 한 건이라는 뜻이 아닙니다. COUNT(*)의 집계 결과가 한 행이라는 뜻입니다.
추정치에서도 차이가 드러납니다. 옵티마이저는 Filter 노드의 출력도 입력과 같은 991,230행으로 추정했습니다. 함수 조건이 행을 얼마나 걸러낼지 추정에 반영하지 못한 것이고, 실제 결과인 1만 행과는 약 99배 차이가 납니다. 실행계획의 필터에 DATE 대신 cast(created_at as date)가 표시된 것은 이 SQL의 날짜 추출 조건을 내부적으로 표현한 것이며, 별도의 암묵적 형변환 문제가 생긴 것은 아닙니다.
커버링 인덱스라고 필요한 범위만 읽는 것은 아닙니다
Covering index scan은 테이블 행을 찾아가지 않고 인덱스만으로 쿼리를 처리했다는 뜻입니다. InnoDB의 보조 인덱스 항목에는 인덱스 컬럼 값과 기본 키가 저장되므로, idx_created_at 항목에는 created_at과 id만 있습니다. 날짜 조건 평가와 COUNT(*)에는 이것으로 충분하므로 100바이트 payload가 들어 있는 테이블 행을 읽을 필요가 없습니다.
그래서 옵티마이저는 테이블 전체보다 크기가 작은 날짜 인덱스 전체를 읽는 계획을 고른 것으로 볼 수 있습니다. 하지만 인덱스만 읽었다는 것과 필요한 범위만 읽었다는 것은 서로 다른 이야기이며, 이번 계획은 앞의 경우에만 해당합니다. 실행계획에서 인덱스 이름을 찾았다면 그 앞의 표현이 index scan인지 index range scan인지까지 확인해야 하는 이유입니다.
범위 스캔이 되지 않은 이유는 조건의 형태에 있습니다. 인덱스는 날짜와 시간이 포함된 created_at 원래 값의 순서로 정렬되어 있는데, DATE(created_at)는 그 값을 가공한 결과를 비교합니다. 이번 환경의 MySQL은 이 조건을 원본 컬럼의 시작·종료 범위로 자동 변환하지 않았고, 인덱스를 처음부터 읽으면서 행마다 함수 결과를 평가했습니다.
반개방 범위 조건: 같은 인덱스에서 1만 행만 읽었습니다
인덱스는 그대로 두고 WHERE 조건만 바꿨습니다.
EXPLAIN ANALYZE
SELECT COUNT(*) AS matched_rows
FROM date_filter_events
WHERE created_at >= '2026-02-15 00:00:00'
  AND created_at <  '2026-02-16 00:00:00';
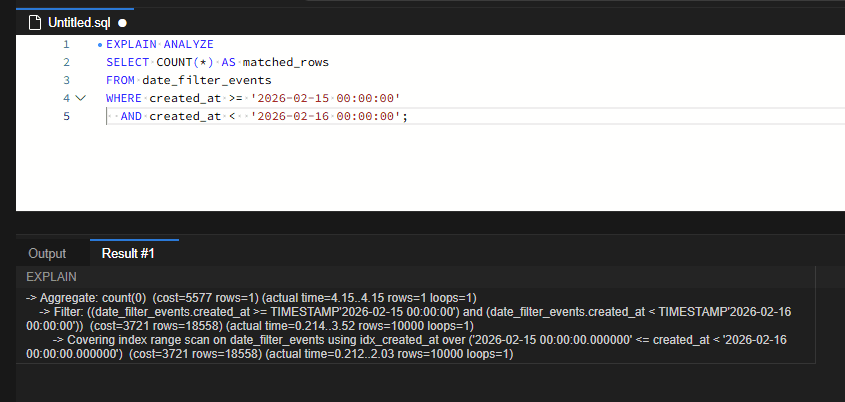
시작 시각은 포함하고 다음 날 시작 시각은 제외하는 반개방 구간입니다. 가공하지 않은 원본 컬럼을 상수와 비교하므로, 옵티마이저는 B-tree 인덱스에서 시작 지점을 찾아 종료 지점까지만 읽는 범위 접근을 사용할 수 있습니다.
| 실행 순서 | 노드 | 추정 rows | 실제 rows | actual time(ms) |
|---|---|---|---|---|
| 1 | Covering index range scan (idx_created_at) | 18,558 | 10,000 | 0.212..2.03 |
| 2 | Filter: 시작·종료 시각 비교 | 18,558 | 10,000 | 0.214..3.52 |
| 3 | Aggregate: count(0) | 1 | 1 | 4.15..4.15 |
스캔 노드에는 over ('2026-02-15 00:00:00.000000' <= created_at < '2026-02-16 00:00:00.000000')처럼 읽을 범위가 명시되어 있습니다. 조건의 문자열 상수가 DATETIME(6) 정밀도의 경계값으로 바뀌어 인덱스 탐색 범위로 사용되었다는 뜻입니다. 첫 행이 0.212ms에 나온 것도 앞쪽 45만 행을 건너뛰고 대상 구간부터 읽었기 때문입니다.
추정 행 수는 18,558행으로 실제의 약 1.9배였습니다. 그래도 함수 조건에서 생긴 99배 차이에 비하면 실제 값에 훨씬 가깝습니다. 범위 조건에서는 옵티마이저가 인덱스의 해당 구간을 근거로 행 수를 추정할 수 있기 때문입니다.
범위 조건의 실행계획에도 Filter 노드는 남아 있습니다. 하지만 Filter의 입력과 출력이 모두 1만 행이므로 이 단계에서 버려진 행은 없습니다. Filter 노드가 보인다는 사실만으로 최적화에 실패했다고 판단하지 않고, 하위 스캔이 이미 대상을 얼마나 좁혔는지를 봐야 합니다.
수정 전후 수치 비교
| 비교 항목 | DATE() 조건 | 반개방 범위 조건 |
|---|---|---|
| 사용 인덱스 | idx_created_at | idx_created_at |
| 접근 방식 | 커버링 인덱스 전체 스캔 | 커버링 인덱스 범위 스캔 |
| 스캔 노드 실제 행 수 | 1,000,000 | 10,000 |
| 스캔 노드 추정 행 수 | 991,230 | 18,558 |
| 조건 일치 건수 | 10,000 | 10,000 |
| 최상단 추정 cost | 203,064 | 5,577 |
| 최상단 완료 시간(1회 관측) | 551ms | 4.15ms |
읽은 행 수는 100분의 1로 줄었습니다. 같은 결과를 얻는 데 필요 없던 99만 행을 읽지 않게 된 것이 이번 개선의 실체입니다. 시간은 1회 관측 기준으로 약 133배 차이지만, 장비와 캐시 상태에 따라 달라지는 값이므로 다른 환경에 그대로 적용할 수치로 보지 않습니다.
추정 cost는 약 36분의 1로 줄었습니다. cost는 옵티마이저가 실행계획끼리 비교하기 위한 상대 단위이며 ms가 아니므로, 시간 비율과 일치하지 않는 것이 정상입니다. 노드별 시간도 합산하지 않습니다. 상위 노드의 시간에는 하위 노드의 작업이 이미 포함되어 있으며, 실제 rows는 노드 사이에 전달된 행 수이지 디스크 읽기 횟수가 아닙니다.
조건을 바꾼 뒤에는 결과가 같은지부터 확인합니다
성능이 좋아져도 결과가 한 건이라도 달라지면 장애입니다. 건수만 비교하면 서로 다른 행이 우연히 같은 개수로 선택된 경우를 걸러낼 수 없으므로, 행마다 두 조건의 판정이 같은지 비교했습니다.
SELECT
    COUNT(*) AS total_rows,

    SUM(
        DATE(created_at) = '2026-02-15'
    ) AS date_match_rows,

    SUM(
        created_at >= '2026-02-15 00:00:00'
        AND created_at < '2026-02-16 00:00:00'
    ) AS range_match_rows,

    SUM(
        (DATE(created_at) = '2026-02-15')
        <>
        (
            created_at >= '2026-02-15 00:00:00'
            AND created_at < '2026-02-16 00:00:00'
        )
    ) AS mismatch_rows

FROM date_filter_events;
MySQL에서 비교식은 참이면 1, 거짓이면 0을 반환하므로 SUM으로 일치하는 행 수를 셀 수 있습니다. mismatch_rows는 두 조건의 판정이 서로 다른 행의 수입니다.
| 전체 건수 | DATE 조건 일치 | 범위 조건 일치 | 판정 불일치 |
|---|---|---|---|
| 1,000,000 | 10,000 | 10,000 | 0 |
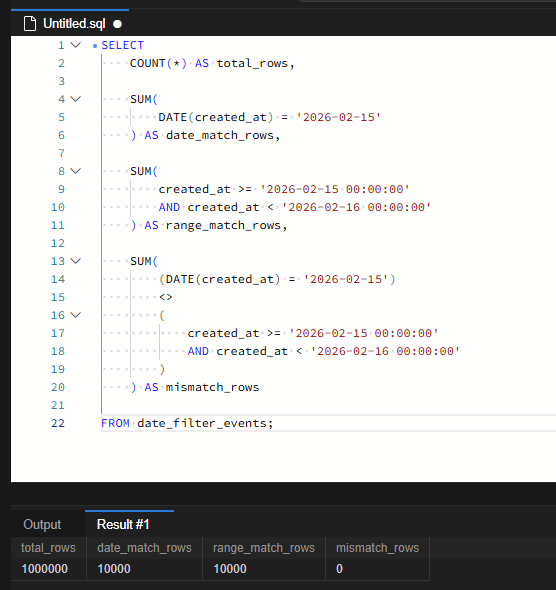
이번 created_at은 NOT NULL 컬럼입니다. NULL을 허용하는 컬럼에서는 한쪽 판정이 NULL이 되면 <> 비교 결과도 NULL이 되어 SUM에서 빠지므로, 실제 불일치를 놓칠 수 있습니다. 이런 경우에는 WHERE 절에서 NULL이 제외되는 동작에 맞춰 NULL을 0으로 바꾼 뒤 비교합니다.
SUM(
    IFNULL(DATE(created_at) = '2026-02-15', 0)
    <>
    IFNULL(
        created_at >= '2026-02-15 00:00:00'
        AND created_at < '2026-02-16 00:00:00',
        0
    )
) AS mismatch_rows
이 검증 쿼리는 테이블 전체를 읽으므로 성능 측정용으로 쓰지 않습니다. 운영 데이터에서 실행할 때는 부하가 적은 시간대를 고르거나 복제본에서 실행하는 것이 안전합니다.
날짜 끝을 지정하는 방식에 따라 결과가 달라집니다
함수 조건을 범위 조건으로 바꿀 때 가장 흔한 실수는 종료값입니다. 다음 BETWEEN 조건은 앞의 반개방 범위와 같아 보이지만 결과가 다릅니다.
created_at BETWEEN '2026-02-15 00:00:00'
               AND '2026-02-16 00:00:00'
BETWEEN은 양 끝을 모두 포함하므로 다음 날 자정 정각의 행까지 조회합니다. 앞의 데이터 생성 규칙에 따라 날짜 경계에 있는 ID 네 개를 골라 세 조건의 판정을 비교했습니다. 450000은 2월 14일의 마지막 행, 450001은 2월 15일의 첫 행, 460000은 2월 15일의 마지막 행, 460001은 2월 16일의 첫 행입니다.
SELECT
    id,
    created_at,

    DATE(created_at) = '2026-02-15'
        AS date_match,

    (
        created_at >= '2026-02-15 00:00:00'
        AND created_at < '2026-02-16 00:00:00'
    ) AS range_match,

    (
        created_at BETWEEN '2026-02-15 00:00:00'
                       AND '2026-02-16 00:00:00'
    ) AS between_match

FROM date_filter_events
WHERE id IN (450000, 450001, 460000, 460001)
ORDER BY id;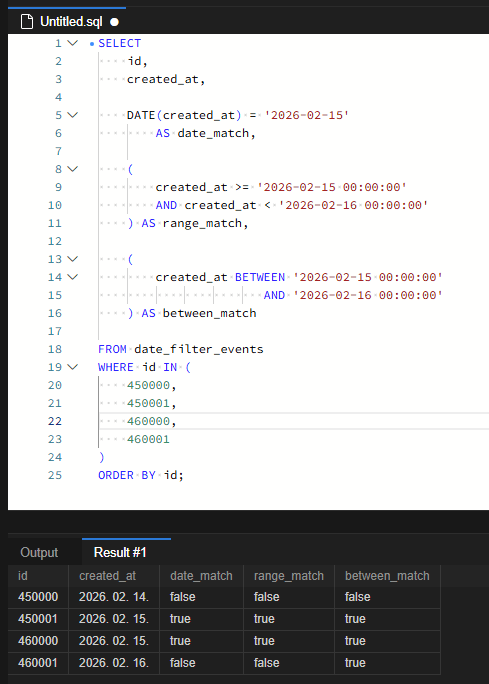
캡처 화면의 created_at은 날짜까지만 표시되어 있습니다. 다음 표의 상세 시각은 데이터 생성 규칙에 따른 값이며, 참·거짓 결과는 캡처에서 확인한 값입니다.
| ID | 데이터 생성 시각 | DATE 조건 | 반개방 범위 | BETWEEN |
|---|---|---|---|---|
| 450000 | 2026-02-14 23:59:59.999999 | false | false | false |
| 450001 | 2026-02-15 00:00:00.000000 | true | true | true |
| 460000 | 2026-02-15 23:59:59.999999 | true | true | true |
| 460001 | 2026-02-16 00:00:00.000000 | false | false | true |
이번 데이터에서는 한 건 차이지만, 자정 정각에 기록되는 행이 많은 서비스라면 차이도 그만큼 커집니다. 일별 집계에 BETWEEN을 쓰면 자정 행이 이틀에 중복 집계될 수 있다는 점도 함께 기억해야 합니다.
종료값을 23:59:59로 고정하는 방식도 주의가 필요합니다. DATETIME(6)에는 23:59:59.999999 같은 값이 존재하므로 다음 조건은 마지막 1초 안의 행을 놓칠 수 있습니다.
created_at <= '2026-02-15 23:59:59'데이터 생성 규칙상 이번 테이블에서는 ID 460000이 이 조건에서 빠지는 행입니다. 이 조건은 별도로 캡처하지 않았지만, 매일 마지막 1초 안의 행만 빠지는 형태라 건수 차이가 작아 발견이 늦어지기 쉽습니다. 네 가지 방식을 정리하면 다음과 같습니다.
| 조건 형태 | 이번 실험의 접근 방식 | 2026-02-15 결과 |
|---|---|---|
DATE(created_at) = '2026-02-15' | 인덱스 전체 스캔 확인 | 정확 (검증) |
BETWEEN 당일 자정 AND 다음 날 자정 | 측정하지 않음 | 다음 날 자정 행 포함 (확인) |
<= '2026-02-15 23:59:59' | 측정하지 않음 | 23:59:59.999999 행 누락 (데이터 규칙상) |
>= 당일 자정 AND < 다음 날 자정 | 인덱스 범위 스캔 확인 | 정확 (검증) |
애플리케이션에서 날짜 범위를 만드는 방법
화면에서 날짜 하나를 입력받는 경우, 애플리케이션이 시작 시각과 다음 날 시작 시각 두 값을 계산해 바인딩하는 방식이 가장 명확합니다. SQL 쪽은 컬럼을 가공하지 않는 형태로 고정됩니다.
SELECT COUNT(*) AS matched_rows
FROM date_filter_events
WHERE created_at >= ?
  AND created_at <  ?;

-- 바인딩 값 예: '2026-02-15 00:00:00', '2026-02-16 00:00:00'
날짜 값 하나만 넘겨야 한다면 다음 날 시각을 SQL 안에서 계산할 수도 있습니다. 우변은 컬럼과 무관한 상수 계산이므로 원본 컬럼 비교 형태가 유지됩니다. 다만 이 형태는 이번 실험에서 실행계획을 캡처하지 않았으므로, 적용 전에 EXPLAIN으로 range scan이 나오는지 확인합니다.
WHERE created_at >= DATE '2026-02-15'
  AND created_at <  DATE '2026-02-15' + INTERVAL 1 DAY
월 단위 조회에서 자주 쓰는 YEAR(created_at) = 2026 AND MONTH(created_at) = 2도 컬럼을 가공한다는 점에서 같은 구조입니다. 이 경우에도 다음 달 1일 미만의 반개방 범위로 바꿀 수 있는지 먼저 검토합니다.
WHERE created_at >= '2026-02-01 00:00:00'
  AND created_at <  '2026-03-01 00:00:00'
일별 건수를 한 번에 구할 때는 날짜 함수를 아예 쓰지 말아야 하는 것이 아닙니다. 읽을 범위는 WHERE 절에서 정해지므로, WHERE는 범위 조건으로 두고 그룹 기준에만 DATE를 사용하면 됩니다.
SELECT DATE(created_at) AS event_date,
       COUNT(*)         AS event_count
FROM date_filter_events
WHERE created_at >= '2026-02-01 00:00:00'
  AND created_at <  '2026-03-01 00:00:00'
GROUP BY DATE(created_at)
ORDER BY event_date;
이 집계 쿼리도 이번 실험에서는 측정하지 않았습니다. 그룹화 과정에서 임시 테이블 같은 별도 비용이 생길 수 있으므로 실제 데이터에서 실행계획을 함께 확인합니다.
범위 조건으로 바꿔도 효과가 작아지는 경우
조회 기간이 넓을 때
이번에는 전체의 1%인 하루치 10,000건을 조회했기 때문에 차이가 컸습니다. 조회 기간이 넓어져 대부분의 행이 범위 안에 들어오면 범위 스캔도 인덱스 대부분을 읽게 되므로, 스캔 행 수가 줄어드는 효과도 작아집니다.
인덱스에 없는 컬럼을 함께 조회할 때
이번 실험은 COUNT(*)만 사용해 인덱스만으로 처리할 수 있었습니다. 실제 서비스 쿼리가 payload처럼 인덱스에 없는 컬럼을 조회하면 행마다 테이블 데이터를 찾아가는 비용이 추가되고, 조회 범위가 넓으면 옵티마이저가 다른 계획을 선택할 수도 있습니다. 운영 SQL은 실제 SELECT 목록과 조인·정렬 조건을 포함한 상태로 다시 확인해야 합니다.
SQL을 수정할 수 없을 때: 함수 기반 인덱스
MySQL은 8.0.13부터 표현식을 인덱싱하는 함수 기반 인덱스를 지원하며, 8.4에서도 사용할 수 있습니다. 따라서 함수 조건이면 항상 전체 스캔이라는 규칙으로 일반화할 수는 없습니다. 이번 실험에는 일반 created_at 인덱스만 있었습니다.
패키지 솔루션처럼 SQL을 고칠 수 없는 환경에서는 함수 기반 인덱스를 별도로 검토할 수 있습니다. 다만 인덱스가 하나 늘어나는 만큼 저장 공간과 INSERT·UPDATE 시 유지 비용이 생깁니다. 이번 사례는 인덱스를 추가하지 않고 조건만 바꿔 범위 스캔을 확보했다는 점에서 비용이 가장 적은 해결 방법이었습니다.
DATETIME과 TIMESTAMP의 시간대가 다를 때
이번 테스트 컬럼은 DATETIME(6)입니다. TIMESTAMP는 저장과 조회 과정에서 세션 시간대에 따른 변환이 적용되므로, 운영 환경에서는 업무상 하루의 기준 시간대와 접속 세션의 시간대를 함께 확인해야 합니다.
DATETIME에 UTC 시각을 저장하는 서비스라면, 한국 시간 기준 하루는 UTC로 전날 15시부터 당일 15시 미만입니다. 컬럼에 시간대 변환 함수를 씌우기 전에, 이처럼 경계값을 저장 기준으로 미리 계산해 원본 컬럼과 비교할 수 있는지 먼저 검토합니다.
날짜 조건 SQL을 점검하는 순서
- EXPLAIN ANALYZE에서 인덱스 이름 앞의 접근 방식이 index scan인지 index range scan인지 확인합니다.
- 스캔 노드의 실제 rows와 Filter를 통과한 rows를 비교해 버려지는 행의 비율을 확인합니다.
- WHERE 절에서 컬럼에 함수가 씌워져 있다면 원본 컬럼의 반개방 범위로 바꿀 수 있는지 검토합니다.
- 바꾼 조건은 건수와 행별 판정을 모두 비교해 결과가 같은지 검증합니다.
- 종료값이 다음 날 자정 미만으로 지정되었는지, 컬럼이 소수 초를 저장하는지 확인합니다.
- 실제 SELECT 목록, 조인, 정렬, 시간대 조건을 포함한 원래 SQL로 다시 측정합니다.
이번 실험에서 두 SQL은 같은 인덱스를 사용했고 같은 1만 건을 반환했습니다. 차이는 인덱스를 몇 행 읽었느냐였고, 그 차이는 WHERE 절에서 컬럼을 가공했는지에서 나왔습니다. 날짜 조회가 느리다면 인덱스가 있는지보다 인덱스를 얼마나 좁혀 읽었는지를 먼저 확인해 보시기 바랍니다.

댓글 0
첫 댓글을 남겨보세요.