MySQL Buffer Pool에 데이터가 적재되는 과정: 첫 조회와 반복 조회 비교
같은 SQL을 실행했는데 첫 번째만 느리고 두 번째부터 빨라지는 경우가 있습니다. 실행계획이 잘못되었거나 인덱스가 부족한 것처럼 보이지만, 조회에 필요한 데이터 페이지가 이미 메모리에 있는지에 따라서도 응답 시간은 크게 달라집니다.
MySQL 8.4.11에서 10만 행 테이블을 대상으로 같은 집계 SQL을 세 번 실행했습니다. 첫 조회는 215.952ms, 두 번째는 20.763ms, 세 번째는 14.800ms였습니다. 첫 조회 구간에서는 디스크 읽기 96회와 Read-ahead 3,449페이지가 기록되었고, 이후 두 번의 조회에서는 두 지표의 증가량이 모두 0이었습니다.
이 글에서는 “다시 실행하니 빨라졌다”는 관찰을 InnoDB 읽기 상태값으로 확인합니다. 측정 구간의 증가량을 기록하는 방법, Buffer Pool 적중률만 보면 첫 조회의 디스크 읽기를 놓치는 이유, 운영에서 첫 조회 지연을 다루는 방법까지 정리합니다.
첫 조회만 느린 SQL, 실행계획부터 의심하기 전에
InnoDB는 데이터와 인덱스를 16KiB 단위의 페이지로 관리하고, 읽은 페이지를 Buffer Pool이라는 메모리 영역에 보관합니다. SQL 실행에 필요한 페이지가 Buffer Pool에 있으면 그대로 사용하고, 없으면 데이터 파일에서 읽어 와 적재한 뒤 사용합니다.
테이블 전체를 순서대로 읽을 때는 곧 필요해질 페이지를 미리 묶어서 가져오는 Read-ahead(선행 읽기)도 동작할 수 있습니다. 따라서 첫 조회의 읽기 동작을 확인하려면 일반 디스크 읽기와 선행 읽기 지표를 함께 봐야 합니다. 이번 실험에서 확인하려는 가설은 다음과 같습니다.
- 첫 조회에서는 Buffer Pool에 없는 페이지를 가져오는 읽기가 발생합니다.
- 조회 후 페이지가 Buffer Pool에 남으면 반복 조회는 그 페이지를 재사용합니다.
- 반복 조회에서는 추가 디스크 읽기가 사라지고 실행 시간도 짧아집니다.
- 메모리에서 읽더라도 행을 탐색하고 집계하는 작업은 그대로 남습니다.
이 글에서 말하는 “첫 조회”는 측정 1회차를 뜻합니다. 데이터 입력이나 사전 조회 과정에서도 페이지가 적재될 수 있으므로, 측정 전에 Buffer Pool이 완전히 비어 있었다고 가정하지 않습니다.
테스트 환경
환경 구성
| 항목 | 실험 조건 및 확인값 |
|---|---|
| MySQL 버전 | 8.4.11 (Windows 로컬, Workbench) |
| 스키마 / 테이블 | lab_buffer_pool35 / buffer_pool_test |
| 행 수 | 100,000행 |
| 컬럼 | id, amount, payload(행마다 500바이트) |
| 인덱스 | PRIMARY KEY (id) |
| InnoDB 페이지 크기 | 16,384바이트 (16KiB) |
| Buffer Pool 크기 | 128.0MiB |
| 테이블 데이터 크기 (DATA_LENGTH) | 56.6MiB |
| innodb_flush_method | unbuffered |
| 측정 방식 | 같은 집계 SQL 3회 실행, 실행 직전·직후 전역 상태값의 차이 기록 |
환경 확인 쿼리
버전, 페이지 크기, Buffer Pool 크기, 테이블 데이터 크기, I/O 방식을 한 번에 확인했습니다.
SELECT
    VERSION() AS mysql_version,
    100000 AS test_rows,
    'PRIMARY KEY (id)' AS index_definition,
    @@innodb_page_size AS page_size_bytes,
    ROUND(@@innodb_buffer_pool_size / 1024 / 1024, 1)
        AS buffer_pool_mib,
    ROUND(t.DATA_LENGTH / 1024 / 1024, 1)
        AS table_data_mib,
    @@innodb_flush_method AS flush_method
FROM information_schema.TABLES AS t
WHERE t.TABLE_SCHEMA = 'lab_buffer_pool35'
  AND t.TABLE_NAME = 'buffer_pool_test';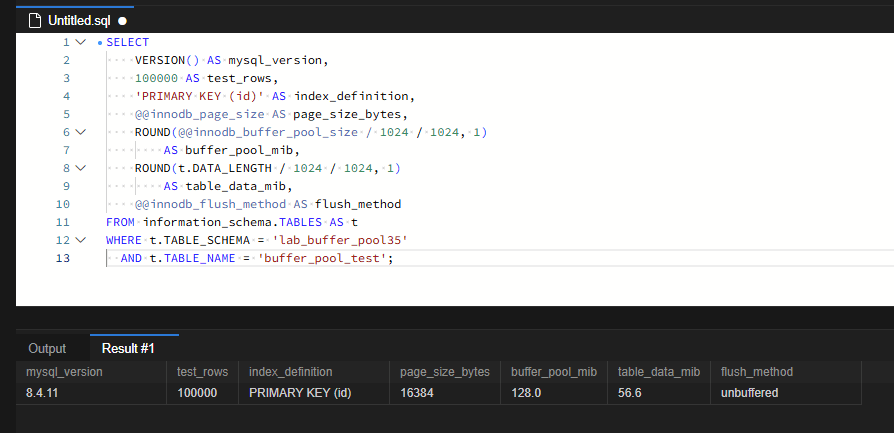
결과의 test_rows와 index_definition은 쿼리에 상수로 적은 값입니다. 실제 행 수는 뒤의 측정 결과로 확인할 수 있습니다. payload_bytes 합계 50,000,000이 행당 500바이트 × 100,000행과 일치합니다.
테이블 데이터 56.6MiB는 Buffer Pool 128MiB보다 작으므로, 다른 사용량이 크지 않다면 한 번 읽은 페이지가 반복 조회 때까지 남아 있을 여지가 있습니다. 다만 Buffer Pool은 다른 테이블과 내부 페이지가 함께 쓰는 공간이므로, 크기 비교만으로 전체 데이터가 메모리에 머문다고 보장할 수는 없습니다.
flush_method의 unbuffered는 Windows에서 InnoDB가 운영체제 파일 캐시를 거치지 않고 데이터 파일을 읽고 쓰는 방식입니다. 반복 조회가 빨라진 이유를 운영체제 캐시가 아니라 InnoDB Buffer Pool에서 찾을 수 있는 근거가 되는 설정입니다. 다만 저장장치 자체의 캐시까지 배제한 것은 아닙니다.
재현용 예시 테이블과 데이터
아래는 본문의 조건과 집계 결과를 다시 만들 수 있도록 정리한 예시 스크립트입니다. 이 데이터로 실행하면 amount 합계 499,950,000과 payload 합계 50,000,000이 캡처와 같게 나옵니다. 테이블 크기와 시간은 환경에 따라 조금 다를 수 있으며, 반드시 별도 테스트 스키마에서 실행합니다.
CREATE DATABASE IF NOT EXISTS lab_buffer_pool35;

CREATE TABLE lab_buffer_pool35.buffer_pool_test (
    id      INT UNSIGNED NOT NULL,
    amount  INT          NOT NULL,
    payload VARCHAR(500) NOT NULL,
    PRIMARY KEY (id)
) ENGINE=InnoDB;

INSERT INTO lab_buffer_pool35.buffer_pool_test (id, amount, payload)
WITH digits AS (
    SELECT 0 AS d UNION ALL SELECT 1 UNION ALL SELECT 2
    UNION ALL SELECT 3 UNION ALL SELECT 4 UNION ALL SELECT 5
    UNION ALL SELECT 6 UNION ALL SELECT 7 UNION ALL SELECT 8
    UNION ALL SELECT 9
),
numbers AS (
    SELECT a.d + b.d * 10 + c.d * 100
         + d.d * 1000 + e.d * 10000 AS n
    FROM digits a
    CROSS JOIN digits b
    CROSS JOIN digits c
    CROSS JOIN digits d
    CROSS JOIN digits e
)
SELECT
    n + 1,
    MOD(n + 1, 10000),
    REPEAT('x', 500)
FROM numbers
ORDER BY n;

COMMIT;
누적값이 아니라 실행 구간의 증가량을 기록합니다
읽기 지표는 InnoDB의 전역 상태값 세 가지를 사용했습니다.
| 결과 열 | 원본 상태값 | 의미 |
|---|---|---|
| logical_reads | Innodb_buffer_pool_read_requests | Buffer Pool에 페이지를 요청한 논리 읽기 횟수 |
| disk_reads | Innodb_buffer_pool_reads | Buffer Pool에 없어서 데이터 파일에서 직접 읽어야 했던 횟수 |
| read_ahead_pages | Innodb_buffer_pool_read_ahead | 선행 읽기로 미리 Buffer Pool에 적재한 페이지 수 |
이 값들은 서버가 시작된 뒤 계속 누적되므로 그대로 비교하면 이전 작업의 영향이 섞입니다. 그래서 집계 SQL 실행 직전과 직후의 값을 읽어 차이를 기록하는 프로시저를 사용했습니다. 아래는 같은 방식으로 동작하는 예시 프로시저입니다.
CREATE TABLE lab_buffer_pool35.read_measure (
    run_no           INT PRIMARY KEY,
    elapsed_ms       DECIMAL(12,3),
    logical_reads    BIGINT,
    disk_reads       BIGINT,
    read_ahead_pages BIGINT,
    amount_sum       BIGINT,
    payload_bytes    BIGINT
) ENGINE=InnoDB;

DELIMITER $$

CREATE PROCEDURE lab_buffer_pool35.measure_read(IN p_run INT)
BEGIN
    DECLARE v_req1, v_req2, v_rd1, v_rd2, v_ra1, v_ra2 BIGINT;
    DECLARE v_t1, v_t2 DATETIME(6);
    DECLARE v_amount, v_bytes BIGINT;

    SELECT
        SUM(IF(VARIABLE_NAME = 'Innodb_buffer_pool_read_requests', VARIABLE_VALUE, 0)),
        SUM(IF(VARIABLE_NAME = 'Innodb_buffer_pool_reads', VARIABLE_VALUE, 0)),
        SUM(IF(VARIABLE_NAME = 'Innodb_buffer_pool_read_ahead', VARIABLE_VALUE, 0))
    INTO v_req1, v_rd1, v_ra1
    FROM performance_schema.global_status;

    SET v_t1 = SYSDATE(6);

    SELECT
        SUM(amount),
        SUM(OCTET_LENGTH(payload))
    INTO v_amount, v_bytes
    FROM lab_buffer_pool35.buffer_pool_test;

    SET v_t2 = SYSDATE(6);

    SELECT
        SUM(IF(VARIABLE_NAME = 'Innodb_buffer_pool_read_requests', VARIABLE_VALUE, 0)),
        SUM(IF(VARIABLE_NAME = 'Innodb_buffer_pool_reads', VARIABLE_VALUE, 0)),
        SUM(IF(VARIABLE_NAME = 'Innodb_buffer_pool_read_ahead', VARIABLE_VALUE, 0))
    INTO v_req2, v_rd2, v_ra2
    FROM performance_schema.global_status;

    INSERT INTO lab_buffer_pool35.read_measure
    VALUES (
        p_run,
        TIMESTAMPDIFF(MICROSECOND, v_t1, v_t2) / 1000,
        v_req2 - v_req1,
        v_rd2 - v_rd1,
        v_ra2 - v_ra1,
        v_amount,
        v_bytes
    );

    SELECT * FROM lab_buffer_pool35.read_measure ORDER BY run_no;
END$$

DELIMITER ;
집계 결과는 변수에 저장하므로 10만 행을 클라이언트로 전송하는 시간이 측정에 섞이지 않습니다. 실행 시간은 SYSDATE(6)로 기록한 경과 시간이며, CPU 사용 시간이나 순수 디스크 대기 시간과는 다릅니다.
상태값은 서버 전역 지표이므로 다른 세션이나 백그라운드 작업의 영향까지 완전히 분리한 쿼리 전용 통계는 아닙니다. 논리 읽기 횟수도 처리한 행 수나 서로 다른 페이지 수와 같은 값이 아닙니다.
실행계획: 전체 행을 읽는 Table scan입니다
측정 대상 SQL은 모든 행의 amount와 payload 길이를 합산합니다.
USE lab_buffer_pool35;

EXPLAIN FORMAT = TREE
SELECT
    SUM(amount) AS amount_sum,
    SUM(OCTET_LENGTH(payload)) AS payload_bytes
FROM buffer_pool_test;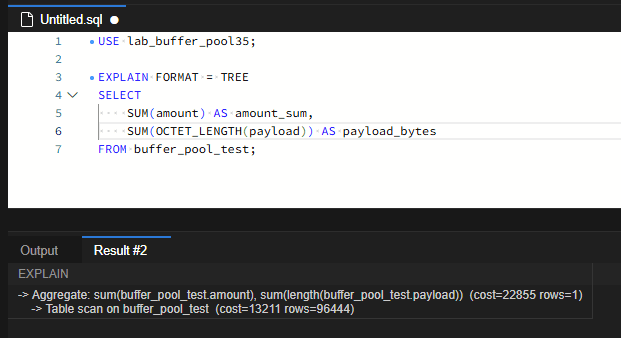
Table scan의 rows=96444는 통계로 계산한 추정치이며 실제 행 수는 100,000행입니다. 이번 출력은 EXPLAIN ANALYZE가 아니므로 실제 행 수와 시간은 표시되지 않습니다. 또한 cost=22855는 실행 시간이 아니라 계획 비교용 상대 값입니다. Aggregate에 OCTET_LENGTH가 length로 표시된 것은 MySQL에서 두 함수가 같은 동작이기 때문입니다.
이 SQL은 업무상 전체 행을 집계해야 하므로 Table scan이라는 이유만으로 비효율적인 계획이라고 볼 수 없습니다. 세 번의 측정 모두 같은 계획으로 같은 양의 행을 처리한다는 점이 이번 비교의 전제입니다. 시간 차이는 계획이 아니라 페이지를 어디서 가져왔는지에서 나와야 합니다.
측정 1회차: 디스크 읽기 96회와 선행 읽기 3,449페이지
CALL lab_buffer_pool35.measure_read(1);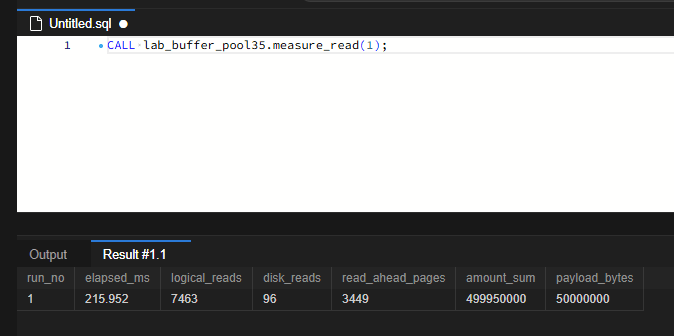
disk_reads 96만 보면 56.6MiB 테이블을 읽은 것치고 읽기가 아주 적어 보입니다. 하지만 같은 구간에 Read-ahead가 3,449페이지 기록되었습니다. 페이지 크기가 16KiB이므로 약 53.9MiB에 해당합니다. 테이블을 순서대로 읽는 동안 InnoDB가 앞으로 필요할 페이지를 묶어서 미리 적재했다는 것과 부합하는 결과입니다.
페이지 수로 비교하면 규모가 더 분명해집니다. DATA_LENGTH 56.6MiB는 16KiB 페이지로 약 3,622페이지이고, 이번 구간의 직접 읽기 96페이지와 선행 읽기 3,449페이지를 합하면 3,545페이지입니다. 1회차 동안 테이블 대부분에 해당하는 페이지가 데이터 파일에서 Buffer Pool로 들어온 것으로 볼 수 있습니다.
다만 이 비교는 규모를 가늠하기 위한 것입니다. 두 상태값은 서버 전역 카운터이며, 이 테이블에서 읽은 정확한 바이트 수나 저장장치가 처리한 I/O 명령 수를 뜻하지 않습니다. 직접 읽기는 쿼리가 페이지를 기다리며 읽은 것이고 선행 읽기는 미리 가져온 것이므로, 두 값을 같은 성격의 I/O 횟수로 보지도 않습니다.
Buffer Pool 적중률만 보면 놓치는 것
Buffer Pool 적중률은 흔히 1 - Innodb_buffer_pool_reads / Innodb_buffer_pool_read_requests로 계산합니다. 1회차 구간의 값을 넣으면 1 – 96 / 7,463으로 약 98.7%입니다. 이 숫자만 보면 1회차도 거의 모든 페이지를 메모리에서 읽은 것처럼 보입니다.
실제로는 같은 구간에 약 53.9MiB가 선행 읽기로 데이터 파일에서 적재되었습니다. 선행 읽기로 미리 들어온 페이지는 나중에 쿼리가 요청할 때 이미 Buffer Pool에 있으므로 Innodb_buffer_pool_reads에 집계되지 않기 때문입니다. 전체 스캔이 많은 환경에서 적중률 하나로 메모리 상태를 판단하면, 디스크에서 가져온 양을 크게 과소평가할 수 있습니다. 첫 조회 지연을 분석할 때 read_ahead 지표를 함께 봐야 하는 이유입니다.
측정 2·3회차: 추가 읽기 없이 같은 결과를 계산했습니다
CALL lab_buffer_pool35.measure_read(2);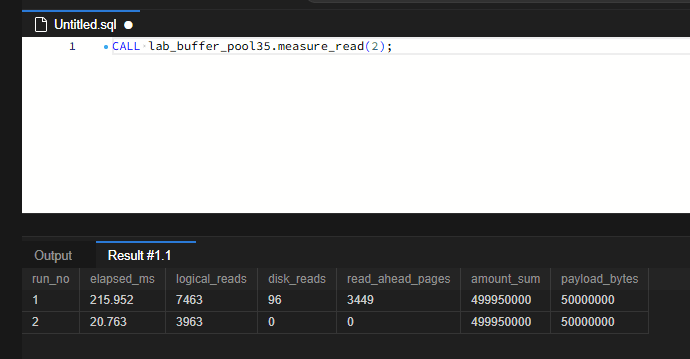
2회차는 1회차보다 약 90.4% 짧은 20.763ms에 끝났고, 디스크 읽기와 선행 읽기는 하나도 늘지 않았습니다. 같은 실행계획으로 같은 행을 처리했는데 데이터 파일 읽기만 사라졌으므로, 1회차에 적재된 페이지를 Buffer Pool에서 재사용했다는 해석을 뒷받침합니다.
CALL lab_buffer_pool35.measure_read(3);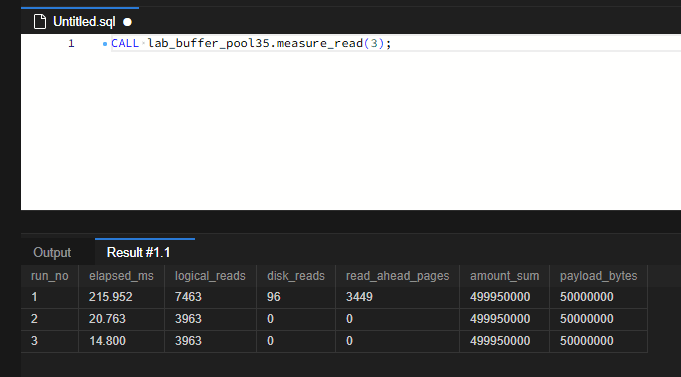
| 측정 회차 | 실행 시간(ms) | 논리 읽기 | 디스크 읽기 | Read-ahead 페이지 | 1회차 대비 시간 |
|---|---|---|---|---|---|
| 1회차 | 215.952 | 7,463 | 96 | 3,449 | 기준 |
| 2회차 | 20.763 | 3,963 | 0 | 0 | 약 90.4% 감소 |
| 3회차 | 14.800 | 3,963 | 0 | 0 | 약 93.1% 감소 |
세 번 모두 amount_sum은 499,950,000, payload_bytes는 50,000,000으로 같습니다. 같은 데이터를 같은 방식으로 집계하면서 읽기 지표와 시간만 달라졌다는 뜻입니다. 이전 결과를 저장해 두었다가 돌려준 것이 아니라, 매번 10만 행을 다시 읽어 합계를 계산했습니다.
반복 조회에도 남는 작업량
2·3회차의 논리 읽기 3,963회는 테이블 데이터의 페이지 수(약 3,622페이지)와 비슷한 규모입니다. 디스크 읽기가 사라졌을 뿐 테이블 전체 페이지를 한 번씩 훑는 작업은 그대로 남아 있다는 뜻입니다. 메모리에서 읽어도 10만 행을 탐색하고 합산하는 데 14.8~20.8ms가 걸렸습니다.
이번 지표로 설명하지 않는 수치
논리 읽기는 1회차 7,463회에서 2회차 이후 3,963회로 3,500회 줄었습니다. 같은 SQL이 같은 결과를 냈으므로 처리한 행이 줄어든 것은 아닙니다. 첫 실행의 내부 동작이나 전역 지표에 섞인 다른 활동이 영향을 줄 수 있지만, 이번 캡처만으로 차이의 원인을 특정할 수는 없습니다. 이 차이를 디스크 읽기나 선행 읽기 수치와 일대일로 대응시키지도 않습니다.
2회차와 3회차는 읽기 지표가 모두 같은데 시간은 약 6ms 차이가 납니다. CPU 캐시, 스레드 스케줄링, 순간적인 부하 등이 원인일 수 있지만 별도로 측정하지 않았습니다. 따라서 2회차 이후의 추가 단축까지 Buffer Pool의 변화로 설명하지 않습니다.
측정값을 해석하는 범위
시간은 회차마다 한 번씩 관측한 값이며 반복 실험의 평균이 아닙니다. 90.4%와 93.1%라는 감소율도 이번 실행에서 관측한 값으로 한정하며, 운영 환경에서 보장되는 개선율이 아닙니다.
1회차 직전의 Buffer Pool 상태도 통제하지 않았습니다. 1회차에 테이블 대부분이 적재된 것으로 보아 측정 전에는 이 테이블의 페이지 대부분이 Buffer Pool에 없었을 가능성이 크지만, 일부 페이지는 남아 있었을 수 있습니다.
캐시가 빈 상태에서의 첫 조회를 재현하려면, 서버를 재시작하고 시작 시 Buffer Pool 복원을 끈 상태에서 1회차를 측정하는 방법이 있습니다. 이번 실험에서는 이 방식을 사용하지 않았습니다.
운영에서 첫 조회 지연을 다루는 방법
이번 비교는 SQL이나 인덱스를 고친 전후가 아니라 같은 SQL의 첫 조회와 반복 조회를 비교한 것입니다. 아래의 Buffer Pool 복원과 페이지 교체 방식은 MySQL의 일반적인 동작에 대한 설명이며, 이번 실험에서 별도로 측정하지는 않았습니다.
첫 조회만 느리다면 같은 구간의 읽기 증가량부터 확인합니다
첫 실행에서만 Innodb_buffer_pool_reads나 Innodb_buffer_pool_read_ahead가 늘고 반복 실행에서 0이 된다면, 실행계획보다 데이터 적재 과정의 영향을 먼저 검토합니다. 이때 적중률 하나만 보지 말고 선행 읽기 증가량을 함께 확인해야 1회차처럼 대량 적재가 일어난 구간을 놓치지 않습니다.
재시작 직후 지연에는 Buffer Pool 덤프와 복원을 확인합니다
서버 재시작 직후에는 Buffer Pool이 비어 있어 여러 SQL이 동시에 첫 조회 상태가 됩니다. MySQL은 종료 시 Buffer Pool에 있던 페이지 목록을 저장하고 시작 시 다시 읽어 오는 기능을 제공하며, 기본 설정에서는 자주 쓰인 페이지 중 일부(기본 25%)를 대상으로 동작합니다. 재시작 후 지연이 문제라면 먼저 현재 설정을 확인합니다.
SHOW VARIABLES LIKE 'innodb_buffer_pool_dump%';
SHOW VARIABLES LIKE 'innodb_buffer_pool_load%';
워밍업을 위해 큰 테이블 전체를 일부러 읽는 방식은 피하는 것이 좋습니다. 다른 업무에 필요한 페이지를 밀어내거나 기동 직후 I/O 부하를 키울 수 있으므로, 대상 테이블과 범위를 실제로 자주 쓰는 데이터로 제한합니다.
대량 스캔이 자주 쓰는 페이지를 밀어내지 않도록 설계되어 있습니다
InnoDB는 새로 읽은 페이지를 Buffer Pool 목록의 맨 앞이 아니라 중간 지점에 넣고, 짧은 시간 안에 반복 접근된 페이지는 자주 쓰는 영역으로 옮기지 않습니다(innodb_old_blocks_time, 기본 1000ms). 이번 실험 같은 전체 스캔이 한 번 지나가더라도 기존에 자주 쓰던 페이지가 곧바로 밀려나지 않도록 하기 위한 동작입니다.
따라서 반복 조회가 빠르다는 사실만으로 해당 테이블이 앞으로도 계속 메모리에 남는다고 보장할 수는 없습니다. 실제 운영에서는 다른 작업이 Buffer Pool을 함께 쓰므로, 같은 SQL이 시간이 지난 뒤 다시 느려질 수도 있습니다.
반복 조회에서도 디스크 읽기가 계속되면 용량과 경합을 봅니다
같은 SQL을 반복해도 디스크 읽기가 계속 늘어난다면, 작업에 필요한 페이지가 Buffer Pool에 머물지 못하는 상황입니다. 다른 세션의 대량 스캔이나 큰 배치 작업이 같은 시간대에 실행되는지 함께 확인합니다. 이번 실험은 2회차부터 읽기 증가량이 0이었으므로 Buffer Pool 확대가 필요하다는 근거는 없었습니다. 그렇다고 128MiB가 실제 운영 부하에도 충분하다는 뜻은 아닙니다.
메모리에서 읽어도 SQL의 작업량은 그대로입니다
반복 조회에서도 논리 읽기 3,963회와 10만 행 집계는 매번 발생했습니다. 데이터가 메모리에 있다는 사실이 SQL이 효율적이라는 뜻은 아닙니다. 전체 집계가 정말 필요한지, 조회 범위를 줄일 수 있는지, 실행 빈도가 과도하지 않은지는 Buffer Pool 상태와 별개로 검토해야 합니다.
이번 실험에서 세 번의 조회는 같은 계획으로 같은 결과를 냈고, 시간 차이는 1회차에만 기록된 디스크 읽기와 선행 읽기에서 나왔습니다. 첫 조회가 느릴 때 “두 번째는 빨랐다”에서 멈추지 말고, 같은 측정 구간의 논리 읽기, 디스크 읽기, 선행 읽기를 나란히 놓아 보시기 바랍니다. 그래야 데이터 적재의 영향과 SQL 자체의 작업량을 구분할 수 있습니다.

댓글 0
첫 댓글을 남겨보세요.