MySQL 커버링 인덱스 실험: 조회 컬럼 하나가 추가되면 무엇이 바뀌는가
주문 목록 화면에 배송 메모를 보여 달라는 요청이 들어왔다고 해 보겠습니다. 개발자는 기존 목록 쿼리의 SELECT 목록에 customer_note 컬럼 하나를 추가해 배포합니다. 검색 조건도, 조회 건수도 그대로입니다. 그런데 배포 후 같은 화면의 조회 시간이 눈에 띄게 늘었습니다.
실행계획을 열어 보면 기존 인덱스를 여전히 사용하고 있습니다. 인덱스를 타는데 왜 느려졌을까요? 이 글은 이 상황을 MySQL 8.4.11에서 그대로 재현하고, 실행계획을 한 단계씩 따라가며 원인을 좁힌 기록입니다.
실험에서는 10만 건 중 특정 고객의 주문 1,000건을 조회했습니다. 컬럼 하나를 추가하자 실행 노드의 전체 행 반환 시간이 0.260ms에서 3.510ms로 늘었고, 인덱스를 조정한 뒤에는 0.371ms로 돌아왔습니다. 모두 캡처에 기록된 단일 실행값이며, 반복 측정 평균이나 운영 환경의 성능을 뜻하지는 않습니다.
재현 환경: 고객 100명, 주문 10만 건
고객 100명에게 주문을 1,000건씩 배분했습니다. 같은 고객의 주문이 기본 키 순서에서 한곳에 몰리지 않도록 고객 번호를 순환 배치했습니다. 실제 주문 테이블에서도 한 고객의 주문은 시간 순서대로 여기저기 흩어져 쌓이기 때문입니다. 조회하지 않는 payload 컬럼에는 200자 데이터를 넣어 행 크기를 키웠습니다.
| 항목 | 값 |
|---|---|
| MySQL 버전 | 8.4.11 |
| 스키마 / 테이블 | lab_covering_index.orders_cover_lab |
| 스토리지 엔진 | InnoDB |
| 전체 데이터 | 100,000건 |
| 조회 조건 / 대상 | customer_id = 42 / 1,000건 |
| 버퍼 풀 | 128MiB |
| 격리 수준 | REPEATABLE-READ |
| 기본 키 | order_id |
| 최초 보조 인덱스 | idx_customer_date_amount (customer_id, order_date, total_amount) |
| 측정 방법 | EXPLAIN ANALYZE의 actual time, rows, loops |
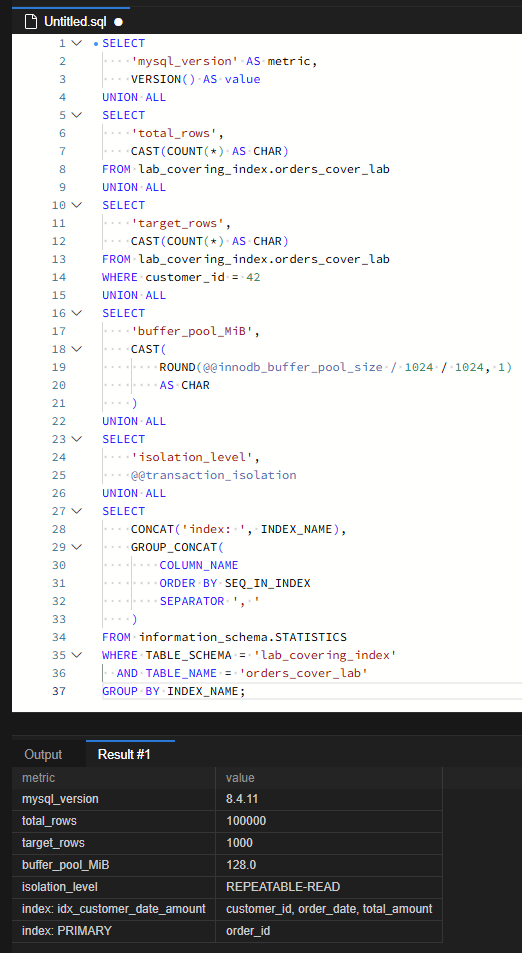
비교 쿼리에는 ORDER BY, LIMIT, 인덱스 힌트를 넣지 않았습니다. 앞의 두 쿼리는 SELECT 목록만 다르고, 마지막 단계는 인덱스만 바꾼 뒤 같은 SQL을 다시 실행했습니다. 캐시를 비운 콜드 상태 비교가 아니므로, 시간 값은 접근 방식이 바뀌었다는 사실을 보조하는 관측값으로 읽어야 합니다.
1차 확인: 배포 전 쿼리는 인덱스만 읽고 끝났습니다
먼저 배포 전 목록 쿼리의 실행계획을 봅니다.
EXPLAIN ANALYZE
SELECT
    order_id,
    customer_id,
    order_date,
    total_amount
FROM lab_covering_index.orders_cover_lab
WHERE customer_id = 42;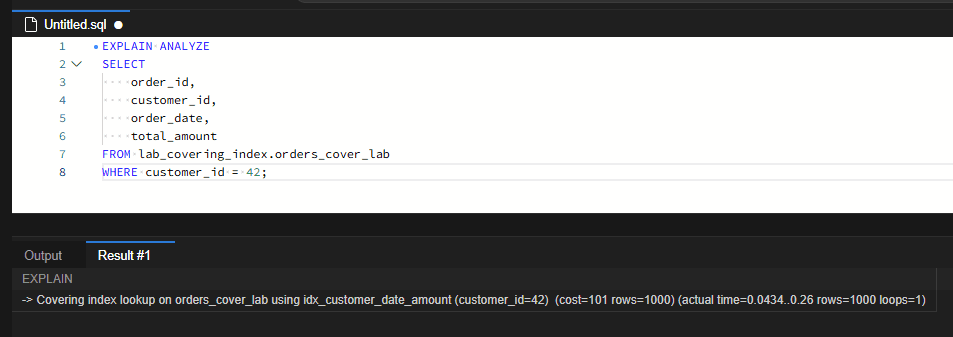
실행계획 첫 줄에 Covering index lookup이 표시되었습니다. 옵티마이저 추정 cost는 101, 예상 행 수와 실제 행 수는 모두 1,000건입니다. actual time 0.0434..0.26은 첫 행을 내놓기까지 약 0.0434ms, 1,000건을 모두 내놓기까지 약 0.260ms가 걸렸다는 뜻입니다. loops가 1이므로 이 값이 그대로 전체 시간입니다.
이 쿼리가 인덱스만으로 끝날 수 있었던 이유는 조회 컬럼 네 개가 모두 보조 인덱스 안에 있기 때문입니다. customer_id, order_date, total_amount는 인덱스 정의에 있고, order_id는 정의에 없지만 InnoDB 보조 인덱스가 각 엔트리 끝에 기본 키 값을 함께 저장합니다.
보조 인덱스 엔트리 구조 (InnoDB)
[ customer_id | order_date | total_amount ] + [ order_id (기본 키) ]
  └──────── 인덱스 정의 컬럼 ────────┘      └─ 자동 포함 ─┘
따라서 보조 인덱스를 범위 탐색하는 것만으로 필요한 값이 모두 나옵니다. 테이블 본체인 클러스터드 인덱스에는 들어가지 않습니다.
2차 확인: 컬럼 하나 추가 후 Covering 표시가 사라졌습니다
이제 배포 후 쿼리입니다. 달라진 것은 SELECT 목록의 customer_note 한 줄뿐입니다.
EXPLAIN ANALYZE
SELECT
    order_id,
    customer_id,
    order_date,
    total_amount,
    customer_note
FROM lab_covering_index.orders_cover_lab
WHERE customer_id = 42;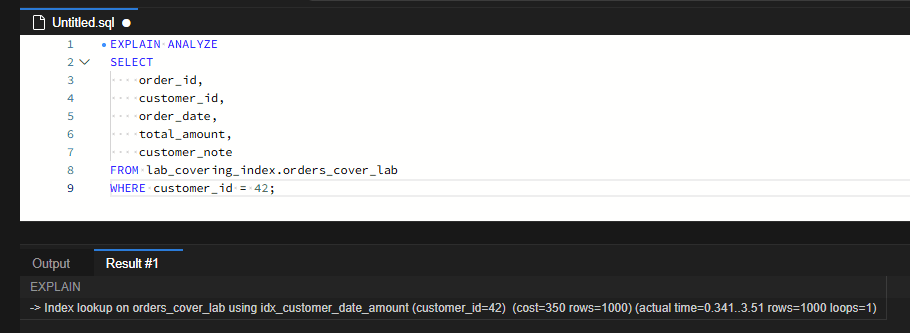
사용하는 인덱스 이름은 idx_customer_date_amount 그대로입니다. 인덱스 이름만 확인했다면 “인덱스는 잘 타고 있다”고 결론 내렸을 것입니다. 하지만 접근 방식이 Index lookup으로 바뀌었고 Covering이라는 단어가 빠졌습니다.
반환 행 수는 1,000건, loops는 1로 같습니다. 그런데 actual time은 0.341..3.51로 전체 행 반환 시간이 0.260ms에서 3.510ms로 약 13.5배 늘었고, 추정 cost도 101에서 350으로 올라갔습니다. 첫 행이 나오는 시간부터 0.0434ms에서 0.341ms로 늘어난 점도 눈여겨볼 만합니다. 행 하나를 내놓을 때마다 해야 할 일이 늘었다는 신호입니다.
원인은 customer_note가 보조 인덱스에 없다는 데 있습니다. 이제 MySQL은 보조 인덱스에서 조건에 맞는 엔트리를 찾을 때마다, 그 엔트리의 기본 키로 클러스터드 인덱스를 다시 탐색해 행 전체에서 customer_note를 꺼내야 합니다. 이 실험에서는 고객 번호를 순환 배치했기 때문에 1,000건의 행이 기본 키 순서상 넓게 흩어져 있고, 그만큼 서로 다른 페이지를 찾아가게 됩니다.
다만 행 접근이 1,000번 추가되었다고 해서 물리 디스크 읽기가 1,000번 일어났다는 뜻은 아닙니다. 필요한 페이지가 버퍼 풀에 이미 있을 수 있고, 이번 실험에서는 물리 I/O 횟수를 측정하지 않았습니다. 확인한 것은 접근 경로가 “인덱스만”에서 “인덱스 + 테이블”로 바뀌었다는 사실과 그에 따른 실행 시간 변화입니다.
해결 시도: 추가된 컬럼을 인덱스에 포함하면 되돌아오는가
원인이 커버링 해제라면, customer_note를 인덱스 뒤쪽에 붙여 다시 인덱스만으로 조회를 끝낼 수 있게 하면 됩니다. 실험 테이블에서 기존 보조 인덱스를 다음과 같이 교체했습니다.
ALTER TABLE lab_covering_index.orders_cover_lab
    DROP INDEX idx_customer_date_amount,
    ADD INDEX idx_customer_date_amount_note (
        customer_id,
        order_date,
        total_amount,
        customer_note
    );

ANALYZE TABLE lab_covering_index.orders_cover_lab;
새 컬럼은 맨 뒤에 두었습니다. 검색 조건인 customer_id가 선두에 그대로 있어야 기존 탐색 방식이 유지되고, 뒤에 붙인 컬럼은 탐색이 아니라 값을 꺼내는 용도로만 쓰이기 때문입니다. 변경 후 인덱스 구성은 INFORMATION_SCHEMA.STATISTICS로 확인했습니다.
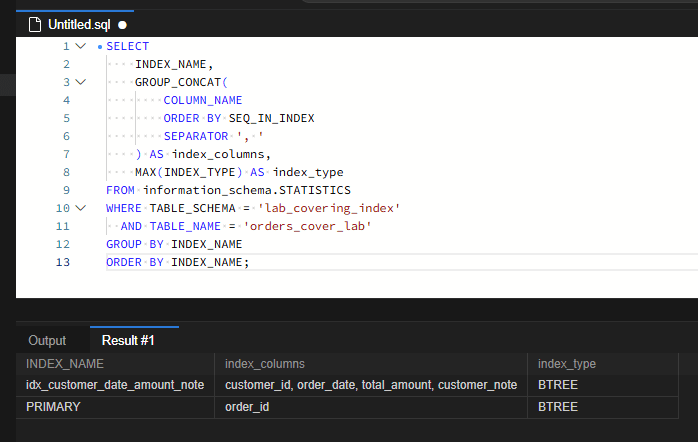
이제 2차 확인 때와 글자 하나 다르지 않은 SQL을 다시 실행합니다.
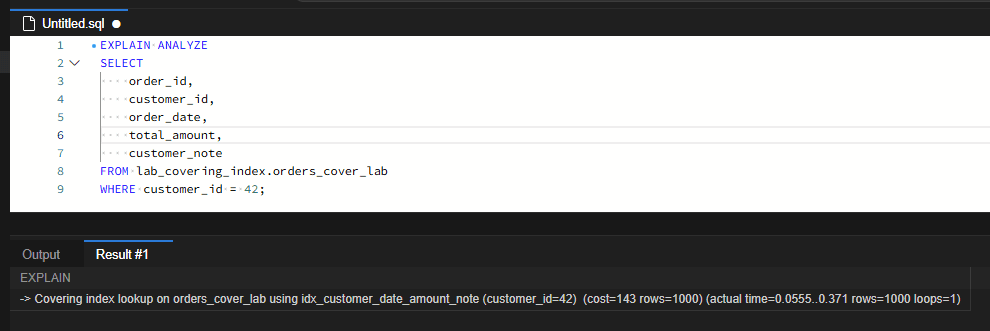
새 인덱스 idx_customer_date_amount_note를 사용하는 Covering index lookup이 다시 나타났습니다. 행 수 1,000건, loops 1은 같고, actual time은 0.0555..0.371, cost는 143입니다. 같은 조회 컬럼 기준으로 3.510ms에서 0.371ms로 약 89.4% 줄었습니다.
세 단계를 한 표로 모으면 다음과 같습니다.
| 비교 항목 | 배포 전 쿼리 | 컬럼 추가 후 | 인덱스 변경 후 |
|---|---|---|---|
| customer_note 조회 | 없음 | 있음 | 있음 |
| 사용 인덱스 | idx_customer_date_amount | idx_customer_date_amount | idx_customer_date_amount_note |
| 접근 방식 | Covering index lookup | Index lookup | Covering index lookup |
| 예상 / 실제 행 수 | 1,000 / 1,000 | 1,000 / 1,000 | 1,000 / 1,000 |
| loops | 1 | 1 | 1 |
| 첫 행 반환 시간 | 0.0434ms | 0.341ms | 0.0555ms |
| 전체 행 반환 시간 | 0.260ms | 3.510ms | 0.371ms |
| 옵티마이저 추정 cost | 101 | 350 | 143 |
표의 시간은 EXPLAIN ANALYZE 실행 노드 기준이며, 네트워크 전송이나 애플리케이션 처리 시간은 포함하지 않습니다. cost는 옵티마이저가 계획을 고를 때 쓰는 상대 비용이지 밀리초 단위가 아닙니다. 89.4%라는 감소율도 단일 실행값의 산술 비교일 뿐, 다른 환경에서 같은 개선율을 기대할 근거는 아닙니다.
커버링이 복원됐는데 왜 처음보다는 느릴까
인덱스 변경 후 0.371ms는 배포 전의 0.260ms와 같지 않았고, cost도 101이 아니라 143이었습니다. 새 인덱스는 문자열 컬럼이 추가되어 엔트리 하나의 폭이 넓어졌으므로 같은 1,000건을 읽어도 더 많은 인덱스 페이지를 거칩니다. 쿼리도 컬럼 하나를 더 반환합니다. 여기에 실행 시점의 캐시 상태와 측정 변동이 겹칠 수 있어, 이번 캡처만으로 차이를 한 가지 원인에 돌리기는 어렵습니다.
분명한 것은 커버링 인덱스도 공짜가 아니라는 점입니다. 인덱스에 넣는 컬럼이 넓을수록 커버링으로 얻는 이득은 줄고, 대신 저장 공간과 쓰기 비용은 늘어납니다.
운영에서는 무엇을 먼저 선택해야 하나
실험에서는 “customer_note를 반드시 목록에서 보여 줘야 한다”는 전제로 인덱스를 확장했습니다. 운영에서는 인덱스를 손대기 전에 확인할 순서가 있습니다.
먼저 그 컬럼이 정말 목록에 필요한지 묻습니다
메모나 본문처럼 긴 컬럼은 상세 화면에서만 필요한 경우가 많습니다. 목록 쿼리에서 빼고 상세 화면을 열 때 기본 키로 한 건만 읽게 바꾸면, 인덱스를 건드리지 않고도 커버링을 유지할 수 있습니다. 배포 후 조회가 느려졌는데 검색 조건에 변화가 없다면 SELECT 목록이 늘었는지, SELECT *로 바뀌었는지부터 확인합니다.
인덱스에 넣을 수 없는 컬럼도 있습니다
추가된 컬럼이 TEXT나 BLOB이면 전체 값을 인덱스에 넣을 수 없고 접두사 길이를 지정해야 합니다. 접두사 인덱스는 값의 앞부분만 저장하므로 커버링 인덱스로 쓰이지 않습니다. 또한 DYNAMIC 행 형식에서 인덱스 키 길이는 최대 3,072바이트로 제한되어, 긴 VARCHAR 컬럼은 문자셋에 따라 아예 추가가 거부될 수 있습니다. 이런 컬럼이라면 인덱스 확장보다 쿼리에서 빼는 쪽이 현실적인 답입니다.
인덱스 확장은 쓰기 비용과 함께 따집니다
인덱스에 문자열 컬럼을 넣으면 인덱스 크기가 커지고, INSERT와 DELETE 때 유지해야 할 데이터가 늘어납니다. 해당 컬럼을 수정하는 UPDATE도 이제 인덱스까지 고쳐야 합니다. 메모처럼 자주 수정되는 컬럼이라면 읽기에서 얻은 이득을 쓰기에서 잃을 수 있습니다. 이번 실험은 인덱스 크기와 쓰기 성능을 측정하지 않았으므로, 조회 빈도, 반환 건수, 컬럼의 실제 길이, 수정 빈도를 함께 놓고 판단해야 합니다.
운영 인덱스를 바꿀 때 실제로 거친 절차
실험에서는 비교를 단순하게 하려고 기존 인덱스를 바로 교체했지만, 운영 테이블에서는 이렇게 하지 않습니다. 실제 운영에서 인덱스를 추가할 때는 다음 순서로 진행했습니다.
첫째, 해당 테이블을 사용하는 Top SQL을 모두 추출했습니다. 문제가 된 쿼리 하나만 보고 인덱스를 만들면, 같은 테이블을 쓰는 다른 서비스 쿼리의 실행계획이 바뀔 수 있습니다. 그래서 그 테이블에 접근하는 주요 쿼리를 먼저 모으고, 각 쿼리의 조건절을 모두 검토했습니다. MySQL에서는 performance_schema의 다이제스트 통계로 테이블별 주요 쿼리를 뽑을 수 있습니다.
SELECT
    SCHEMA_NAME,
    DIGEST_TEXT,
    COUNT_STAR AS exec_count,
    ROUND(SUM_TIMER_WAIT / 1000000000000, 2) AS total_sec,
    ROUND(AVG_TIMER_WAIT / 1000000000, 3) AS avg_ms,
    SUM_ROWS_EXAMINED
FROM performance_schema.events_statements_summary_by_digest
WHERE DIGEST_TEXT LIKE '%orders_cover_lab%'
ORDER BY SUM_TIMER_WAIT DESC
LIMIT 20;
둘째, 추출한 모든 쿼리의 실행계획을 검증했습니다. 새 인덱스가 생기면 옵티마이저가 다른 쿼리에서도 그 인덱스를 고를 수 있고, 그 선택이 항상 더 빠르다는 보장은 없습니다. 인덱스를 추가했을 때 다른 서비스 쿼리가 느려지면 안 되기 때문에, 모든 쿼리의 플랜을 확인한 뒤에야 운영에 인덱스를 생성했습니다.
셋째, 인덱스 생성은 최한시에 온라인 DDL로 수행했습니다. InnoDB의 ADD INDEX는 온라인 DDL로 처리되어 작업 중에도 조회와 DML을 계속 받을 수 있습니다. 그래도 인덱스를 만드는 동안 전체 데이터를 읽고 정렬하는 I/O가 발생하고, 시작과 끝에는 짧은 메타데이터 잠금이 필요합니다. 오래 열린 트랜잭션이 있으면 이 잠금을 기다리는 동안 뒤따르는 쿼리까지 대기할 수 있으므로, 액세스가 가장 적은 시간대를 골랐습니다.
이번 실험처럼 기존 인덱스를 삭제하고 새 인덱스로 교체하는 경우라면, 기존 인덱스를 쓰던 다른 쿼리가 새 인덱스로도 같은 성능을 내는지까지 확인해야 합니다. 새 인덱스가 기존 인덱스의 컬럼을 같은 순서로 앞부분에 포함하고 있다면 대부분 대체되지만, 그 판단 역시 실행계획 검증으로 확인할 일입니다.
인덱스를 탄다는 말만으로는 부족합니다
느린 쿼리를 점검할 때 실행계획에서 확인할 것은 두 가지입니다. 어떤 인덱스를 쓰는지, 그리고 그 인덱스만으로 조회가 끝나는지입니다. 트리 형식 실행계획에서는 Covering index라는 표현으로, 기존 테이블 형식에서는 Extra 컬럼의 Using index로 확인할 수 있습니다.
-- 트리 형식: "Covering index lookup" 여부 확인
EXPLAIN FORMAT=TREE
SELECT order_id, customer_id, order_date, total_amount, customer_note
FROM lab_covering_index.orders_cover_lab
WHERE customer_id = 42;

-- 테이블 형식: Extra 컬럼의 "Using index" 여부 확인
EXPLAIN
SELECT order_id, customer_id, order_date, total_amount, customer_note
FROM lab_covering_index.orders_cover_lab
WHERE customer_id = 42;
이번 실험에서 검색 조건과 반환 행 수는 끝까지 같았고, 컬럼을 추가하기 전후에는 사용하는 인덱스도 같았습니다. 달라진 것은 SELECT 목록의 컬럼 하나였고, 그 하나가 조회 경로를 “인덱스만”에서 “인덱스 + 테이블”로 바꿔 실행 시간을 열 배 넘게 늘렸습니다. 배포 후 갑자기 느려진 조회를 만났다면, 실행계획에서 인덱스 이름 옆에 Covering이라는 단어가 그대로 있는지부터 확인해 보시기 바랍니다.

댓글 0
첫 댓글을 남겨보세요.