MySQL 격리 수준별 반복 조회 결과: READ COMMITTED와 REPEATABLE READ 비교
어느 날 개발자에게서 이런 문의가 들어왔다고 해 보겠습니다.
“관리 화면에서 금액을 100에서 200으로 바꾸고 COMMIT까지 확인했습니다. 그런데 다른 화면에서는 계속 100으로 나옵니다. 같은 트랜잭션 안에서 SELECT를 다시 해도 100입니다. UPDATE가 실패한 걸까요?”
UPDATE는 성공했을 가능성이 높습니다. 다른 세션이 COMMIT했다는 사실과 지금 내 트랜잭션에서 그 변경이 보인다는 사실은 별개이기 때문입니다. 이 글은 이 문의를 MySQL 8.4.11에서 그대로 재현해 본 기록입니다. 같은 행을 두 번 읽는 동안 다른 세션이 값을 바꾸면, REPEATABLE READ에서는 100 → 100, READ COMMITTED에서는 100 → 200이 조회되었습니다.
문의를 받으면 먼저 확인하는 다섯 가지
격리 수준을 의심하기 전에 더 단순한 원인부터 지워 나갑니다. COMMIT 누락이나 다른 서버를 조회하는 실수처럼 1~2번에서 원인이 바로 드러나는 경우도 있기 때문입니다.
- UPDATE가 의도한 행을 수정했고, 영향 행 수가 0이 아니었으며, COMMIT까지 완료했는가
- 조회 연결이 같은 서버, 같은 스키마를 보고 있는가
- 조회 세션의 격리 수준은 무엇이고, 트랜잭션은 언제 시작해서 언제 끝나는가
- 조회가 일반 SELECT인가,
SELECT ... FOR UPDATE같은 잠금 읽기인가 - 읽기 복제본이나 애플리케이션 캐시를 거치는 경로인가
2·3번은 조회 세션에서 다음 SQL 하나로 확인할 수 있습니다.
SELECT
    CONNECTION_ID() AS connection_id,
    @@hostname AS server_host,
    @@port AS server_port,
    DATABASE() AS current_schema,
    @@session.transaction_isolation AS isolation_level,
    @@session.autocommit AS autocommit_setting;
autocommit이 true로 나와도 안심하면 안 됩니다. 세션이 START TRANSACTION을 직접 실행했다면 COMMIT이나 ROLLBACK을 만날 때까지 하나의 트랜잭션이 계속 열려 있습니다. 이번 재현도 바로 그 상태를 만들어 진행했습니다.
1행짜리 테이블로 문의 상황을 재현했습니다
트랜잭션의 읽기 동작만 보기 위해 데이터를 1행으로 줄였습니다. 실행 시간이나 처리량은 측정하지 않았습니다.
CREATE TABLE lab28_isolation.isolation_sample (
    id INT NOT NULL,
    amount INT NOT NULL,
    PRIMARY KEY (id)
) ENGINE = InnoDB;

-- 시작값: id = 1, amount = 100| 항목 | 조건 |
|---|---|
| MySQL 버전 | 8.4.11 |
| 스키마 / 테이블 | lab28_isolation.isolation_sample (InnoDB) |
| 데이터 | 1행, id = 1, 초기 amount = 100 |
| 세션 A (조회) | 연결 ID 9, 같은 행을 두 번 조회 |
| 세션 B (변경) | 두 조회 사이에 amount를 200으로 바꾸고 COMMIT |
| 트랜잭션 제어 | START TRANSACTION과 COMMIT을 명시적으로 실행 |
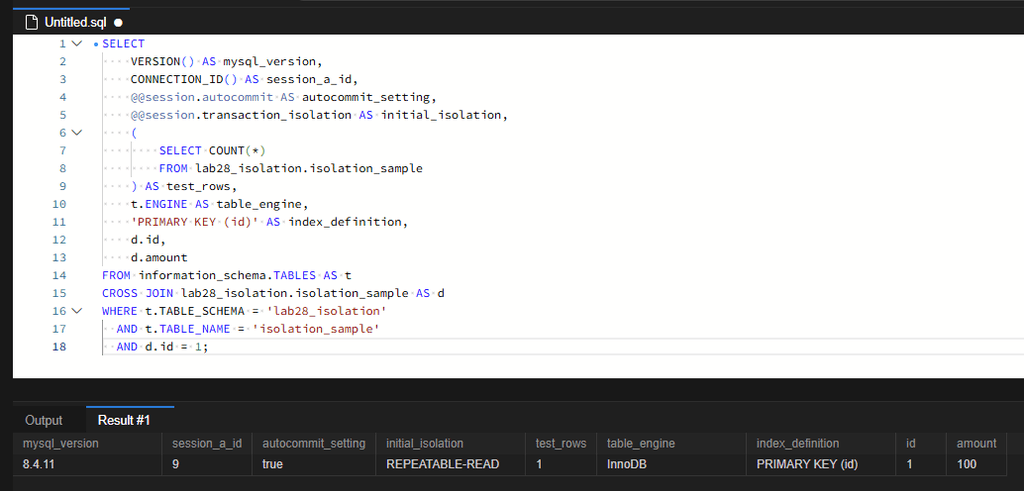
캡처의 index_definition 열은 준비한 인덱스 정의를 보여 주려고 SQL에 직접 적은 문자열입니다. 실제 인덱스 구성을 확인하려면 SHOW CREATE TABLE이나 SHOW INDEX를 사용해야 합니다.
REPEATABLE READ: 시간 순서로 본 두 세션
두 세션이 번갈아 실행한 순서를 시간축으로 정리하면 다음과 같습니다.
| 시점 | 세션 A (연결 ID 9) | 세션 B | A가 본 amount |
|---|---|---|---|
| T1 | 격리 수준 REPEATABLE READ 설정, START TRANSACTION | ||
| T2 | 첫 번째 SELECT | 100 | |
| T3 | UPDATE ... SET amount = 200 | ||
| T4 | COMMIT | ||
| T5 | 같은 SELECT 다시 실행 (트랜잭션 유지) | 100 |
T1~T2에서 세션 A가 실행한 SQL입니다. 캡처에서는 단계 구분용 test_step, 연결 ID, 격리 수준을 함께 조회했고, 데이터를 읽는 조건은 같습니다.
SET SESSION TRANSACTION ISOLATION LEVEL REPEATABLE READ;

START TRANSACTION;

SELECT id, amount
FROM lab28_isolation.isolation_sample
WHERE id = 1;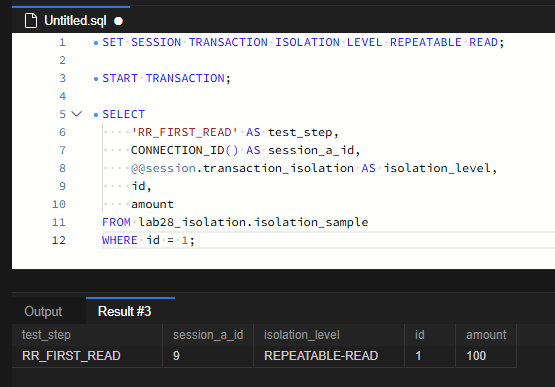
T3~T4에서 세션 B가 실행한 변경입니다.
START TRANSACTION;

UPDATE lab28_isolation.isolation_sample
SET amount = 200
WHERE id = 1;

COMMIT;
T5에서 세션 A는 트랜잭션을 끝내지 않은 채 같은 SELECT를 다시 실행했습니다.
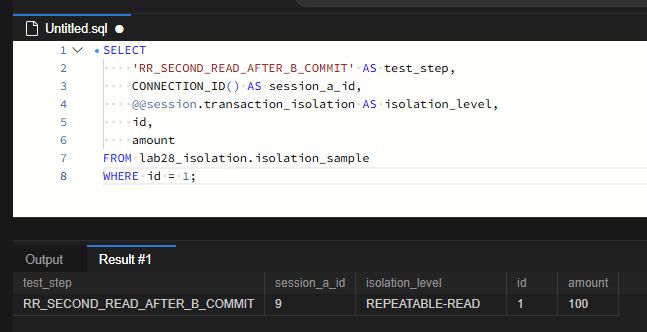
결과는 여전히 100입니다. 문의 내용과 정확히 같은 현상입니다. 세션 B의 변경이 사라진 것이 아니라, 세션 A가 T2에서 만든 스냅샷을 T5에서도 그대로 쓰고 있기 때문입니다.
한 가지 밝혀 둘 점이 있습니다. 이번 캡처에는 세션 B의 UPDATE와 COMMIT 화면이 없습니다. 캡처로 증명되는 것은 세션 A의 조회값이 100 → 100이었다는 사실까지이며, 같은 절차를 재현할 때는 세션 B의 COMMIT 완료와 변경값 200도 따로 확인해야 합니다.
READ COMMITTED: 같은 순서, 다른 결과
REPEATABLE READ 확인을 마친 뒤 세션 A의 트랜잭션을 종료하고, 세션 B에서 amount를 다시 100으로 되돌려 COMMIT했습니다. 그다음 세션 A의 격리 수준만 바꿔 같은 순서를 반복했습니다.
| 시점 | 세션 A (연결 ID 9) | 세션 B | A가 본 amount |
|---|---|---|---|
| T1 | 격리 수준 READ COMMITTED 설정, START TRANSACTION | ||
| T2 | 첫 번째 SELECT | 100 | |
| T3 | UPDATE ... SET amount = 200 | ||
| T4 | COMMIT | ||
| T5 | 같은 SELECT 다시 실행 (트랜잭션 유지) | 200 |
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;

START TRANSACTION;

SELECT id, amount
FROM lab28_isolation.isolation_sample
WHERE id = 1;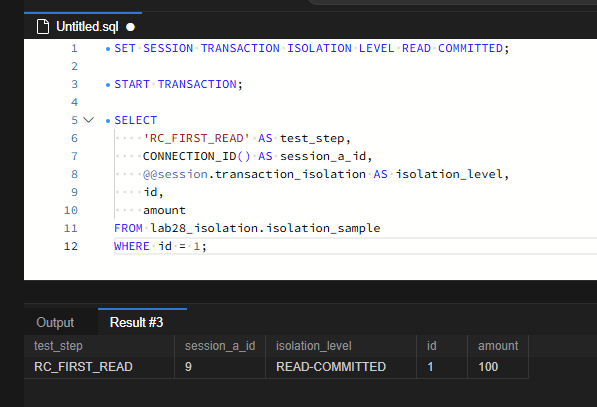
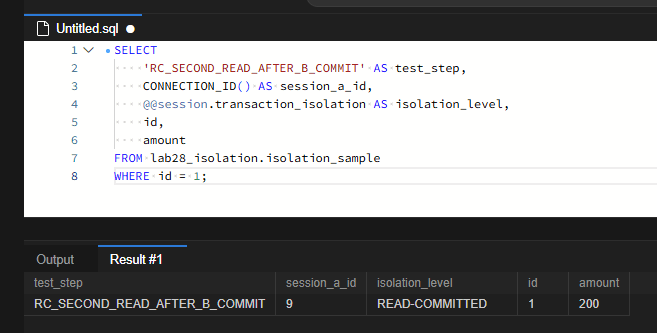
연결도, 트랜잭션도, SQL도 같은데 T5의 결과가 200으로 바뀌었습니다. READ COMMITTED에서는 SELECT를 실행할 때마다 그 시점까지 커밋된 데이터를 기준으로 새 스냅샷을 만들기 때문입니다.
결과를 가른 것은 스냅샷을 만드는 시점입니다
| 비교 항목 | REPEATABLE READ | READ COMMITTED |
|---|---|---|
| T2 첫 번째 조회 | 100 | 100 |
| T3~T4 세션 B | 200으로 변경 후 COMMIT | 200으로 변경 후 COMMIT |
| T5 두 번째 조회 | 100 | 200 |
| 일반 SELECT의 스냅샷 | 트랜잭션의 첫 일관된 읽기 때 한 번 생성 | SELECT마다 새로 생성 |
| 같은 트랜잭션 안의 반복 조회 | 값이 유지됨 | 값이 바뀔 수 있음 |
InnoDB의 일반 SELECT는 행에 잠금을 걸지 않고, 언두 로그에 남아 있는 이전 버전 중 자기 스냅샷에 맞는 버전을 골라 읽습니다. 두 격리 수준의 차이는 그 스냅샷을 언제 만드느냐뿐입니다.
REPEATABLE READ의 스냅샷 시점이 START TRANSACTION이 아니라 첫 번째 SELECT라는 점도 알아 둘 만합니다. T1과 T2 사이에 다른 세션이 COMMIT했다면 T2에서는 그 값이 보입니다. 트랜잭션 시작과 동시에 스냅샷을 고정하고 싶다면 START TRANSACTION WITH CONSISTENT SNAPSHOT을 사용합니다.
READ COMMITTED에서 값이 바뀐 현상은 커밋되지 않은 데이터를 읽는 Dirty Read가 아닙니다. 다른 트랜잭션이 커밋한 변경 때문에 같은 행의 반복 조회값이 달라지는 Non-repeatable Read입니다. 반대로 REPEATABLE READ에서 이전 값이 보였다고 해서 UPDATE 실패나 캐시 오류로 단정할 수도 없습니다.
이번 비교는 조회 세션이 일반 SELECT만 실행한 경우입니다. SELECT ... FOR UPDATE 같은 잠금 읽기나 UPDATE는 스냅샷이 아니라 최신 커밋 버전을 기준으로 동작하므로, 이 결과를 그대로 확대해 해석하면 안 됩니다.
스냅샷을 오래 붙잡으면: Aurora 리더에서 겪은 HLL 증가
REPEATABLE READ가 “처음 본 값을 끝까지 보여 주는” 대가는 이전 버전을 그만큼 오래 보관해야 한다는 것입니다. 열린 스냅샷이 필요로 하는 언두 기록은 정리(purge)할 수 없고, 정리되지 못한 기록의 양은 History List Length(HLL)로 나타납니다. 이 값이 계속 커지면 이전 버전을 따라가야 하는 조회가 느려지고 언두 공간도 늘어납니다.
실제 운영에서 이 문제를 격리 수준으로 피한 경험이 있습니다. AWS Aurora MySQL 환경에서 장시간 걸리는 롱쿼리를 Reader 인스턴스에서 실행해야 했습니다. 기본 설정 그대로 실행하면 쿼리가 도는 동안 HLL이 계속 증가해, Writer에서 처리되는 실시간 서비스 쿼리에 영향을 줄 수 있는 상황이었습니다.
그래서 롱쿼리를 실행하는 세션에서만 aurora_read_replica_read_committed = ON을 설정해 격리 수준을 READ COMMITTED로 바꾼 뒤 배치를 실행했습니다. 결과적으로 장시간 수행되는 쿼리였는데도 HLL이 증가하지 않았고, Writer의 실시간 서비스에는 전혀 영향을 주지 않았습니다.
Reader에서 돈 쿼리가 Writer에 영향을 주는 이유는 Aurora의 구조에 있습니다. Aurora는 Writer와 Reader가 같은 스토리지를 공유하므로, Reader에서 오래 열린 스냅샷이 필요로 하는 이전 버전도 클러스터 전체에서 정리되지 못합니다. AWS 문서도 쓰기가 많은 Writer와 Reader의 롱쿼리가 겹치면 purge 지연이 생기고 HLL이 높아진다고 설명합니다.
Aurora에 같은 방법을 적용할 때 알아 둘 점이 있습니다.
- Aurora Reader는 기본적으로 항상 REPEATABLE READ로 동작합니다. AWS 문서에 따르면 Reader에서 READ COMMITTED를 쓰려면 세션 수준 설정
aurora_read_replica_read_committed를 ON으로 켜야 합니다. - 이 설정에서의 READ COMMITTED는 롱쿼리에 맞춰 최적화된 Aurora 고유의 동작입니다. 하나의 롱쿼리가 시작할 때와 끝날 때 서로 다른 데이터를 볼 수 있으므로, 정확한 한 시점의 값이 필요한 쿼리에는 맞지 않습니다.
- AWS는 대량 데이터를 집계하는 분석성 쿼리를 실행하는 동안에만 이 설정을 켜는 방식을 안내합니다. 롱쿼리와 쓰기 집중 워크로드가 겹치지 않는다면 굳이 필요하지 않습니다.
-- Aurora MySQL Reader, 롱쿼리를 실행하는 세션에서만 적용
SET SESSION aurora_read_replica_read_committed = ON;
SET SESSION TRANSACTION ISOLATION LEVEL READ COMMITTED;
일반 MySQL에서는 동작이 조금 다릅니다. READ COMMITTED는 문장마다 새 스냅샷을 만들므로, 여러 SELECT로 이루어진 긴 트랜잭션에서는 오래된 스냅샷을 붙잡지 않습니다. 하지만 SELECT 한 문장이 몇 시간 동안 실행된다면 그 문장이 끝날 때까지는 스냅샷이 유지됩니다. Aurora Reader의 결과를 일반 MySQL에 그대로 옮겨 기대하면 안 되는 이유입니다.
HLL은 다음처럼 확인할 수 있습니다. Aurora라면 CloudWatch의 RollbackSegmentHistoryListLength 지표로도 추이를 볼 수 있습니다.
SELECT NAME, COUNT
FROM information_schema.INNODB_METRICS
WHERE NAME = 'trx_rseg_history_len';

-- 또는 SHOW ENGINE INNODB STATUS 출력의 History list length 항목
업무별로 무엇을 확인해야 할까
| 업무 유형 | 확인할 점 |
|---|---|
| 여러 SELECT로 한 화면이나 보고서를 구성 | 조회 사이에 값이 달라져도 되는가. 한 시점의 결과가 필요하면 REPEATABLE READ의 일관된 읽기가 맞는지 검토 |
| 조회할 때마다 최근 커밋을 반영해야 하는 화면 | READ COMMITTED가 맞는지 검토. 단, “최신”은 그 SELECT의 스냅샷 시점 기준이며 받은 뒤에도 값이 유지된다는 보장은 아님 |
| 장시간 집계·배치 조회 | 스냅샷이 오래 유지되며 HLL이 증가하지 않는지 모니터링. Aurora Reader라면 위 설정을 검토 |
| 읽은 값을 근거로 변경 (재고 차감, 잔액 변경) | 격리 수준 변경만으로는 동시성 문제가 해결되지 않음. 조건부 UPDATE, 버전 컬럼, 필요한 범위의 잠금 읽기를 검토 |
이번 실험은 일반 SELECT의 가시성만 비교했습니다. 격리 수준 변경이 잠금 대기, 교착 상태, 처리량에 주는 영향까지 측정한 것은 아닙니다.
문의한 개발자에게 보낸 답변
재현 결과를 바탕으로 처음 문의에 이렇게 답할 수 있습니다.
“UPDATE는 정상적으로 반영되었습니다. 조회하신 세션이 REPEATABLE READ에서 트랜잭션을 연 상태였기 때문에, 첫 번째 SELECT 때 만들어진 스냅샷의 값 100을 계속 보고 있었던 것입니다. 해당 트랜잭션을 COMMIT 또는 ROLLBACK으로 종료한 뒤 다시 조회하면 200이 보입니다.
화면이 조회할 때마다 최근 변경을 보여 줘야 한다면, 조회 트랜잭션을 짧게 끊거나 해당 세션만 READ COMMITTED로 운영하는 방법을 검토해 보겠습니다. 다만 격리 수준을 바꾸기 전에 그 화면이 한 시점의 일관된 결과를 필요로 하는지부터 함께 확인하면 좋겠습니다.”
이전 값이 보인다는 이유만으로 격리 수준부터 바꾸지는 않습니다. 쓰기 세션의 COMMIT 여부, 읽기 세션의 트랜잭션 경계, 그리고 업무가 원하는 것이 반복 조회의 일관성인지 조회 시점의 최신 반영인지를 차례로 확인하는 것이 이번 재현에서 얻은 판단 순서입니다.

댓글 0
첫 댓글을 남겨보세요.