EXPLAIN key에 인덱스가 찍혀도 30만 행을 읽었다: MySQL 조인 컬럼 문자셋·콜레이션 불일치
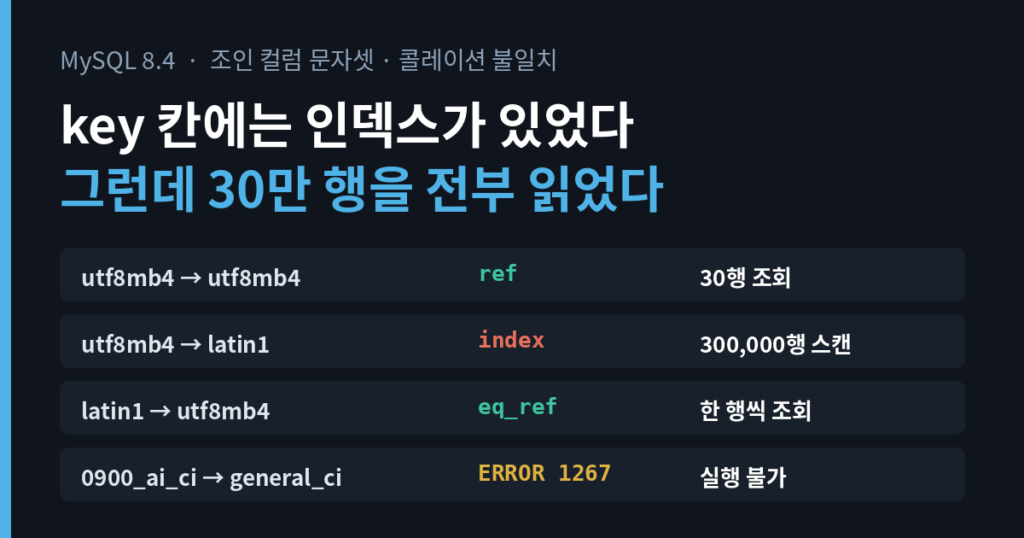
여섯 가지 조합을 먼저 표로 보면
조인 쿼리에서 Illegal mix of collations 오류를 만난 적이 있습니다. 그때는 조인 조건 컬럼에 문자셋을 맞추는 구문을 넣어 임시로 넘겼고, 나중에 컬럼 문자셋 자체를 고쳤습니다. 오류가 나면 바로 알아챌 수 있습니다. 문제는 오류 없이 실행계획만 조용히 나빠지는 조합입니다.
그래서 MySQL 8.4.11에서 조인 컬럼의 문자셋과 콜레이션을 여러 조합으로 바꿔 가며 EXPLAIN을 확인했습니다. 결과를 먼저 놓고, 예상과 다르게 나온 칸부터 차례로 들여다보겠습니다.
| TC | 조인 컬럼 조합 (먼저 읽는 쪽 → 찾아가는 쪽) | 찾아가는 쪽 type / key_len | 결과 |
|---|---|---|---|
| TC01 | utf8mb4_0900_ai_ci → utf8mb4_0900_ai_ci | ref / 82 | 인덱스로 30행씩 조회 |
| TC02 | utf8mb4_0900_ai_ci → latin1_swedish_ci | index / 22 | 인덱스 전체 30만 행 스캔 후 해시 조인 |
| TC03 | latin1_swedish_ci → utf8mb4_0900_ai_ci | eq_ref / 82 | 인덱스로 한 행씩 조회 |
| TC05 | utf8mb4_0900_ai_ci → utf8mb4_bin | ref / 82 | 오류도, 인덱스 손실도 없음 |
| TC07 | utf8mb4_0900_ai_ci → utf8mb4_general_ci | 실행 불가 | 오류 1267 |
| TC08 | TC07 + 조인 조건에 COLLATE 추가 | ref / 82 (ref=func) | 오류 해소, 인덱스 사용 |
한 줄로 요약하면 이렇습니다. 문자셋이 다르면 방향에 따라 인덱스를 못 찾아가고, 콜레이션이 다르면 조합에 따라 그냥 통과하거나 아예 실행이 막힙니다. 문자셋과 콜레이션 불일치는 같은 종류의 문제가 아니었습니다.
테스트 구성
| 항목 | 내용 |
|---|---|
| 서버 | MySQL Community Server 8.4.11, Windows, MySQL Workbench |
| 스키마 | lab_charset_join (기본 utf8mb4_0900_ai_ci) |
| 기준 테이블 | customer_master 10,000건, member_code에 UNIQUE 인덱스 |
| 로그 테이블 | api_log_same / api_log_latin1 / api_log_bin / api_log_general 각 300,000건, member_code에 보조 인덱스 |
| 데이터 분포 | member_code M000001~M010000, 회원마다 로그 30행 균등 (난수 없음, ASCII만 사용) |
| 조인 순서 | STRAIGHT_JOIN으로 고정 |
로그 30만 건은 인덱스로 수십 행을 찾는 경우와 전체를 훑는 경우의 차이가 ms 단위로 분명히 갈리면서, 노트북에서도 금방 만들어지는 크기라 골랐습니다. 네 로그 테이블은 같은 데이터를 복사했고 member_code 컬럼 정의만 다릅니다. 조인 순서를 STRAIGHT_JOIN으로 묶은 것은 방향에 따른 차이를 따로 보기 위해서입니다.
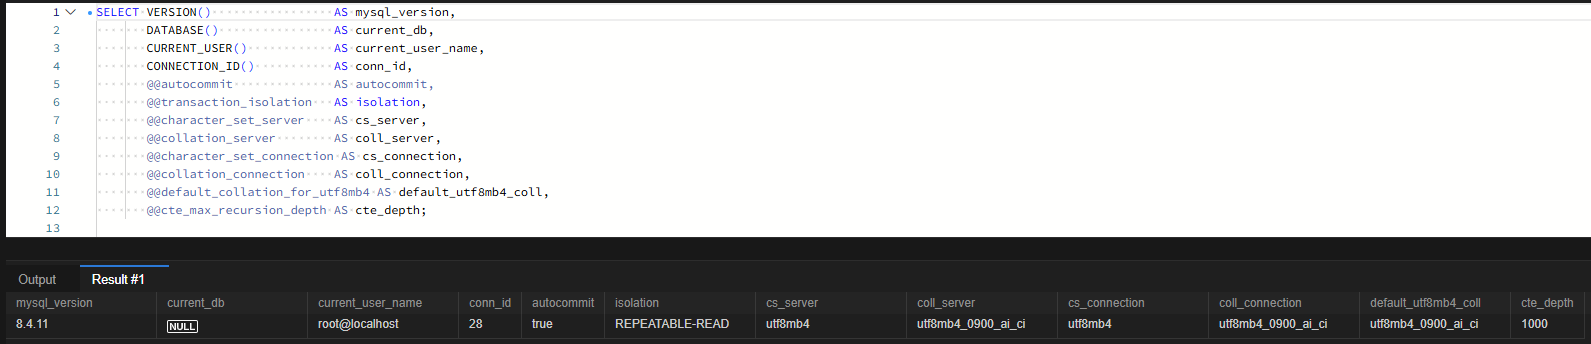
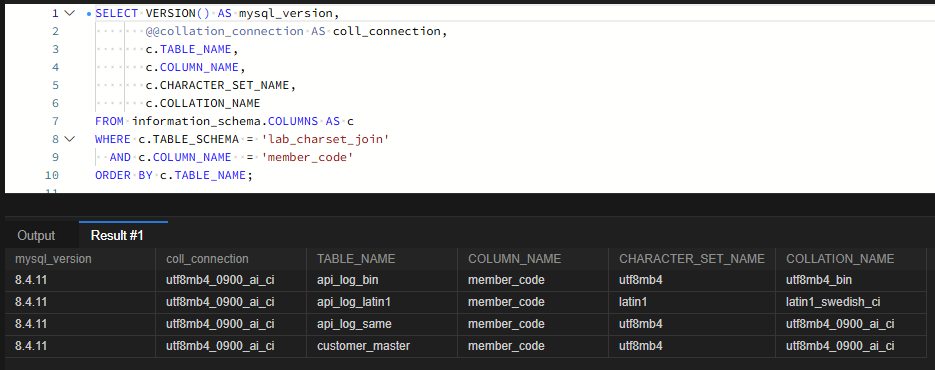
테이블과 데이터는 아래처럼 만들었습니다. api_log_latin1, api_log_bin, api_log_general은 member_code의 문자셋과 콜레이션만 바꾼 같은 구조이며, 데이터는 INSERT INTO ... SELECT * FROM api_log_same로 복사했습니다. 직접 재현했다면 확인이 끝난 뒤 DROP DATABASE lab_charset_join으로 정리하면 됩니다.
CREATE TABLE customer_master (
    customer_id  INT UNSIGNED NOT NULL,
    member_code  VARCHAR(20) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci NOT NULL,
    grade        VARCHAR(10) NOT NULL,
    PRIMARY KEY (customer_id),
    UNIQUE KEY uk_member_code (member_code)
) ENGINE=InnoDB;

CREATE TABLE api_log_latin1 (
    log_id       BIGINT UNSIGNED NOT NULL,
    member_code  VARCHAR(20) CHARACTER SET latin1 COLLATE latin1_swedish_ci NOT NULL,
    requested_at DATETIME NOT NULL,
    status_code  SMALLINT UNSIGNED NOT NULL,
    payload      VARCHAR(100) NOT NULL,
    PRIMARY KEY (log_id)
) ENGINE=InnoDB;

SET SESSION cte_max_recursion_depth = 300000;

INSERT INTO api_log_same (log_id, member_code, requested_at, status_code, payload)
WITH RECURSIVE seq (n) AS (
    SELECT 1
    UNION ALL
    SELECT n + 1 FROM seq WHERE n < 300000
)
SELECT n,
       CONCAT('M', LPAD(MOD(n - 1, 10000) + 1, 6, '0')),
       TIMESTAMPADD(SECOND, n, '2026-10-01 00:00:00'),
       ELT(MOD(n, 4) + 1, 200, 201, 404, 500),
       REPEAT('p', 100)
FROM seq;

ALTER TABLE api_log_latin1 ADD INDEX idx_member_code (member_code);
key 칸에 인덱스 이름이 있는데 30만 행을 읽은 TC02
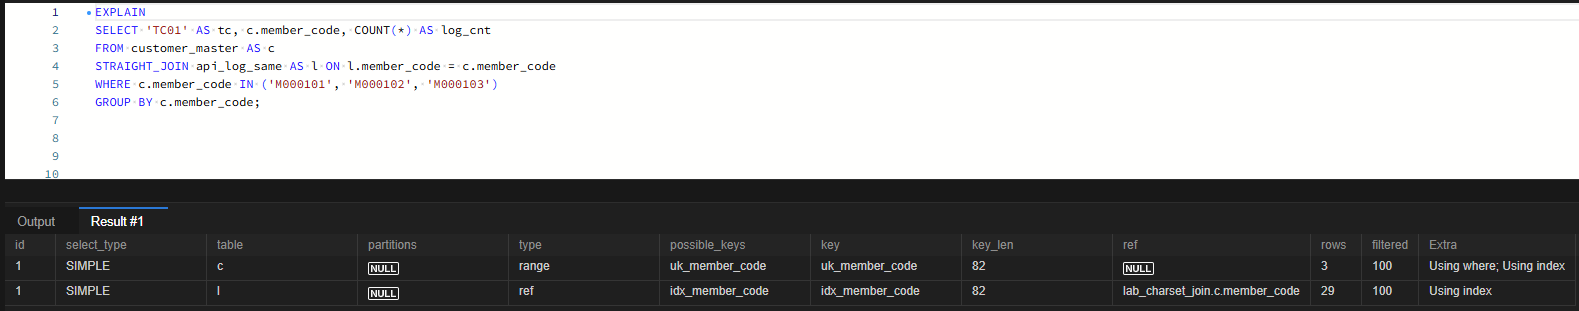
기준이 되는 TC01부터 보면, 같은 콜레이션끼리의 조인은 예상대로였습니다. 로그 테이블 쪽이 type=ref, key는 idx_member_code, 예상 rows는 29입니다.
로그 테이블만 latin1 컬럼으로 바꾼 TC02의 SQL은 TC01과 테이블 이름 하나만 다릅니다.
EXPLAIN
SELECT 'TC02' AS tc, c.member_code, COUNT(*) AS log_cnt
FROM customer_master AS c
STRAIGHT_JOIN api_log_latin1 AS l ON l.member_code = c.member_code
WHERE c.member_code IN ('M000101', 'M000102', 'M000103')
GROUP BY c.member_code;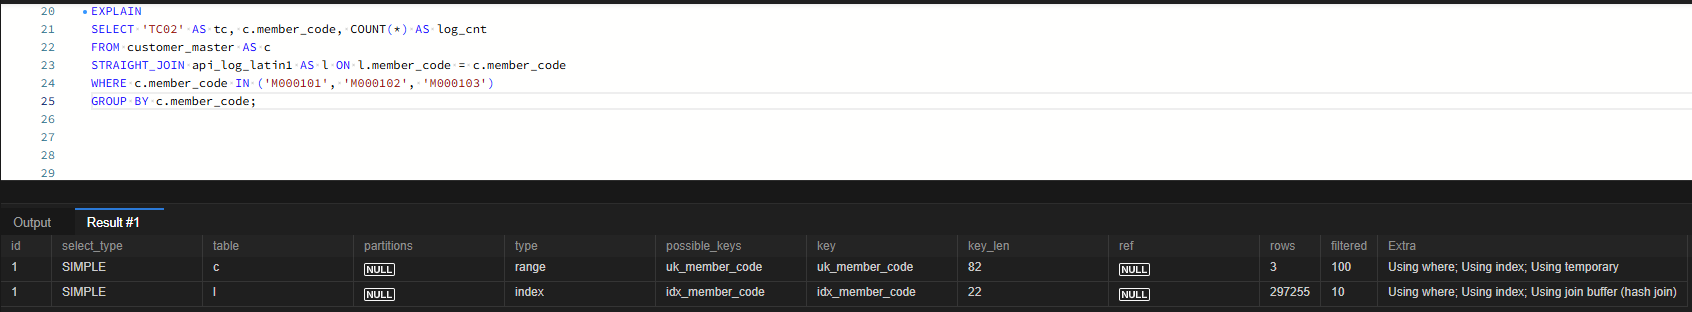
흔히 문자셋이 다르면 인덱스가 사라진다고 하는데, key 칸에는 idx_member_code가 그대로 찍혔습니다. 바뀐 것은 type입니다. ref는 인덱스에서 값을 찾아가는 접근이고, index는 인덱스를 처음부터 끝까지 읽는 접근입니다. 예상 rows도 29에서 297,255로 뛰었고, Extra에는 해시 조인이 붙었습니다. key 칸만 확인하고 넘어가면 이 차이를 놓칩니다.
key_len도 단서입니다. TC01의 82는 utf8mb4 VARCHAR(20)의 최대 길이 80바이트에 길이 정보 2바이트를 더한 값이고, TC02의 22는 latin1 VARCHAR(20)의 20바이트에 2바이트를 더한 값입니다. 숫자만 봐도 조인 상대가 다른 문자셋 인덱스라는 것을 알 수 있습니다.
-> Table scan on <temporary>  (actual time=131..131 rows=3 loops=1)
    -> Aggregate using temporary table  (actual time=131..131 rows=3 loops=1)
        -> Inner hash join (l.member_code = c.member_code)  (cost=91767 rows=89177) (actual time=1.49..131 rows=90 loops=1)
            -> Covering index scan on l using idx_member_code  (cost=1854 rows=297255) (actual time=0.503..67.5 rows=300000 loops=1)
            -> Hash
                -> Filter: (c.member_code in ('M000101','M000102','M000103'))  (cost=0.865 rows=3) (actual time=0.0459..0.0556 rows=3 loops=1)
                    -> Covering index range scan on c using uk_member_code ...  (actual time=0.0436..0.0519 rows=3 loops=1)
EXPLAIN ANALYZE로 실제 실행을 보면 고객 3명을 해시 테이블에 올린 뒤 로그 인덱스 30만 행을 모두 읽어 맞춰 봤습니다. 결과로 나온 행은 90행인데 읽은 행은 300,000행입니다. 최상단 완료 시간은 131ms로, TC01의 0.164ms와 비교됩니다.
131ms가 생각보다 크지 않은 것은 MySQL 8.4가 인덱스를 못 쓸 때 중첩 루프 대신 해시 조인을 썼기 때문입니다. 고객 3명마다 30만 행을 다시 훑는 최악의 계획은 피했지만, 읽는 양이 로그 테이블 전체 크기를 따라가는 구조는 그대로입니다. 로그가 수천만 건이면 이 차이는 그만큼 커집니다.
변환 함수는 보이지 않고 경고 1739만 남았습니다
문자셋이 다른 컬럼을 비교하면 내부에서 변환이 일어나니, 재작성된 쿼리에 convert 함수가 보일 것으로 예상했습니다. 실제로는 EXPLAIN 직후 SHOW WARNINGS의 Note 1003에도, EXPLAIN ANALYZE 트리에도 l.member_code = c.member_code만 남아 있었습니다. 원인을 알려 준 것은 경고 1739였습니다.
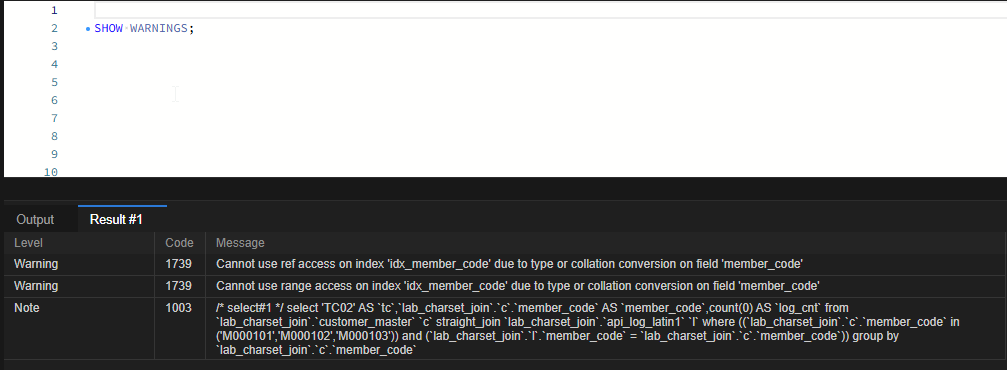
경고 문구는 Cannot use ref access on index 'idx_member_code' due to type or collation conversion on field 'member_code'이고, range access에 대해서도 같은 경고가 한 건 더 나왔습니다. 실행계획 트리만 읽어서는 원인이 드러나지 않으니, 조인에서 type이 이상하면 EXPLAIN 바로 다음에 SHOW WARNINGS를 실행하는 습관이 필요합니다.
조인 순서를 뒤집으면 인덱스가 돌아옵니다
TC03은 같은 두 테이블을 순서만 바꿨습니다. latin1 로그 테이블을 먼저 읽고 utf8mb4 고객 테이블을 찾아갑니다.
EXPLAIN
SELECT 'TC03' AS tc, l.member_code, COUNT(*) AS log_cnt
FROM api_log_latin1 AS l
STRAIGHT_JOIN customer_master AS c ON c.member_code = l.member_code
WHERE l.member_code IN ('M000101', 'M000102', 'M000103')
GROUP BY l.member_code;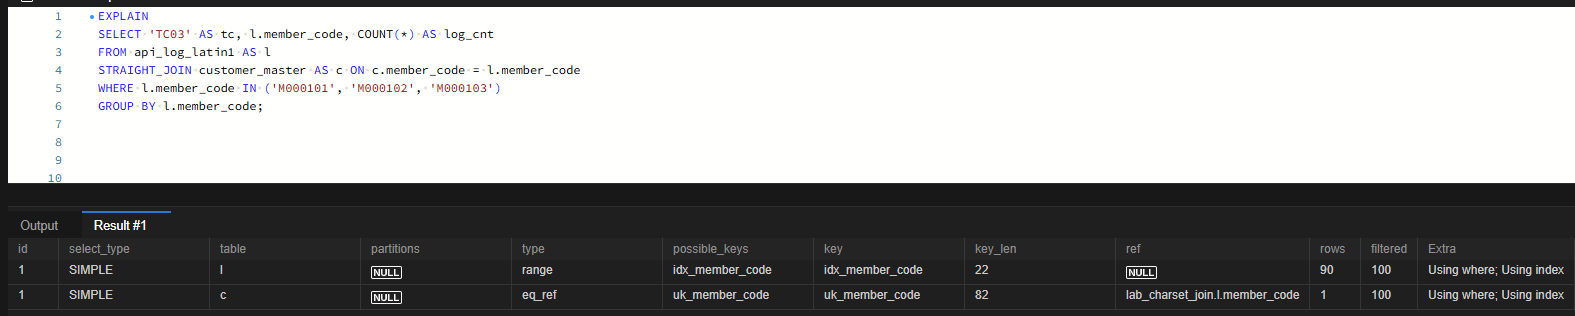
고객 테이블은 type=eq_ref로 uk_member_code를 썼고, EXPLAIN ANALYZE에서는 90번의 단건 조회로 끝났습니다. 최상단 완료 시간은 0.179ms입니다. 문자셋이 다른 같은 두 테이블인데, 방향만 바꾸자 인덱스가 돌아온 것입니다.
MySQL은 latin1과 utf8mb4를 비교할 때 더 넓은 쪽인 utf8mb4로 맞춥니다. TC03에서는 먼저 읽은 latin1 값을 utf8mb4로 바꿔 고객 인덱스를 찾으면 되니, 인덱스 쪽 컬럼은 그대로입니다. TC02에서는 찾아가야 할 대상이 latin1 인덱스였고, 그 컬럼 쪽을 변환해야 했기 때문에 인덱스에서 값을 찾아갈 수 없었습니다. “인덱스가 사라진다”는 말은 변환이 인덱스 쪽 컬럼에 걸릴 때만 맞습니다.
TC03에서도 1739 경고는 한 건 나왔습니다. 대상은 고객 쪽이 아니라 로그 쪽 idx_member_code로, 반대 방향으로는 그 인덱스를 쓸 수 없다는 뜻입니다. 지금 순서에서는 실행계획에 영향이 없었으니, 경고가 보인다고 바로 문제라고 판단하지 말고 경고가 가리키는 인덱스가 실제 계획의 어느 쪽인지 맞춰 봐야 합니다.
콜레이션 불일치는 그냥 통과하거나, 아예 막히거나
같은 utf8mb4끼리 콜레이션만 다른 두 경우는 결과가 정반대였습니다. utf8mb4_bin 로그 테이블과 조인한 TC05는 오류가 날 것이라는 예상과 달리 아무 일도 없었습니다. 로그 쪽이 type=ref, key_len 82, rows 29로 TC01과 같은 계획이었습니다. MySQL의 콜레이션 결정 규칙에서 같은 문자셋의 _bin과 _ci가 섞이면 _bin 쪽을 쓰는데, 마침 _bin이 인덱스 쪽 컬럼이라 그 인덱스를 그대로 쓸 수 있었던 것으로 보입니다.
utf8mb4_general_ci 로그 테이블과 조인한 TC07은 EXPLAIN조차 실행되지 않았습니다.
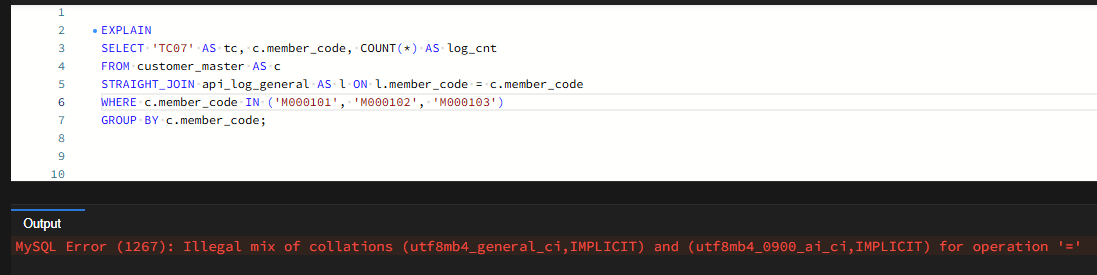
오류 메시지의 IMPLICIT는 두 값이 모두 컬럼에서 온 같은 우선순위라는 뜻입니다. 우선순위가 같고 _bin 같은 예외 규칙도 없으니 MySQL이 비교 기준을 고르지 못한 것입니다. 5.7에서 만든 general_ci 테이블과 8.0 이후 기본값인 0900_ai_ci 테이블이 섞인 환경에서 바로 이 오류를 만나게 됩니다.
운영에서 썼던 임시 조치를 그대로 재현하면
운영에서 이 오류가 났을 때 조인 조건에 맞추는 구문을 넣어 먼저 쿼리를 살렸습니다. 같은 방식을 TC08로 재현했습니다. COLLATE는 인덱스가 있는 로그 쪽이 아니라 반대편 고객 컬럼에 붙였습니다.
EXPLAIN
SELECT 'TC08' AS tc, c.member_code, COUNT(*) AS log_cnt
FROM customer_master AS c
STRAIGHT_JOIN api_log_general AS l
     ON l.member_code = c.member_code COLLATE utf8mb4_general_ci
WHERE c.member_code IN ('M000101', 'M000102', 'M000103')
GROUP BY c.member_code;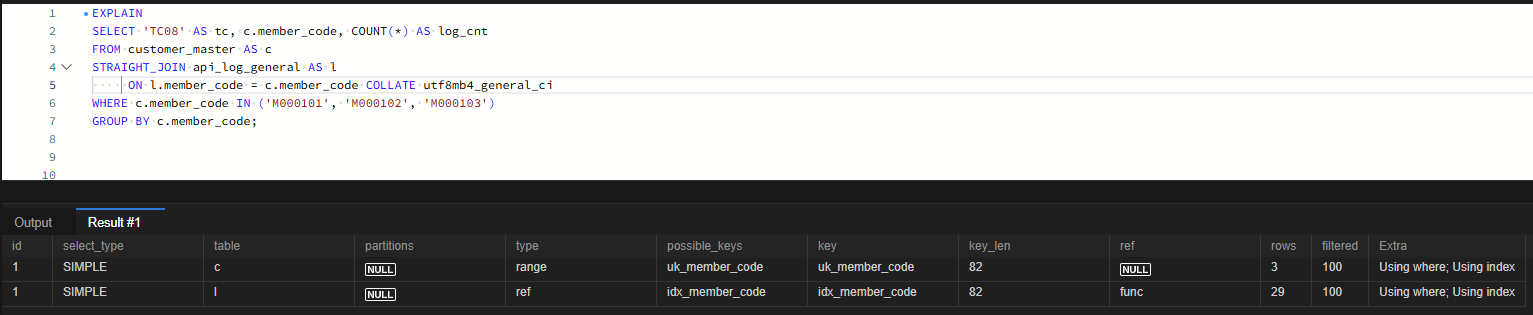
오류는 사라졌고 로그 쪽은 type=ref, key_len 82로 인덱스를 썼습니다. ref 칸이 컬럼 이름 대신 func로 바뀐 것은 고객 값을 함수로 변환한 결과로 인덱스를 찾았다는 표시입니다. 이번에는 Note 1003에도 c.member_code collate utf8mb4_general_ci로 변환 위치가 그대로 드러났습니다. TC02에서 변환이 숨어 있던 것과 다른 점입니다.
문자셋이 다른 TC02 조합에도 같은 원리가 통했습니다. 조인 조건을 l.member_code = CONVERT(c.member_code USING latin1)로 바꾼 TC04에서 로그 쪽이 ref, ref=func, key_len 22로 돌아왔습니다. 다만 latin1에 없는 문자가 고객 쪽에 있으면 변환 과정에서 다른 값으로 바뀌어 잘못 매칭될 수 있으니, 데이터가 ASCII 범위라는 확신이 있을 때만 쓸 수 있는 방법입니다.
두 경우 모두 변환을 인덱스가 없는 쪽에 붙였다는 점이 핵심입니다. 인덱스 쪽 컬럼에 COLLATE나 CONVERT를 붙이면 TC02와 같은 상황이 될 것으로 보이지만, 이 경우는 이번에 확인하지 않았습니다.
근본 조치는 컬럼 정의를 맞추는 것
운영에서도 임시 조치 뒤에는 결국 컬럼 문자셋을 수정했습니다. TC06에서 latin1 로그 컬럼을 utf8mb4_0900_ai_ci로 바꿨습니다.
ALTER TABLE api_log_latin1
  MODIFY member_code VARCHAR(20)
         CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci NOT NULL;
-- 300000 rows affected in 6.30 s

ANALYZE TABLE api_log_latin1;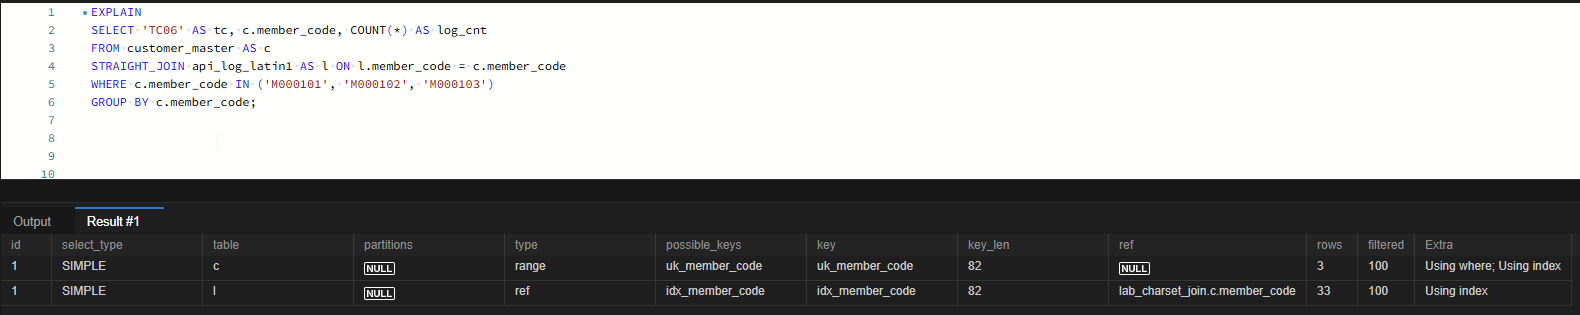
TC02와 같은 SQL이 type=ref, key_len 82로 돌아왔고, EXPLAIN ANALYZE 최상단 완료 시간은 0.138ms였습니다. 쿼리를 고치지 않아도 되고, 조인 방향을 신경 쓸 필요도 없어진다는 점에서 근본 조치입니다.
대가도 확인됐습니다. 30만 행 테이블의 컬럼 하나를 바꾸는 데 6.30초가 걸렸고 300,000행이 모두 다시 쓰였습니다. 문자셋 변경은 행 데이터를 다시 만들어야 하는 작업이라, 운영 대용량 테이블이라면 작업 중 DML이 가능한 방식인지, 복제 지연은 얼마나 생길지부터 따져 보고 시점을 정해야 합니다.
이 숫자들을 그대로 옮기기 전에
모든 TC는 STRAIGHT_JOIN으로 순서를 고정했습니다. 실제 쿼리에서는 옵티마이저가 순서를 고르므로, TC03처럼 유리한 방향을 스스로 택할 수도 있고 WHERE 조건 때문에 TC02 방향이 될 수도 있습니다. 문자셋이 다른 조인은 조건이 바뀔 때마다 계획이 흔들릴 수 있는 상태라고 보는 편이 맞습니다.
시간은 EXPLAIN ANALYZE 1회 관측값입니다. TC마다 3번 실행한 뒤 Performance Schema로 정리할 계획이었지만, Workbench에서 요약 쿼리가 바로 앞 SELECT와 한 문장으로 묶여 1064 오류가 나는 등 기록이 고르지 않아 1회 값만 썼습니다. 131ms와 0.164ms의 차이는 처리 행 수(300,000 대 90)로 설명되는 차이라서 결론이 바뀌지는 않지만, 배수 자체를 일반화할 수는 없습니다. TC04, TC05, TC07, TC08은 EXPLAIN 결과로만 판단했습니다.
볼 곳은 key 칸이 아니라 type과 경고 1739
이번에 가장 크게 남은 발견은 문자셋 불일치가 key 칸을 속인다는 점입니다. 인덱스 이름이 찍혀 있어도 type이 index라면 그 인덱스를 끝까지 읽고 있는 것입니다. 조인이 느린데 인덱스는 쓰고 있다고 나오면 아래 순서로 확인합니다.
- 찾아가는 쪽 테이블의 type이 ref나 eq_ref인지, index나 ALL인지 봅니다.
- key_len이 컬럼 정의에서 나올 값인지 봅니다. utf8mb4 VARCHAR(20)이라면 82가 나와야 하는데 22가 보이면, 그 인덱스 컬럼은 latin1처럼 다른 문자셋입니다.
- EXPLAIN 직후 SHOW WARNINGS로 1739 경고가 있는지, 경고가 가리키는 인덱스가 실제 계획의 어느 쪽인지 맞춰 봅니다.
- 두 조인 컬럼의 정의를 information_schema.COLUMNS에서 나란히 비교합니다.
4번은 스키마 전체에서 같은 이름인데 콜레이션이 다른 컬럼을 한 번에 찾는 방식으로 넓힐 수 있습니다. 아래는 이번에 캡처하지 않은 참고용 쿼리입니다.
SELECT COLUMN_NAME,
       GROUP_CONCAT(DISTINCT CONCAT(TABLE_NAME, ':', COLLATION_NAME)
                    ORDER BY TABLE_NAME SEPARATOR ', ') AS definitions
FROM information_schema.COLUMNS
WHERE TABLE_SCHEMA = 'lab_charset_join'
  AND COLLATION_NAME IS NOT NULL
GROUP BY COLUMN_NAME
HAVING COUNT(DISTINCT COLLATION_NAME) > 1;
오류 1267은 시끄럽지만 차라리 친절한 경우였습니다. 같은 불일치라도 문자셋이 다르면 쿼리는 아무 말 없이 실행되고, 실행계획의 key 칸도 정상처럼 보입니다. 운영에서 더 오래 숨어 있을 수 있는 쪽은 오류가 나지 않는 TC02 같은 경우입니다.

댓글 0
첫 댓글을 남겨보세요.