MySQL 예상 행 수와 실제 행 수가 다른 이유: EXPLAIN ANALYZE로 통계 확인
EXPLAIN ANALYZE 결과에서 옵티마이저는 약 1만 행을 예상했는데 실제로는 1,000행만 반환되는 경우가 있습니다. 이 차이를 보면 통계가 오래되었거나 인덱스가 잘못되었다고 판단하기 쉽습니다. 하지만 통계를 막 갱신한 테이블에서도 이런 차이는 생깁니다.
이 글에서는 10만 행 중 특정 값이 1%만 존재하는 편향 데이터를 직접 만들고, 히스토그램 생성 전후의 실행계획을 같은 쿼리로 비교했습니다. MySQL 8.4.11에서 Filter의 예상 행 수는 9,675행에서 967행으로 바뀌었고, 실제 행 수는 두 번 모두 1,000행이었습니다.
확인할 질문은 세 가지입니다. 9,675라는 숫자는 어디서 나왔는지, 히스토그램을 만든 뒤에도 정확히 1,000행이 아닌 이유는 무엇인지, 예상치가 맞아졌는데도 테이블 스캔이 그대로인 이유는 무엇인지입니다.
테스트 환경과 데이터 설계
비교 결과를 해석하려면 조건을 먼저 고정해야 합니다. 이번 테스트에서 바꾼 것은 status_code 히스토그램 하나뿐입니다.
| 항목 | 조건 |
|---|---|
| MySQL 버전 | 8.4.11 (Windows, MySQL Workbench) |
| 스키마 / 테이블 | stats_lab_15 / skew_orders (InnoDB) |
| 테스트 행 수 | 100,000행 |
| 데이터 분포 | status_code=0은 99,000행, 1은 1,000행 |
| 인덱스 | PRIMARY KEY(id)만 존재 |
| 비교 쿼리 | status_code=1인 행의 id, amount 조회 |
| 변경 사항 | status_code 히스토그램 생성 |
| 시간 측정 | 반복 측정과 캐시 통제 없이 단회 실행 |
데이터를 이렇게 설계한 이유가 있습니다. status_code에 인덱스를 두지 않은 것은 옵티마이저가 인덱스로 행 수를 추정하는 경로를 막기 위해서입니다. 값의 비율을 99:1로 만든 것은 “값의 종류는 2개”라는 정보만으로는 실제 분포를 알 수 없는 상황을 만들기 위해서입니다.
아래 SQL은 새 테스트 환경에서 한 번만 실행합니다. 희소 값인 1은 기본 키 순서로 100행마다 하나씩 들어갑니다.
CREATE DATABASE stats_lab_15;
USE stats_lab_15;

CREATE TABLE skew_orders (
    id INT UNSIGNED NOT NULL,
    status_code TINYINT UNSIGNED NOT NULL,
    amount INT NOT NULL,
    payload VARCHAR(100) CHARACTER SET ascii NOT NULL,
    PRIMARY KEY (id)
) ENGINE=InnoDB STATS_PERSISTENT=1;

INSERT INTO skew_orders (id, status_code, amount, payload)
WITH
digits AS (
    SELECT 0 AS d UNION ALL SELECT 1 UNION ALL SELECT 2
    UNION ALL SELECT 3 UNION ALL SELECT 4 UNION ALL SELECT 5
    UNION ALL SELECT 6 UNION ALL SELECT 7 UNION ALL SELECT 8
    UNION ALL SELECT 9
),
seq AS (
    SELECT
        a.d + 10*b.d + 100*c.d + 1000*d.d + 10000*e.d AS n
    FROM digits AS a
    CROSS JOIN digits AS b
    CROSS JOIN digits AS c
    CROSS JOIN digits AS d
    CROSS JOIN digits AS e
)
SELECT
    n + 1,
    CASE WHEN MOD(n, 100) = 0 THEN 1 ELSE 0 END,
    100 + MOD(n, 900),
    REPEAT('X', 100)
FROM seq;

COMMIT;

ANALYZE TABLE skew_orders;
마지막 줄의 일반 ANALYZE TABLE은 일부러 넣었습니다. “통계를 갱신했는데도 추정이 빗나가는” 상황을 보려면, 통계가 오래된 상태가 아니라는 점을 먼저 보장해야 하기 때문입니다.
실제 데이터 분포부터 확인합니다
실행계획을 보기 전에 데이터가 의도대로 들어갔는지 확인합니다. 이 숫자가 이후 모든 비교의 기준값이 됩니다.
SELECT
    VERSION() AS mysql_version,
    COUNT(*) AS total_rows,
    SUM(status_code = 0) AS common_rows,
    SUM(status_code = 1) AS rare_rows,
    ROUND(
        100.0 * SUM(status_code = 1) / COUNT(*),
        2
    ) AS rare_pct
FROM stats_lab_15.skew_orders;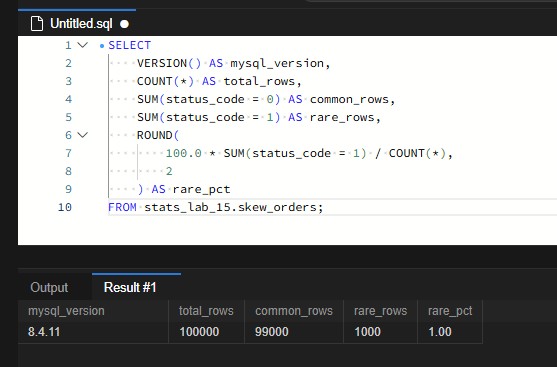
전체 100,000행 중 status_code=1은 1,000행, 비율은 정확히 1.00%입니다. 따라서 옵티마이저가 이상적으로 추정한다면 Filter 결과는 1,000행 근처여야 합니다.
히스토그램이 없을 때 EXPLAIN ANALYZE 읽기
EXPLAIN ANALYZE FORMAT=TREE
SELECT id, amount
FROM stats_lab_15.skew_orders
WHERE status_code = 1;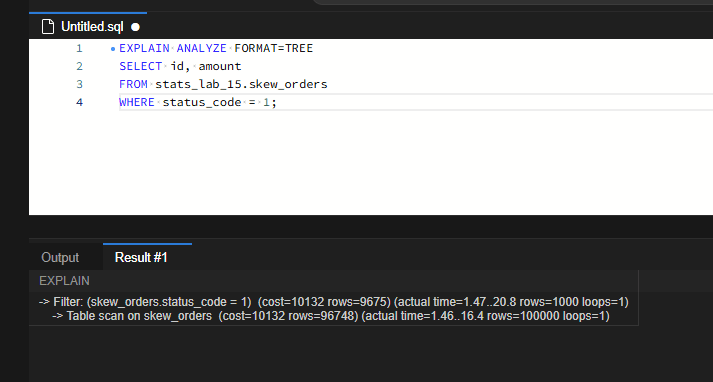
캡처의 결과를 노드별로 나누면 다음과 같습니다.
-> Filter: (skew_orders.status_code = 1)
   (cost=10132 rows=9675)
   (actual time=1.47..20.8 rows=1000 loops=1)
   -> Table scan on skew_orders
      (cost=10132 rows=96748)
      (actual time=1.46..16.4 rows=100000 loops=1)
EXPLAIN ANALYZE는 쿼리를 실제로 실행한 뒤 노드마다 두 묶음의 값을 보여줍니다. 앞쪽 괄호는 옵티마이저의 추정이고, 뒤쪽 괄호는 실제 실행 결과입니다.
| 표시 항목 | 의미 | 이번 결과에서 읽을 점 |
|---|---|---|
| cost | 비용 모델이 계산한 상대 비용 | 밀리초가 아니므로 actual time과 비교하지 않습니다. |
| rows (앞쪽) | 노드가 반환할 것으로 예상한 행 수 | Filter 9,675행 예상 |
| actual time | 첫 행 반환 시점..마지막 행 반환 시점(ms) | Filter는 20.8ms에 마지막 행 반환 |
| rows (뒤쪽) | 노드가 실제로 반환한 행 수 | Filter 1,000행 반환 |
| loops | 노드 실행 횟수 | 모두 1회이므로 행 수를 그대로 비교하면 됩니다. |
비교는 같은 노드 안에서 해야 합니다. Table scan의 100,000행과 Filter의 1,000행은 “읽은 행”과 “조건을 통과한 행”이므로 둘의 차이는 추정 오류가 아닙니다. 추정 오류는 Filter 노드 안에서 예상 9,675행과 실제 1,000행의 차이, 즉 9.675배입니다.
loops 값이 1보다 크면 rows는 1회 실행당 평균값으로 표시됩니다. 조인 쿼리에서는 rows × loops로 전체 처리량을 다시 계산해야 하므로, loops부터 확인하는 습관이 필요합니다.
9,675라는 숫자는 어디서 나왔을까요?
먼저 status_code에 대해 옵티마이저가 쓸 수 있는 정보가 무엇인지 확인합니다.
SELECT
    (
        SELECT GROUP_CONCAT(
            CONCAT(INDEX_NAME, '(', COLUMN_NAME, ')')
            ORDER BY INDEX_NAME, SEQ_IN_INDEX
            SEPARATOR ', '
        )
        FROM information_schema.statistics
        WHERE TABLE_SCHEMA = 'stats_lab_15'
          AND TABLE_NAME = 'skew_orders'
    ) AS index_columns,
    (
        SELECT COUNT(*)
        FROM information_schema.column_statistics
        WHERE SCHEMA_NAME = 'stats_lab_15'
          AND TABLE_NAME = 'skew_orders'
          AND COLUMN_NAME = 'status_code'
    ) AS histogram_count,
    COUNT(DISTINCT status_code) AS distinct_status_values
FROM stats_lab_15.skew_orders;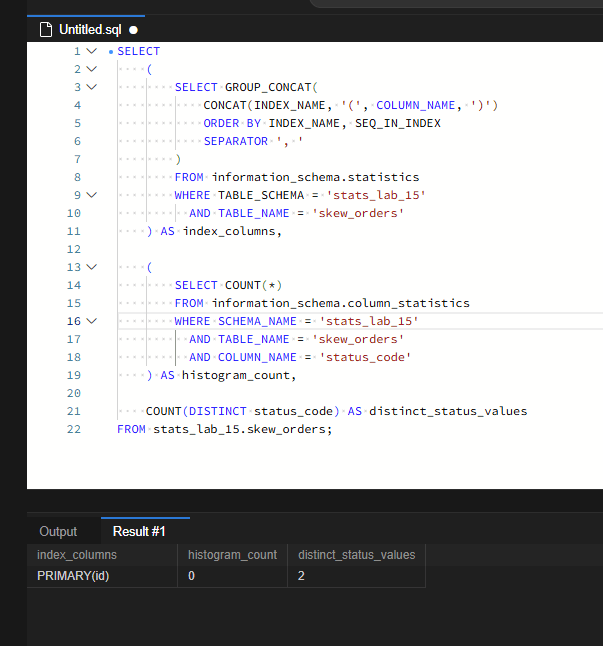
인덱스는 PRIMARY(id)뿐이고, status_code 히스토그램은 0개입니다. 여기서 histogram_count=0을 “테이블에 통계가 전혀 없다”로 읽으면 안 됩니다. 일반 ANALYZE TABLE이 수집하는 InnoDB 통계는 테이블 행 수와 인덱스 키 분포에 관한 것이고, 인덱스가 없는 컬럼의 값별 분포는 담지 않습니다. 컬럼 히스토그램은 UPDATE HISTOGRAM으로 따로 만들어야 합니다.
결국 옵티마이저는 status_code = 1이 전체 중 몇 %인지 알 방법이 없습니다. 이런 경우 MySQL은 등호 조건에 내부 기본값인 10%의 필터 비율을 적용합니다. 계산해 보면 결과와 일치합니다.
96,748(Table scan 예상 행 수) × 0.10 = 9,674.8 ≈ 9,675이 10%는 데이터와 무관한 고정값이라는 점이 핵심입니다. 실제 비율이 1%든 50%든 같은 숫자를 씁니다. 다만 범위 조건이나 LIKE 같은 다른 조건 형태는 다른 기본값을 쓰므로, 이 결과를 모든 조건에 일반화하지는 않습니다.
테이블 예상 행 수는 왜 100,000이 아니라 96,748일까요?
InnoDB는 테이블 행 수를 전부 세지 않고 일부 페이지를 샘플링해서 추정합니다. 샘플 페이지 수는 innodb_stats_persistent_sample_pages(기본 20)로 정해지므로, 막 ANALYZE TABLE을 실행한 직후에도 실제 행 수와 약간의 차이가 날 수 있습니다. 저장된 추정값은 다음 쿼리로 직접 볼 수 있습니다. 이번 글의 캡처에는 포함하지 않았으니 같은 환경에서 확인해 보시기 바랍니다.
SELECT n_rows, clustered_index_size, last_update
FROM mysql.innodb_table_stats
WHERE database_name = 'stats_lab_15'
  AND table_name = 'skew_orders';

SHOW VARIABLES LIKE 'innodb_stats_persistent_sample_pages';
이 차이는 뒤에서 히스토그램을 만든 뒤에도 예상치가 정확히 1,000행이 되지 않는 이유와 연결됩니다.
히스토그램에 99:1 분포를 담습니다
status_code의 값은 두 종류이므로 버킷 2개로 히스토그램을 만듭니다.
ANALYZE TABLE stats_lab_15.skew_orders
UPDATE HISTOGRAM ON status_code WITH 2 BUCKETS;
버킷 수는 히스토그램 유형을 결정합니다. 서로 다른 값의 개수가 버킷 수 이하이면 값마다 버킷 하나를 쓰는 singleton 유형이 되고, 값이 버킷보다 많으면 여러 값을 범위로 묶는 equi-height 유형이 됩니다. singleton은 값별 비율을 정확히 저장하므로, 이처럼 값의 종류가 적은 상태 코드 컬럼에 잘 맞습니다. 버킷을 지정하지 않으면 기본값은 100개이고 최대 1,024개까지 지정할 수 있습니다.
명령이 성공했다는 메시지만 보지 말고, 실제로 저장된 내용을 확인합니다.
SELECT
    COLUMN_NAME,
    HISTOGRAM->>'$."histogram-type"' AS histogram_type,
    HISTOGRAM->>'$."sampling-rate"' AS sampling_rate,
    HISTOGRAM->>'$."auto-update"' AS auto_update,
    JSON_LENGTH(HISTOGRAM->'$.buckets') AS bucket_count,
    HISTOGRAM->'$.buckets' AS buckets
FROM information_schema.column_statistics
WHERE SCHEMA_NAME = 'stats_lab_15'
  AND TABLE_NAME = 'skew_orders'
  AND COLUMN_NAME = 'status_code';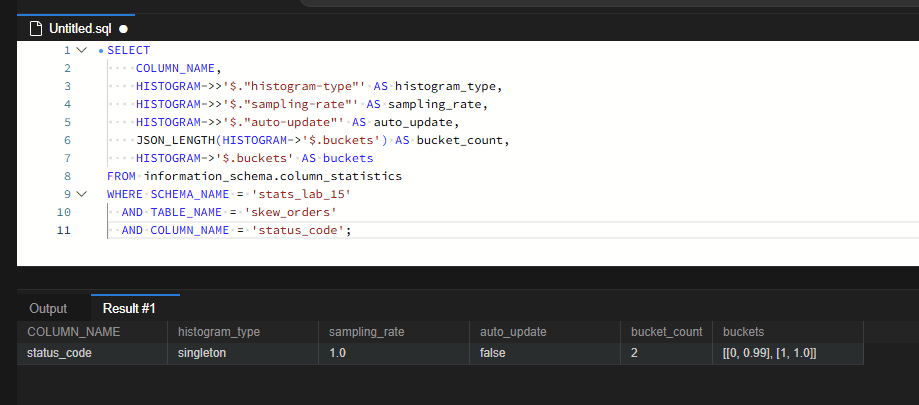
buckets 값 [[0, 0.99], [1, 1.0]]은 처음 보면 오해하기 쉽습니다. singleton 히스토그램에서 각 버킷의 두 번째 숫자는 해당 값의 비율이 아니라 누적 비율입니다.
| 버킷 | 해석 |
|---|---|
| [0, 0.99] | 값 0까지의 누적 비율이 99%입니다. |
| [1, 1.0] | 값 1까지의 누적 비율이 100%입니다. |
| 값 1의 실제 비율 | 1.0 − 0.99 = 0.01, 즉 1%입니다. |
[1, 1.0]을 “값 1이 100%”로 읽으면 히스토그램이 잘못 만들어진 것처럼 보이지만, 누적값으로 읽으면 실제 분포 99:1과 정확히 일치합니다. sampling_rate=1.0은 전체 데이터를 읽어 만들었다는 뜻이고, auto_update=false는 데이터가 바뀌어도 히스토그램이 저절로 갱신되지 않는다는 뜻입니다.
히스토그램 생성 후 같은 쿼리를 다시 실행합니다
EXPLAIN ANALYZE FORMAT=TREE
SELECT id, amount
FROM stats_lab_15.skew_orders
WHERE status_code = 1;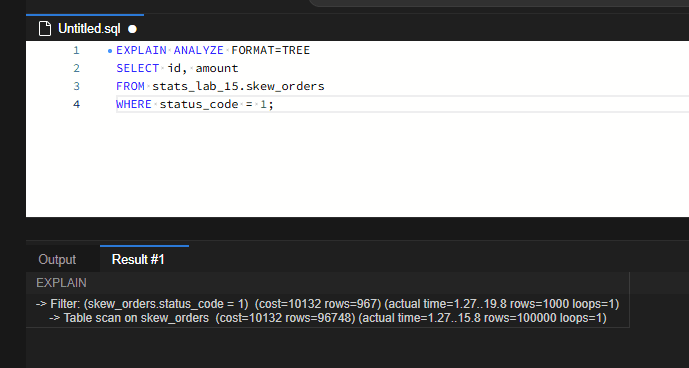
-> Filter: (skew_orders.status_code = 1)
   (cost=10132 rows=967)
   (actual time=1.27..19.8 rows=1000 loops=1)
   -> Table scan on skew_orders
      (cost=10132 rows=96748)
(actual time=1.27..15.8 rows=100000 loops=1)| 지표 | 생성 전 | 생성 후 |
|---|---|---|
| Table scan 예상 / 실제 행 수 | 96,748 / 100,000 | 96,748 / 100,000 |
| Filter 예상 행 수 | 9,675 | 967 |
| Filter 실제 행 수 | 1,000 | 1,000 |
| Filter 예상치 ÷ 실제치 | 9.675배 | 0.967배 |
| Filter 상대 오차 | 867.5% | 3.3% |
| cost | 10132 | 10132 |
| 접근 방식 | Table scan | Table scan |
| Filter 마지막 행 반환 시간 | 20.8ms | 19.8ms |
상대 오차는 |예상 행 수 − 실제 행 수| ÷ 실제 행 수 × 100으로 계산했습니다. 바뀐 값은 Filter 예상 행 수 하나이고, 나머지는 그대로입니다. 이 표에서 세 가지를 읽을 수 있습니다.
예상치가 정확히 1,000행이 아닌 이유
Filter 예상치는 “테이블 예상 행 수 × 조건 비율”로 계산됩니다. 히스토그램은 조건 비율을 10%에서 1%로 바로잡았지만, 곱하는 기준인 테이블 예상 행 수는 여전히 96,748입니다.
96,748 × 0.01 = 967.48 ≈ 967남은 3.3%의 오차는 히스토그램이 아니라 InnoDB 테이블 행 수 추정에서 온 것입니다. 실행계획의 오차를 볼 때 “전체 행 수 추정”과 “조건 선택도 추정”을 나눠서 읽어야 하는 이유가 여기에 있습니다.
cost가 10132로 그대로인 이유
Filter의 cost는 하위 Table scan의 비용을 그대로 이어받습니다. 결과가 몇 행이든 10만 행을 모두 읽고 조건을 검사하는 작업량은 같기 때문입니다. 히스토그램은 “몇 행이 나올지”에 대한 판단을 바꿨을 뿐, “어떻게 읽을지”는 바꾸지 않았습니다.
테이블 스캔이 유지된 이유
히스토그램은 값의 분포를 알려주는 통계일 뿐, status_code로 행을 찾아가는 접근 경로를 만들지 않습니다. 이 테이블에는 PRIMARY(id)만 있으므로 옵티마이저가 고를 수 있는 방법은 전체 스캔 하나뿐입니다. 실제 스캔 행 수가 두 번 모두 100,000행인 것이 이를 보여줍니다.
처리 시간이 20.8ms에서 19.8ms로 줄었지만, 단회 실행이고 캐시 상태를 통제하지 않았습니다. 같은 작업량에서 나온 1ms 차이는 측정 편차로 보는 것이 맞습니다.
단일 테이블에서 결과가 같다면 예상치 개선은 의미가 없을까요?
이번 쿼리만 보면 계획도, 읽는 행 수도 같으니 히스토그램이 효과가 없어 보입니다. 하지만 Filter의 예상 행 수는 이 테이블이 조인에 참여할 때 다음 단계로 전달되는 입력값입니다.
예를 들어 skew_orders에서 status_code=1인 행을 다른 테이블과 조인한다면, 옵티마이저는 이 테이블에서 9,675행이 나온다고 볼 때와 967행이 나온다고 볼 때 조인 순서나 방식을 다르게 계산할 수 있습니다. 특히 Nested loop 조인에서는 바깥쪽 테이블의 행 수만큼 안쪽 테이블을 반복해서 읽기 때문에, 10배 부풀려진 추정은 어느 테이블을 먼저 읽을지에 대한 판단을 흐립니다. 이번 테스트는 단일 테이블 조회만 확인했으므로 조인 계획이 실제로 바뀌는지는 별도의 실험으로 검증해야 합니다. 다만 히스토그램의 효과는 단일 테이블의 실행 시간이 아니라 상위 노드의 계획 선택에서 나타난다는 점은 알고 있어야 합니다.
예상 행 수가 틀릴 때 확인하는 순서
실행계획에서 예상과 실제가 다르면 차이가 처음 커지는 노드를 찾는 것부터 시작합니다. 원인이 노드마다 다르기 때문입니다.
| 관찰한 현상 | 우선 확인할 항목 |
|---|---|
| Table scan부터 예상 행 수가 크게 다릅니다. | 대량 데이터 변경 여부, mysql.innodb_table_stats의 n_rows와 last_update |
| 테이블 예상치는 비슷한데 Filter에서 차이가 커집니다. | 조건 컬럼의 인덱스 유무, 값 분포의 편향, 히스토그램 존재 여부 |
| 예상치는 개선되었지만 실제 읽는 행 수는 같습니다. | 인덱스와 접근 경로를 별도로 검토 |
| 조인 이후 처리 행 수가 크게 늘어납니다. | 조인 입력 노드의 추정치, 실제 행 수, loops |
| 히스토그램 생성 후에도 차이가 큽니다. | sampling_rate, 생성 이후 데이터 변경, 조건 형태, 여러 컬럼 간 상관관계 |
이번 실험은 두 번째 줄에 해당하는 사례였고, 히스토그램으로 해결된 뒤에는 세 번째 줄의 상황이 남았습니다.
히스토그램과 인덱스, 어느 쪽을 먼저 검토할까요?
두 방법은 해결하는 문제가 다릅니다. 무엇을 개선하고 싶은지에 따라 선택이 갈립니다.
| 구분 | 히스토그램 | 인덱스 |
|---|---|---|
| 개선 대상 | 행 수 추정의 정확도 | 실제로 읽는 행 수 |
| 접근 경로 | 바꾸지 않음 | 인덱스 탐색 경로 추가 |
| 쓰기 부하 | DML마다 유지 비용 없음 | INSERT·UPDATE·DELETE마다 유지 비용 발생 |
| 최신 상태 유지 | 수동 갱신 필요(8.4는 AUTO UPDATE 옵션 지원) | DML과 함께 자동 반영 |
| 잘 맞는 경우 | 인덱스를 만들기 부담스러운 편향 컬럼이 조인 계획에 영향을 줄 때 | 희소 값을 자주 조회해 스캔 비용 자체를 줄여야 할 때 |
인덱스가 있는 컬럼은 옵티마이저가 인덱스 다이브로 행 수를 직접 추정할 수 있어 히스토그램의 역할이 줄어듭니다. 그래서 히스토그램은 주로 인덱스가 없는 컬럼의 편향을 옵티마이저에 알려주는 용도로 검토합니다.
운영 테이블에 적용할 때는 세 가지를 함께 확인합니다.
- MySQL 8.4에서 UPDATE HISTOGRAM은 생략 시 MANUAL UPDATE입니다. 이번 결과도 auto_update=false였으므로, 데이터 분포가 바뀌는 컬럼이라면 같은 명령으로 다시 갱신하거나 AUTO UPDATE 옵션을 검토합니다.
- 히스토그램 생성은 대상 컬럼을 읽는 작업이므로 대형 테이블에서는 실행 시점을 고려합니다. 또한 생성에 쓰는 메모리는 histogram_generation_max_mem_size로 제한되므로, 큰 테이블에서는 전체가 아닌 일부만 샘플링될 수 있습니다. 생성 후 sampling_rate가 1.0보다 낮다면 희소 값의 비율이 실제와 다르게 저장되지 않았는지 확인합니다. 이번 10만 행 결과의 시간을 운영 테이블 작업 시간으로 쓰지 않습니다.
- EXPLAIN ANALYZE는 쿼리를 실제로 실행합니다. 무거운 쿼리를 운영 서버에서 확인할 때는 일반 EXPLAIN으로 먼저 예상치를 보고 판단합니다.
테스트 후 정리가 필요하면 다음 명령을 사용합니다. 히스토그램만 지우고 생성 전 실행계획으로 돌아가 다시 비교해 볼 수도 있습니다.
-- 히스토그램만 삭제
ANALYZE TABLE stats_lab_15.skew_orders
DROP HISTOGRAM ON status_code;

-- 테스트 스키마 전체 삭제
DROP DATABASE stats_lab_15;
이번 실험에서 Filter의 예상 행 수는 9,675행에서 967행으로 실제 1,000행에 가까워졌고, 그 원인은 10% 기본 추정이 실제 1% 분포로 바뀐 데 있었습니다. 동시에 100,000행을 모두 읽는 작업과 cost는 그대로였습니다. 예상 행 수가 틀릴 때 “통계 문제”와 “접근 경로 문제”를 분리해서 보면, 다음 조치가 히스토그램 관리인지 인덱스 설계인지 근거를 갖고 결정할 수 있습니다.

댓글 0
첫 댓글을 남겨보세요.