Undo Log 폭증으로 인한 Disk Full 방지: Purge Thread 동작 원리와 innodb_undo_tablespaces 최적화 가이드
데이터 양은 거의 그대로인데 디스크 사용률 경보가 울리는 경우가 있습니다. 테이블 크기는 정상이고, 데이터 디렉터리의 undo_001, undo_002 파일만 비정상적으로 커져 있는 상황입니다.
이런 Undo Log 폭증은 대부분 데이터 증가가 아니라 트랜잭션 관리 문제에서 시작됩니다. 커밋되지 않은 채 오래 열려 있는 트랜잭션이 자기 Undo를 계속 붙잡고, 다른 트랜잭션의 Undo까지 Purge Thread가 정리하지 못하게 막기 때문입니다.
이 글에서는 로컬 MySQL 8.4.11에서 5만 건을 변경한 트랜잭션을 커밋하지 않고 방치해 Undo Tablespace가 커지는 상황을 재현했습니다. 이어서 원인 세션을 찾고 정리하는 과정, 그리고 정리 후에도 파일 크기가 줄지 않은 이유를 확인했습니다.
이 글의 핵심 요약
- Undo는 롤백과 일관된 읽기(MVCC)를 위해 존재하며, 오래 열린 트랜잭션은 두 가지 방식으로 Undo를 붙잡아 둡니다.
- 원인 세션은 information_schema.innodb_trx에서 실행 시간이 길고 trx_query가 NULL인 트랜잭션으로 찾을 수 있습니다.
- 세션을 정리하면 History list length는 0으로 돌아오지만, Undo 파일 크기는 innodb_max_undo_log_size를 넘기 전에는 줄어들지 않습니다.
- 예방의 핵심은 대량 DML을 나눠서 커밋하는 것과, 장기 트랜잭션과 HLL을 함께 모니터링하는 것입니다.
1. 실무 장애 상황: 데이터는 그대로인데 디스크가 찬다
운영 환경에서 자주 보는 흐름은 다음과 같습니다.
| 구분 | 내용 |
|---|---|
| 발생 시점 | 새벽 배치, 대량 UPDATE/DELETE, 장시간 집계 쿼리 실행 중 |
| 관찰되는 현상 | 테이블 용량은 정상인데 undo_001, undo_002(구버전은 ibdata1) 파일이 수십~수백 GB로 증가 |
| 영향 | 디스크가 가득 차면 쓰기 작업이 실패하거나 멈추고, 상황에 따라 인스턴스가 비정상 종료될 수 있음 |
“업데이트가 많아서 그렇다”고 생각하기 쉽지만, 업데이트 양만으로는 설명되지 않는 경우가 많습니다. Undo가 쌓이는 이유는 Undo를 지울 수 없는 상태가 오래 유지되기 때문입니다.
2. 원리: MVCC, Read View와 Purge Thread의 관계
InnoDB는 MVCC(다중 버전 동시성 제어)로 동시성을 제공합니다. 행을 변경하면 변경 전 버전이 Undo Log에 기록됩니다.
text
[행 변경 시 Undo 처리 흐름]
원본 행 (데이터 페이지)
    │
    ▼  UPDATE / DELETE 발생
Undo Record 생성 (Undo Tablespace에 이전 버전 기록)
    │
    ▼  트랜잭션 커밋 + 이 버전을 참조하는 Read View가 더 이상 없음
Purge Thread가 Undo Record 정리, 공간 재사용 가능
Undo Log의 역할은 두 가지입니다.
| 역할 | 설명 |
|---|---|
| 롤백 | 트랜잭션이 실패하거나 ROLLBACK하면 이전 상태로 되돌리기 위해 사용 |
| 일관된 읽기 | 다른 세션이 데이터를 변경 중이어도, 내 Read View 시점의 데이터를 읽기 위해 사용 |
이 두 역할 때문에 오래 열린 트랜잭션은 Undo를 두 가지 방식으로 붙잡습니다.
| 구분 | 내용 | 확인 지표 |
|---|---|---|
| 자기 Undo 보유 | 커밋 전 변경분의 Undo는 롤백에 필요하므로 지울 수 없음 | innodb_trx의 trx_rows_modified, undo log entries |
| 다른 트랜잭션의 Undo 정리 지연 | 오래된 Read View가 참조할 수 있는 이전 버전은 다른 트랜잭션이 이미 커밋했어도 Purge되지 않음 | History list length (HLL) |
History list length는 “커밋은 되었지만 아직 Purge되지 않은 Undo”의 양을 보여 주는 값으로, SHOW ENGINE INNODB STATUS의 TRANSACTIONS 섹션에 표시됩니다. MySQL 매뉴얼에 따르면 평소에는 보통 수천 이하의 낮은 값이며, 쓰기가 많거나 장기 트랜잭션이 있으면 증가합니다.
3. 실습: Undo 폭증 재현부터 정상화까지
테스트 환경
| 항목 | 내용 |
|---|---|
| DBMS | MySQL Community 8.4.11 (로컬) |
| 테스트 테이블 | dba_lab.undo_test_tab (5만 건) |
| 세션 A | 대량 UPDATE 후 커밋하지 않고 방치 (Process ID 15) |
| 세션 B | 같은 테이블에 UPDATE 실행 |
| 모니터링 | 별도 세션에서 SHOW ENGINE INNODB STATUS, information_schema 조회 |
[Step 1] 사전 점검: Undo와 Purge 관련 파라미터 확인
먼저 현재 인스턴스의 Undo Tablespace 구성과 자동 Truncate 설정을 확인했습니다.
sql
SHOW VARIABLES WHERE Variable_name IN (
    'innodb_undo_tablespaces',
    'innodb_undo_log_truncate',
    'innodb_max_undo_log_size',
    'innodb_purge_rseg_truncate_frequency',
    'innodb_purge_threads',
    'innodb_max_purge_lag'
);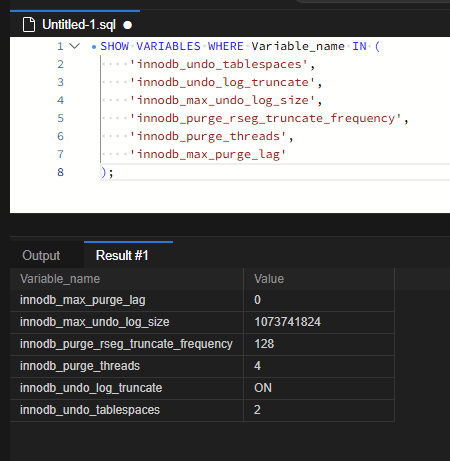
| 변수 | 값 | 의미 |
|---|---|---|
| innodb_undo_tablespaces | 2 | 기본 Undo Tablespace 2개(undo_001, undo_002) 사용 |
| innodb_undo_log_truncate | ON | 크기 기준을 넘은 Undo Tablespace를 자동으로 축소 |
| innodb_max_undo_log_size | 1073741824 (1GB) | 이 크기를 넘어야 자동 Truncate 대상이 됨 |
| innodb_purge_rseg_truncate_frequency | 128 | Purge가 128번 실행될 때마다 Truncate 대상 확인 |
| innodb_purge_threads | 4 | Purge 스레드 최대 개수 (실제 사용 수는 자동 조정) |
| innodb_max_purge_lag | 0 | Purge 지연이 커져도 DML을 늦추지 않음 (기본값) |
참고로 innodb_undo_tablespaces는 MySQL 8.0.14부터 deprecated이며 기본 2개로 고정됩니다. Undo Tablespace를 더 늘리려면 이 변수를 바꾸는 대신 CREATE UNDO TABLESPACE 문을 사용합니다. 자세한 방법은 9장에서 다룹니다.
[Step 2] 문제 재현: 미커밋 트랜잭션과 잠금 대기
세션 A에서 대량 UPDATE를 실행한 뒤 커밋하지 않고 방치했습니다. 이어서 세션 B에서 같은 테이블에 UPDATE를 실행하고, SHOW ENGINE INNODB STATUS로 상태를 확인했습니다.
sql
SHOW ENGINE INNODB STATUS;결과 중 TRANSACTIONS 섹션의 핵심 부분만 발췌하면 다음과 같습니다.
text
------------
TRANSACTIONS
------------
Trx id counter 229968
Purge done for trx's n:o < 229934 undo n:o < 0 state: running but idle
History list length 17
...
---TRANSACTION 229967, ACTIVE 44 sec starting index read
mysql tables in use 1, locked 1
LOCK WAIT 2 lock struct(s), heap size 1128, 1 row lock(s)
------- TRX HAS BEEN WAITING 44 SEC FOR THIS LOCK TO BE GRANTED:
RECORD LOCKS ... index PRIMARY of table `dba_lab`.`undo_test_tab` trx id 229967 lock_mode X waiting
...
---TRANSACTION 229964, ACTIVE 180 sec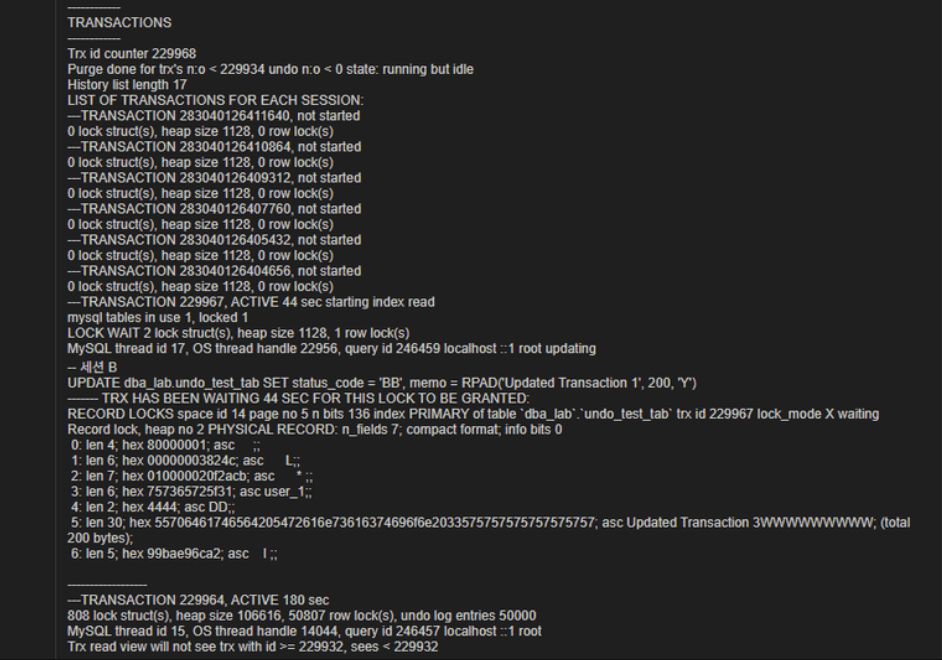
| 항목 | 관측 결과 | 해석 |
|---|---|---|
| TRANSACTION 229964 | ACTIVE 180 sec, undo log entries 50000 | 세션 A가 5만 건 변경분의 Undo를 커밋 없이 보유 |
| TRANSACTION 229967 | ACTIVE 44 sec, lock_mode X waiting | 세션 B의 UPDATE가 세션 A의 행 잠금을 44초째 대기 |
| History list length | 17 | 커밋 후 Purge를 기다리는 Undo는 적은 상태 |
| Purge 상태 | running but idle | Purge Thread가 처리할 대상이 거의 없음 |
여기서 HLL이 17에 그친 점이 중요합니다. 이번 실험에서 Undo 공간을 차지한 것은 “Purge를 기다리는 Undo”가 아니라 세션 A가 아직 커밋하지 않은 5만 건의 Undo였습니다. 커밋 전 Undo는 롤백에 필요하므로 Purge 대상이 아니며, HLL에도 포함되지 않습니다.
운영 환경에서 HLL이 수만~수십만까지 올라가는 경우는 보통 이렇습니다. 오래된 Read View를 가진 트랜잭션이 열려 있는 동안 다른 세션들이 대량 변경을 계속 커밋하는 경우입니다. 따라서 장애를 분석할 때는 장기 트랜잭션 자체의 변경량과 HLL을 함께 봐야 합니다.
[Step 3] 원인 추적: 트랜잭션을 방치한 세션 찾기
Undo를 붙잡고 있는 세션을 찾기 위해 information_schema.innodb_trx를 조회했습니다.
sql
SELECT
    trx.trx_id,
    trx.trx_state,
    trx.trx_started,
    TIMESTAMPDIFF(SECOND, trx.trx_started, NOW()) AS duration_sec,
    trx.trx_mysql_thread_id AS process_id,
    ps.user,
    ps.host,
    trx.trx_query
FROM information_schema.innodb_trx trx
JOIN information_schema.processlist ps
  ON trx.trx_mysql_thread_id = ps.id
ORDER BY trx.trx_started ASC;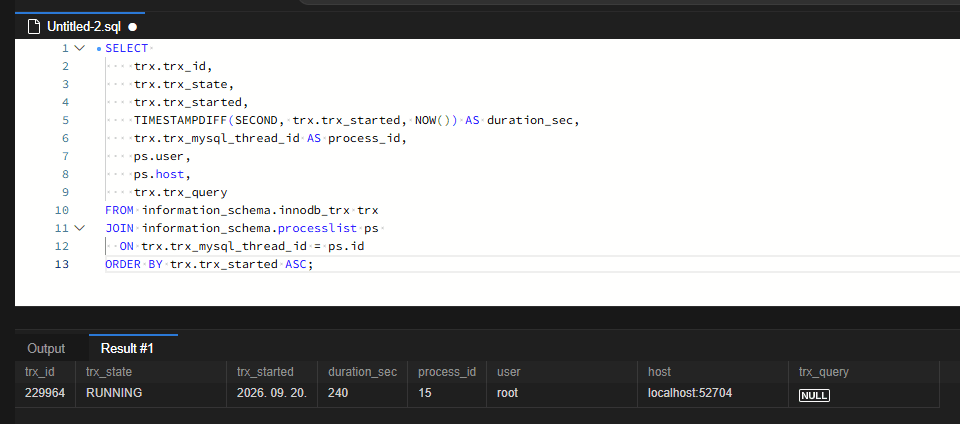
| trx_id | trx_state | duration_sec | process_id | user | trx_query |
|---|---|---|---|---|---|
| 229964 | RUNNING | 240 | 15 | root | NULL |
process_id 15 세션이 240초 동안 트랜잭션을 열어 두고 있습니다. trx_state가 RUNNING이어도 trx_query가 NULL이면, 지금 실행 중인 쿼리 없이 트랜잭션만 열려 있다는 뜻입니다. 쿼리를 실행한 뒤 COMMIT이나 ROLLBACK 없이 연결만 유지하는, 이른바 Idle in Transaction 상태입니다.
운영에서는 아래처럼 실행 시간 기준과 변경 행 수(trx_rows_modified)를 함께 보면 원인 세션을 더 빨리 좁힐 수 있습니다.
sql
SELECT
    trx.trx_mysql_thread_id AS process_id,
    TIMESTAMPDIFF(SECOND, trx.trx_started, NOW()) AS duration_sec,
    trx.trx_rows_modified,
    trx.trx_query
FROM information_schema.innodb_trx trx
WHERE trx.trx_started < NOW() - INTERVAL 60 SECOND
ORDER BY trx.trx_started;
[Step 4] 용량 점검: 커진 Undo Tablespace 확인
Undo Tablespace의 실제 파일 크기를 확인했습니다. MySQL 8.0 이상에서 information_schema.innodb_tablespaces의 이름 컬럼은 name입니다.
sql
SELECT
    name AS tablespace_name,
    ROUND(file_size / 1024 / 1024, 2) AS file_size_mb,
    ROUND(allocated_size / 1024 / 1024, 2) AS allocated_size_mb,
    state
FROM information_schema.innodb_tablespaces
WHERE name LIKE '%undo%';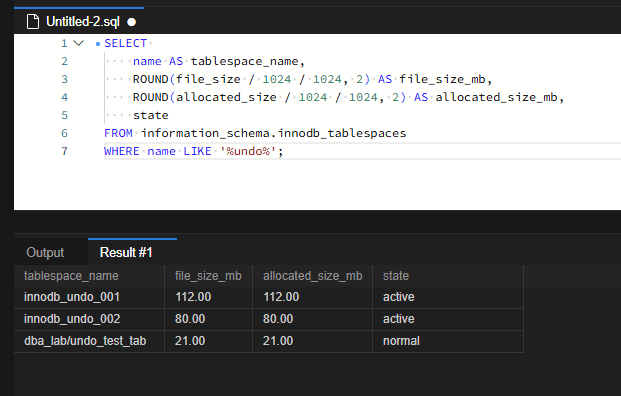
| tablespace_name | file_size_mb | allocated_size_mb | state |
|---|---|---|---|
| innodb_undo_001 | 112.00 | 112.00 | active |
| innodb_undo_002 | 80.00 | 80.00 | active |
| dba_lab/undo_test_tab | 21.00 | 21.00 | normal |
초기 크기가 보통 16MB인 Undo Tablespace가 각각 112MB, 80MB로 커졌습니다. 테스트 테이블 자체는 21MB이므로, 테이블보다 Undo 공간이 훨씬 더 커진 셈입니다.
세 번째 행은 Undo가 아니라 테스트 테이블의 테이블스페이스입니다. 테이블 이름에 undo가 들어 있어 LIKE 조건에 함께 걸렸습니다. Undo만 보려면 조건을 WHERE name LIKE ‘innodb_undo%’처럼 좁히면 됩니다. 다만 CREATE UNDO TABLESPACE로 직접 만든 Undo Tablespace는 이름이 다를 수 있으니 함께 확인해야 합니다.
5만 건 테스트에서는 수백 MB 수준이지만, 수천만 건 배치가 같은 방식으로 방치되면 수십~수백 GB까지 커질 수 있습니다.
[Step 5] 조치: 원인 세션 정리와 HLL 확인
원인 세션(Process ID 15)을 정리했습니다. 해당 작업을 반영해야 한다면 그 세션에서 COMMIT하고, 반영하지 않아도 된다면 KILL로 종료합니다.
sql
-- 원인 세션 강제 종료 (진행 중인 트랜잭션은 롤백됨)
KILL 15;

-- History list length 다시 확인
SHOW ENGINE INNODB STATUS;
KILL로 종료하면 커밋이 아니라 롤백이 일어납니다. 변경량이 큰 트랜잭션은 롤백에도 시간이 걸리므로, 운영에서는 롤백이 끝날 때까지 innodb_trx에서 trx_state가 ROLLING BACK인지 확인해야 합니다.
정리 후 결과는 다음과 같습니다.
text
------------
TRANSACTIONS
------------
Trx id counter 229969
Purge done for trx's n:o < 229969 undo n:o < 0 state: running but idle
History list length 0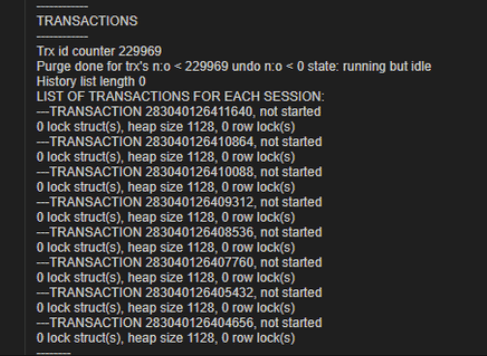
| 항목 | 정리 전 | 정리 후 |
|---|---|---|
| History list length | 17 | 0 |
| Purge done for trx’s n:o < | 229934 | 229969 (Trx id counter와 같음) |
Purge 완료 지점이 현재 트랜잭션 번호(Trx id counter)까지 따라왔습니다. 정리할 Undo가 더 남아 있지 않다는 뜻입니다.
[Step 6] 심화 분석: 파일 크기는 왜 112MB 그대로일까
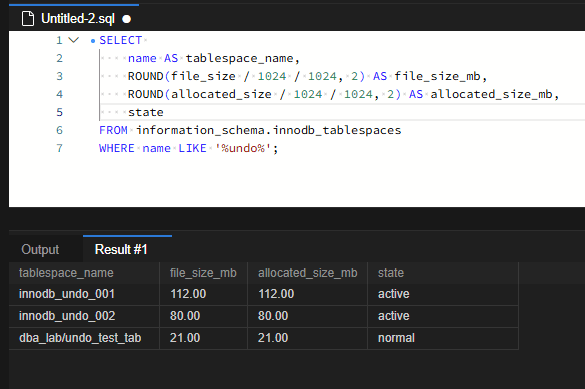
세션을 정리한 직후 information_schema.innodb_tablespaces를 다시 조회했습니다.
| tablespace_name | file_size_mb | state |
|---|---|---|
| innodb_undo_001 | 112.00 | active |
| innodb_undo_002 | 80.00 | active |
HLL은 0이 되었지만 innodb_undo_001은 여전히 112MB입니다. 이유는 innodb_max_undo_log_size가 1GB이기 때문입니다.
자동 Truncate는 다음 순서로 진행됩니다.
- innodb_max_undo_log_size를 넘은 Undo Tablespace가 Truncate 대상으로 선택됩니다.
- 해당 Tablespace의 롤백 세그먼트를 비활성화해 새 트랜잭션이 쓰지 못하게 합니다.
- Purge가 그 안의 Undo를 모두 비웁니다.
- 파일을 16MB로 줄인 뒤 다시 활성화합니다.
즉, 파일 안의 공간은 이미 비워져 다시 쓸 수 있는 상태입니다. 하지만 운영체제 수준에서 파일 크기를 줄이는 작업은 1GB 기준을 넘었을 때만 실행됩니다. 디스크 사용량 그래프만 보면 “정리가 안 됐다”고 오해하기 쉬운 부분입니다.
수동으로 줄이는 방법도 있습니다. 다만 수동 Truncate는 활성 Undo Tablespace가 3개 이상일 때만 가능하므로, 기본 구성(2개)에서는 먼저 Undo Tablespace를 하나 추가해야 합니다.
sql
-- 1) Undo Tablespace 추가 (확장자는 .ibu)
CREATE UNDO TABLESPACE undo_003 ADD DATAFILE 'undo_003.ibu';

-- 2) 줄이려는 Undo Tablespace를 비활성화
ALTER UNDO TABLESPACE innodb_undo_001 SET INACTIVE;

-- 3) state가 empty로 바뀌었는지 확인
SELECT name, state
FROM information_schema.innodb_tablespaces
WHERE name = 'innodb_undo_001';

-- 4) 다시 활성화
ALTER UNDO TABLESPACE innodb_undo_001 SET ACTIVE;
비활성화한 Undo Tablespace는 사용 중인 트랜잭션이 모두 끝나고 Purge가 비워야 empty 상태가 되며, 그때 초기 크기로 줄어듭니다. 운영에서는 장기 트랜잭션이 없는 시간대에 진행하는 것이 좋습니다.
4. 운영 가이드: Undo Log 폭증을 막는 4가지 원칙
1) 대용량 DML은 나눠서 커밋하기
수십만~수백만 건을 한 번에 UPDATE/DELETE하면 하나의 트랜잭션이 그만큼의 Undo를 커밋 전까지 모두 보유합니다. PK 범위를 기준으로 1,000~5,000건 정도씩 나눠 커밋하면, 커밋된 구간의 Undo는 Purge가 중간중간 정리할 수 있습니다.
sql
-- PK 범위 기준 분할 예시 (애플리케이션이나 프로시저에서 범위를 바꿔 가며 반복)
START TRANSACTION;
UPDATE dba_lab.undo_test_tab
SET status_code = 'BB'
WHERE id BETWEEN 1 AND 5000;
COMMIT;
LIMIT만으로 나누는 방식은 매번 같은 범위를 다시 스캔할 수 있습니다. 그래서 PK 범위로 나누는 쪽이 더 안정적입니다.
2) Undo Truncate 기준 조정하기
디스크 여유가 적은 서버라면 기본 1GB 기준을 낮춰 파일 반환을 더 빨리 일어나게 할 수 있습니다. 아래 변수들은 운영 중에 동적으로 변경할 수 있습니다.
sql
SET GLOBAL innodb_undo_log_truncate = ON;
SET GLOBAL innodb_max_undo_log_size = 536870912;  -- 512MB
기준을 너무 낮게 잡으면 Truncate가 자주 일어나 그만큼 부하가 생깁니다. 평소 Undo 사용량을 보고 정하는 것이 좋습니다. innodb_purge_rseg_truncate_frequency를 낮추면 Truncate 대상 확인을 더 자주 하지만, 효과는 크기 기준 조정보다 작습니다. 이 변수는 버전에 따라 상태가 바뀔 수 있으니 적용 전에 사용 중인 버전의 매뉴얼을 확인하세요.
3) HLL과 장기 트랜잭션을 함께 모니터링하기
Undo 파일 크기만 보면 디스크가 이미 찬 뒤에 대응하게 됩니다. HLL과 장기 트랜잭션을 함께 수집하는 것이 선제 대응에 유리합니다.
sql
-- HLL을 SQL로 조회 (STATUS가 enabled인지 확인)
SELECT name, count, status
FROM information_schema.innodb_metrics
WHERE name = 'trx_rseg_history_len';| 단계 | 기준 예시 | 조치 |
|---|---|---|
| 경고 | HLL 50,000 초과 또는 60초 이상 트랜잭션 존재 | innodb_trx로 장기 트랜잭션 확인 |
| 심각 | HLL 100,000 초과 또는 계속 증가 | 원인 세션 확인 후 COMMIT 또는 종료 검토 |
위 수치는 예시입니다. 평소 HLL 값을 일정 기간 수집한 뒤 서비스에 맞게 조정해야 합니다.
4) 애플리케이션의 트랜잭션 종료 보장하기
autocommit=0 환경이나 프레임워크 트랜잭션에서 커밋이나 롤백이 누락된 채 커넥션이 재사용되면, 이번 실습의 process_id 15 같은 트랜잭션이 남을 수 있습니다.
MySQL에는 “트랜잭션을 연 채 쉬고 있는 세션”만 골라 끊는 전용 타임아웃이 없습니다. wait_timeout은 유휴 연결 전체에 적용되는 값이라 커넥션 풀과 충돌할 수 있습니다. 따라서 다음 세 가지를 함께 적용하는 것이 현실적입니다.
- 애플리케이션 쪽에서 트랜잭션 타임아웃을 설정합니다.
- 커넥션을 풀에 반환할 때 미완료 트랜잭션이 롤백되는지 확인합니다.
- 3)의 장기 트랜잭션 모니터링으로 누락을 잡아냅니다.
5. 자주 묻는 질문
Q. 세션을 정리했는데 Undo 파일이 줄지 않습니다. 정상인가요?
A. 정상입니다. 내부 공간은 비워져 재사용되지만, 파일 자체는 innodb_max_undo_log_size를 넘어야 자동으로 16MB로 줄어듭니다. 바로 줄이려면 9장의 수동 Truncate 절차를 사용합니다.
Q. HLL이 낮은데도 Undo가 커질 수 있나요?
A. 가능합니다. 이번 실험처럼 커밋하지 않은 대량 변경의 Undo는 HLL에 포함되지 않습니다. innodb_trx의 trx_rows_modified와 실행 시간을 함께 확인해야 합니다.
Q. innodb_undo_tablespaces 값을 늘리면 Undo 폭증을 막을 수 있나요?
A. 아닙니다. 이 변수는 MySQL 8.0.14부터 deprecated입니다. Undo Tablespace 개수를 늘려도 장기 트랜잭션이 Undo를 붙잡는 문제는 그대로 남습니다. 다만 Tablespace가 3개 이상이면 수동 Truncate를 쓸 수 있다는 운영상의 이점은 있습니다.
6. 정리: Undo 폭증을 막는 운영 체크리스트
Undo Log는 롤백과 일관된 읽기를 보장하는 필수 장치이지만, 관리하지 않으면 디스크 전체를 위협할 수 있습니다.
- Undo 폭증의 본질은 데이터 증가가 아니라, 오래 열린 트랜잭션이 Undo를 정리할 수 없게 붙잡는 것입니다.
- 세션을 정리하면 HLL은 바로 돌아오지만, 파일 크기는 Truncate 조건을 만족해야 줄어듭니다.
- 대량 DML 분할 커밋, 그리고 장기 트랜잭션과 HLL의 함께 모니터링이 Disk Full 장애를 막는 가장 확실한 기본기입니다.

댓글 0
첫 댓글을 남겨보세요.