MySQL Derived Table·CTE 최적화: MERGE와 NO_MERGE 실행계획·메모리 비교
서브쿼리를 WITH 절로 바꾸면 SQL을 읽기는 편해집니다. 그러나 가독성이 좋아졌다는 이유만으로 실행 시간까지 줄어드는 것은 아닙니다. MySQL에서는 Derived Table과 CTE를 바깥 쿼리에 병합할 수도 있고, 중간 결과를 내부 임시 테이블로 구체화할 수도 있습니다.
이번에는 로컬 MySQL 8.4에서 고객 1만 건과 주문 30만 건을 준비하고, 서울 고객의 결제 완료 주문을 집계했습니다. 같은 조회를 Derived Table과 CTE로 각각 작성한 뒤 MERGE와 NO_MERGE 힌트로 실행계획을 비교했습니다.
확인할 핵심은 SQL 문법의 길이가 아닙니다. 서울 고객 100명에 필요한 주문부터 찾는지, 전체 결제 완료 주문 22만 5천 건을 먼저 만들어 놓는지가 이번 성능 차이를 설명합니다.
실무 문제: 일부 고객을 조회하는데 중간 결과가 지나치게 큽니다
비교 SQL의 업무 의미는 동일합니다. 서울 고객의 결제 완료 주문 건수와 금액 합계를 계산합니다.
| 항목 | 테스트 구성 |
|---|---|
| DBMS | 로컬 MySQL 8.4 |
| 고객 테이블 | customers_merge_lab, 10,000행 |
| 주문 테이블 | orders_merge_lab, 300,000행 |
| 서울 고객 | 100명 |
| 전체 PAID 주문 | 225,000행 |
| 조인 결과 | 3,000행 |
| 최종 집계 결과 | COUNT·SUM을 담은 1행 |
| 고객 인덱스 | idx_region_customer(region, customer_id) |
| 주문 인덱스 | idx_status_customer(order_status, customer_id), idx_customer_status(customer_id, order_status) |
테스트 데이터는 규칙적으로 생성한 합성 데이터입니다. 생성 규칙상 서울 고객의 주문은 모두 PAID에 해당합니다. 실제 서비스처럼 지역과 주문 상태가 다양하게 섞인 분포를 대표하지는 않습니다.
이 글의 수치는 직접 실행한 캡처에서 확인한 값입니다. 단일 실행 측정이므로 반복 측정 평균이나 운영 환경의 개선 보장 수치로 해석하지 않습니다.
원인 분석: 병합과 구체화가 처리 범위를 바꿉니다
MERGE는 파생 테이블이나 병합 가능한 CTE를 바깥 쿼리 블록에 통합하도록 유도합니다. 옵티마이저는 통합된 구조에서 조인 순서와 인덱스 접근을 선택할 수 있습니다.
NO_MERGE는 병합을 막습니다. 이번 쿼리에서는 내부 결과를 구체화하는 Materialize 단계가 나타났습니다. MySQL은 필요한 시점까지 구체화를 지연하거나 구체화된 결과에 인덱스를 추가할 수도 있으므로, NO_MERGE를 항상 단순 전체 스캔으로 이해하면 안 됩니다. MySQL 파생 테이블·CTE 최적화 문서
이번 실험에서 내부 조건은 order_status = 'PAID'입니다. 지역 조건은 고객 테이블의 c.region = 'SEOUL'에 있습니다. 병합 여부에 따라 고객을 먼저 좁혀 주문을 찾을 수 있는지, 넓은 주문 집합을 먼저 구체화하는지가 달라집니다.
Derived Table: MERGE에서는 필요한 주문을 직접 조회합니다
EXPLAIN ANALYZE FORMAT=TREE
SELECT /*+ MERGE(dt) */
       COUNT(*) AS order_count,
       SUM(dt.amount) AS total_amount
FROM customers_merge_lab c
JOIN (
    SELECT order_id, customer_id, amount
    FROM orders_merge_lab
    WHERE order_status = 'PAID'
) AS dt
  ON dt.customer_id = c.customer_id
WHERE c.region = 'SEOUL';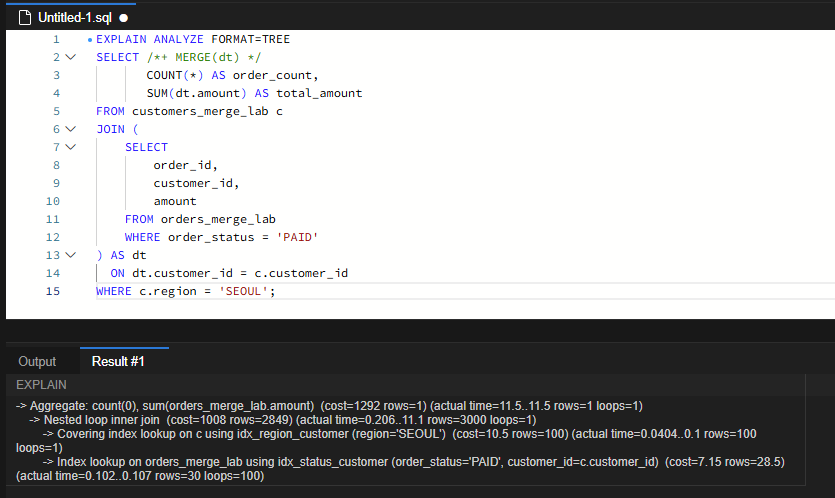
실행계획에는 별도의 Materialize 노드가 없습니다. 고객 테이블에서는 idx_region_customer를 이용한 Covering index lookup이 실행됐고, 실제 100행을 반환했습니다.
주문 테이블에서는 idx_status_customer를 사용했습니다. 탐색 조건에는 order_status='PAID'와 고객 번호가 함께 들어 있습니다. 두 컬럼 모두 동등 조건이므로, 상태가 선두인 복합 인덱스로도 해당 고객의 PAID 주문을 찾을 수 있습니다.
주문 조회 노드의 값은 rows=30 loops=100입니다. 이 경우 rows는 루프당 평균이므로 총 3,000행이 조인으로 전달된 것으로 읽습니다. 상위 Nested loop 노드에서도 실제 3,000행이 확인됩니다.
최상위 Aggregate 노드의 완료 시간은 11.5ms이며 반환 행 수는 1입니다. 주문 3,000건을 집계해 건수와 합계를 하나의 결과 행으로 반환했기 때문입니다.
Derived Table: NO_MERGE에서는 22만 5천 행을 구체화합니다
같은 SQL에서 힌트만 바꿉니다.
EXPLAIN ANALYZE FORMAT=TREE
SELECT /*+ NO_MERGE(dt) */
       COUNT(*) AS order_count,
       SUM(dt.amount) AS total_amount
FROM customers_merge_lab c
JOIN (
    SELECT order_id, customer_id, amount
    FROM orders_merge_lab
    WHERE order_status = 'PAID'
) AS dt
  ON dt.customer_id = c.customer_id
WHERE c.region = 'SEOUL';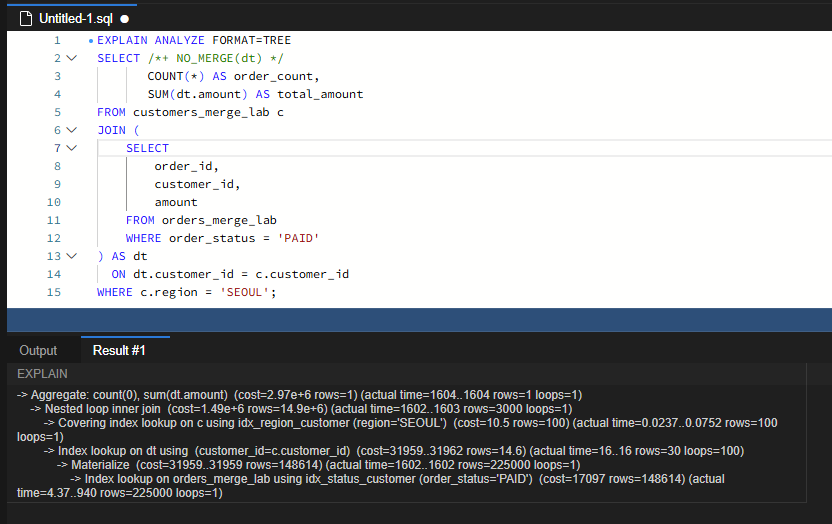
이 플랜에도 서울 고객을 찾는 인덱스 조회가 있습니다. 차이는 주문을 가져오는 방식입니다. 원본 주문 테이블에서 PAID 주문을 조회하는 노드 아래에 rows=225000 loops=1이 나타나고, 이를 받는 Materialize 노드도 225,000행을 출력합니다.
| 노드 | 마지막 행까지의 actual time | 실제 행 수·반복 |
|---|---|---|
| PAID 주문 인덱스 조회 | 940ms | rows=225000, loops=1 |
| Materialize | 1,602ms | rows=225000, loops=1 |
| 최상위 Aggregate | 1,604ms | rows=1, loops=1 |
Materialize의 시간에는 하위 노드 작업이 포함됩니다. 따라서 940ms와 1,602ms를 더해서 전체 실행 시간을 계산하면 안 됩니다.
구체화된 dt를 고객 번호로 조회하는 노드는 100번 실행되지만, 구체화 자체의 loops는 1입니다. 225,000행을 고객마다 반복해서 생성한 계획은 아닙니다.
최종 조인 결과는 MERGE와 동일한 3,000행입니다. 하지만 필요한 고객의 주문만 조회하던 계획에 비해 훨씬 큰 중간 결과를 만들었습니다. 이번 플랜의 완료 시간은 11.5ms에서 1,604ms로 증가했습니다.
CTE로 바꿔도 병합 여부에 따른 차이가 유지됩니다
MERGE를 적용한 CTE입니다
EXPLAIN ANALYZE FORMAT=TREE
WITH paid_orders AS (
    SELECT order_id, customer_id, amount
    FROM orders_merge_lab
    WHERE order_status = 'PAID'
)
SELECT /*+ MERGE(paid_orders) */
       COUNT(*) AS order_count,
       SUM(paid_orders.amount) AS total_amount
FROM customers_merge_lab c
JOIN paid_orders
  ON paid_orders.customer_id = c.customer_id
WHERE c.region = 'SEOUL';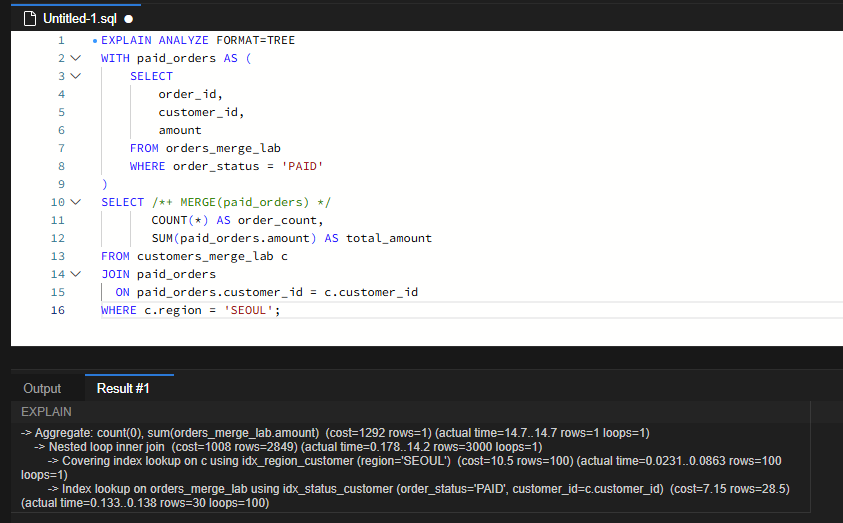
고객 인덱스로 100명을 조회하고, 주문 인덱스를 고객별로 100번 탐색했습니다. 주문 조회는 평균 30행씩 반환했으며 최종 조인 결과는 3,000행입니다.
별도의 Materialize 노드는 없으며 최상위 완료 시간은 14.7ms입니다. Derived Table의 MERGE 플랜과 같은 접근 구조입니다. 11.5ms와 14.7ms의 단일 측정 차이만으로 CTE 문법 자체가 더 느리다고 판단하지 않습니다.
NO_MERGE를 적용한 CTE입니다
EXPLAIN ANALYZE FORMAT=TREE
WITH paid_orders AS (
    SELECT order_id, customer_id, amount
    FROM orders_merge_lab
    WHERE order_status = 'PAID'
)
SELECT /*+ NO_MERGE(paid_orders) */
       COUNT(*) AS order_count,
       SUM(paid_orders.amount) AS total_amount
FROM customers_merge_lab c
JOIN paid_orders
  ON paid_orders.customer_id = c.customer_id
WHERE c.region = 'SEOUL';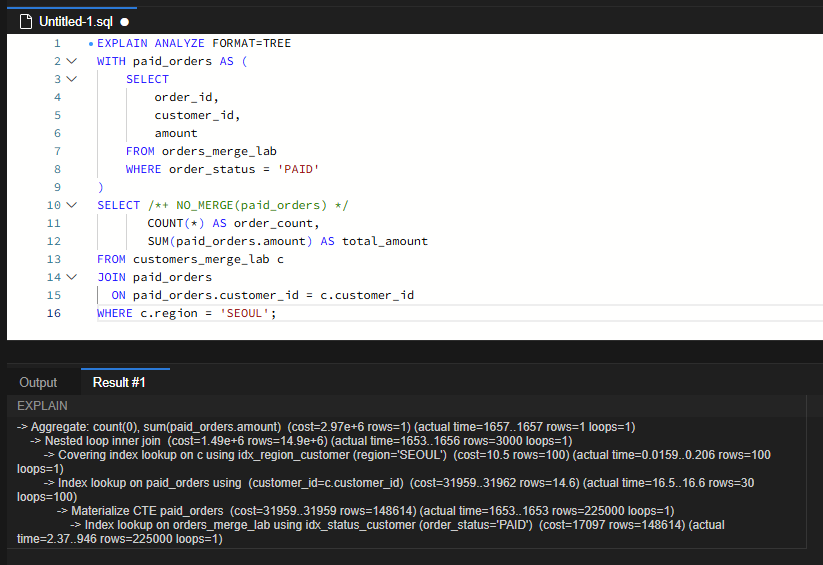
이번에는 Materialize CTE paid_orders가 나타납니다. 원본 PAID 주문 조회는 225,000행을 반환했고, 해당 노드의 완료 시간은 984ms입니다. CTE 구체화 완료 시간은 1,653ms이며 최상위 집계 완료 시간은 1,657ms입니다.
Derived Table과 마찬가지로 구체화는 한 번 실행됐습니다. WITH 절로 옮겼다는 사실만으로 중간 결과 생성 비용이 없어지지는 않았습니다.
| SQL 형태 | 힌트 | 구체화 행 수 | 조인 결과 | 최상위 완료 시간 |
|---|---|---|---|---|
| Derived Table | MERGE | 구체화 노드 없음 | 3,000 | 11.5ms |
| Derived Table | NO_MERGE | 225,000 | 3,000 | 1,604ms |
| CTE | MERGE | 구체화 노드 없음 | 3,000 | 14.7ms |
| CTE | NO_MERGE | 225,000 | 3,000 | 1,657ms |
임시 테이블과 메모리도 함께 비교합니다
실행계획 확인 후에는 EXPLAIN ANALYZE를 제외한 SELECT를 별도로 실행했습니다. 완료된 문장의 Performance Schema 기록에서 실행 시간, 임시 테이블 수, 최대 메모리 값을 수집했습니다.
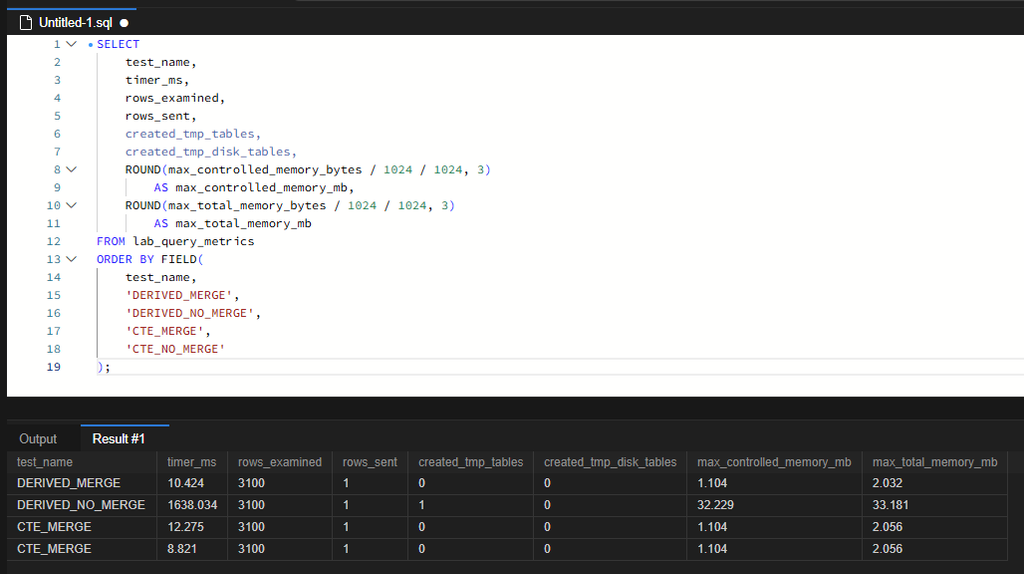
캡처에는 CTE_MERGE가 두 번 있고 CTE_NO_MERGE는 없습니다. 네 번째 행을 이름만 바꿔 CTE_NO_MERGE 결과로 사용하지 않습니다. 아래 표에는 앞의 세 행만 반영했습니다.
| 항목 | Derived MERGE | Derived NO_MERGE | CTE MERGE |
|---|---|---|---|
| 문장 실행 시간 | 10.424ms | 1,638.034ms | 12.275ms |
| ROWS_EXAMINED | 3,100 | 3,100 | 3,100 |
| ROWS_SENT | 1 | 1 | 1 |
| 내부 임시 테이블 수 | 0 | 1 | 0 |
| 디스크 임시 테이블 카운터 | 0 | 0 | 0 |
| 최대 controlled memory | 1.104MiB | 32.229MiB | 1.104MiB |
| 최대 total memory | 2.032MiB | 33.181MiB | 2.056MiB |
측정 SQL의 컬럼명에는 mb가 사용됐지만 실제 계산식은 바이트를 1024로 두 번 나누므로 단위는 MiB입니다.
Derived Table의 NO_MERGE에서는 내부 임시 테이블이 1개 생성됐으며, 최대 total memory는 2.032MiB에서 33.181MiB로 증가했습니다. 이 값은 해당 문장 실행 중 보고된 최대 메모리 지표입니다. 임시 테이블 데이터만의 크기나 MySQL 프로세스 전체의 메모리 사용량으로 해석하지 않습니다. controlled memory는 별도 관리 범위의 지표이므로 total memory와 더하지 않습니다. Performance Schema 문장 이벤트 컬럼
또한 디스크 임시 테이블 카운터가 0이라는 사실만으로 모든 파일 I/O가 없었다고 단정하지 않습니다. 이번 캡처에서 확인할 수 있는 것은 해당 문장에 기록된 카운터가 0이라는 점입니다.
ROWS_EXAMINED가 같아도 작업량이 같지는 않습니다
세 행의 ROWS_EXAMINED는 모두 3,100입니다. 그러나 NO_MERGE 실행계획에는 225,000행의 원본 조회와 구체화가 분명하게 나타납니다.
ROWS_EXAMINED는 서버 계층의 행 검사 카운터이며 모든 내부 처리 행을 합산하는 지표가 아닙니다. 이번 결과처럼 내부 작업량 차이가 같은 수치로 나타날 수 있습니다. 정확히 어떤 내부 처리가 카운터에서 제외됐는지는 이 캡처만으로 확정하지 않습니다.
따라서 ROWS_EXAMINED 하나만 비교하지 않고 Materialize의 실제 행 수, loops, 임시 테이블 수와 메모리 지표를 함께 확인해야 합니다.
두 시간표도 구분합니다. 실행계획의 1,604ms와 Performance Schema의 1,638.034ms는 같은 실행을 서로 다르게 표시한 값이 아니라 별도 실행에서 얻은 값입니다. 계측 방식과 캐시 상태, 실행 시점이 다르므로 하나의 반복 측정 집계처럼 섞지 않습니다.
해결책은 병합 가능한 구조를 유지하고 실제 플랜을 확인하는 것입니다
이번 SQL은 선택도가 높은 고객 조건으로 먼저 범위를 좁힐 수 있습니다. 이러한 상황에서는 넓은 PAID 주문 집합을 먼저 구체화하는 비용을 피하는 병합 플랜이 유리했습니다.
힌트는 대상 이름과 위치가 중요합니다. Derived Table의 별칭이 dt라면 바깥 SELECT에 MERGE(dt)를 사용합니다. CTE의 참조 이름이 paid_orders라면 해당 SELECT에 MERGE(paid_orders)를 사용합니다. 별칭이 있으면 힌트도 별칭을 대상으로 작성해야 합니다. MySQL 옵티마이저 힌트 문서
다만 내부 쿼리에 GROUP BY, DISTINCT, LIMIT, 집계 함수, 윈도 함수 등 병합을 막는 요소가 있으면 MERGE로 기술적 제약을 무시할 수 없습니다. 이번 쿼리의 COUNT와 SUM은 바깥 블록에 있으며, 내부 파생 테이블과 CTE에는 집계가 없습니다.
운영 반영 전에는 힌트가 없는 기본 플랜도 확인해야 합니다. 기본 설정에서 이미 병합되고 있다면 MERGE 힌트를 추가해도 접근 구조가 달라지지 않을 수 있습니다. 이번 실험은 MERGE와 NO_MERGE의 비교이며, 무힌트 SQL 대비 성능 개선을 측정한 실험은 아닙니다.
DBA 관점에서 남겨야 할 판단 기준입니다
첫째, 중간 결과 크기를 확인합니다. 최종 결과가 집계 1행이라고 해서 가벼운 SQL은 아닙니다. 이번 NO_MERGE 플랜은 그 1행을 만들기 전에 225,000행을 구체화했습니다.
둘째, 반복 횟수를 함께 읽습니다. rows=30 loops=100은 이 실험에서 총 3,000행의 주문 조회를 의미합니다. Materialize의 loops=1과 구체화 결과 조회의 loops=100을 구분해야 합니다.
셋째, 구체화가 유리한 경우도 검토합니다. 비용이 큰 공통 결과를 여러 번 참조한다면 한 번 만든 결과를 재사용하는 방식이 도움이 될 수 있습니다. MySQL에서 구체화된 CTE는 같은 문장 안에서 여러 번 참조하더라도 한 번 구체화됩니다. 다만 이번 테스트는 단일 참조 CTE이므로 재사용 이점까지 검증한 결과는 아닙니다.
넷째, 메모리 증가를 동시성 관점에서 검토합니다. 한 문장에서 더 큰 메모리 피크가 관측됐다면 동시 실행 시에도 확인할 이유가 됩니다. 다만 측정값을 연결 수에 단순히 곱해 서버 전체 메모리 사용량을 확정하지 않습니다.
이번 실험에서 성능 차이를 만든 것은 Derived Table과 WITH라는 표기 차이보다 실제 접근 순서와 중간 결과 생성 방식이었습니다. SQL을 정리한 뒤에는 병합 여부, 구체화 행 수, 반복 횟수와 문장별 메모리 지표를 함께 확인하는 것이 필요합니다.

댓글 0
첫 댓글을 남겨보세요.