MySQL 8.4 Index Skip Scan 실전 분석: 선두 컬럼 없는 조건에서 실행계획은 어떻게 바뀌는가
복합 인덱스는 일반적으로 선두 컬럼부터 조건에 사용해야 효율적인 범위 탐색이 가능합니다. 그렇다면 (status, created_at) 인덱스만 있는 주문 테이블에서 status 없이 created_at으로만 조회하면 MySQL은 어떤 실행계획을 선택할까요.
이번 테스트에서는 MySQL 8.4 로컬 환경에 100,000건을 입력하고 같은 날짜 조건을 네 가지 방식으로 비교했습니다. 단순히 EXPLAIN의 예상 행만 본 것이 아니라 EXPLAIN ANALYZE로 실제 처리 행과 실행 시간도 확인했습니다.
테스트 결과는 예상보다 단순하지 않았습니다. skip_scan=on이라고 해서 곧바로 Skip Scan이 선택되지는 않았으며, 조회 컬럼 하나를 추가하자 커버링 인덱스 스캔이 테이블 전체 스캔으로 바뀌었습니다. 날짜를 선두로 한 인덱스를 추가했을 때는 실제 처리 행이 100,000건에서 1,440건으로 줄었습니다.
테스트 조건과 재현 데이터 구성
테스트 테이블은 주문 상태와 생성일을 가진 단순한 구조로 만들었습니다. 복합 인덱스의 선두 컬럼인 status는 0부터 3까지 네 가지 값만 갖도록 구성했습니다.
CREATE DATABASE IF NOT EXISTS skip_scan_lab
    CHARACTER SET utf8mb4
    COLLATE utf8mb4_0900_ai_ci;

USE skip_scan_lab;

CREATE TABLE digit (
    n TINYINT UNSIGNED NOT NULL,
    PRIMARY KEY (n)
) ENGINE=InnoDB;

INSERT INTO digit VALUES
(0),(1),(2),(3),(4),(5),(6),(7),(8),(9);

CREATE TABLE orders_skip_lab (
    id         BIGINT UNSIGNED NOT NULL,
    status     TINYINT UNSIGNED NOT NULL,
    created_at DATETIME NOT NULL,
    payload    VARCHAR(100) NOT NULL,
    PRIMARY KEY (id),
    KEY idx_status_created (status, created_at)
) ENGINE=InnoDB;
다섯 개의 digit 테이블을 조합해 0부터 99,999까지 생성했습니다. created_at은 2025년 1월 1일부터 1분 간격으로 입력했으며 status는 네 값이 동일한 비율로 반복되도록 했습니다.
INSERT INTO orders_skip_lab (id, status, created_at, payload)
SELECT
    seq.n + 1,
    MOD(seq.n, 4),
    DATE_ADD('2025-01-01 00:00:00', INTERVAL seq.n MINUTE),
    RPAD('test-data-', 100, 'x')
FROM (
    SELECT d0.n + d1.n * 10 + d2.n * 100
         + d3.n * 1000 + d4.n * 10000 AS n
    FROM digit d0
    CROSS JOIN digit d1
    CROSS JOIN digit d2
    CROSS JOIN digit d3
    CROSS JOIN digit d4
) seq;

ANALYZE TABLE orders_skip_lab;
전체 행은 100,000건이며 status별로 25,000건씩 분포합니다. 테스트 조회 범위는 2025년 3월 1일 하루입니다. 데이터가 1분 간격이므로 최종 결과는 1,440건입니다.
SELECT COUNT(*) AS result_rows
FROM orders_skip_lab
WHERE created_at >= '2025-03-01 00:00:00'
  AND created_at <  '2025-03-02 00:00:00';
날짜 종료 조건은 23:59:59가 아니라 다음 날 0시 미만으로 작성했습니다. 이 방식은 소수 초를 저장하는 컬럼에서도 하루의 끝부분을 누락하지 않습니다.
첫 번째 플랜: Skip Scan을 끄면 복합 인덱스 전체를 읽었습니다
먼저 Skip Scan을 비활성화한 뒤 기본 조회의 실행계획을 확인했습니다.
SET SESSION optimizer_switch = 'skip_scan=off';

EXPLAIN FORMAT=TRADITIONAL
SELECT status, created_at
FROM orders_skip_lab
WHERE created_at >= '2025-03-01 00:00:00'
  AND created_at <  '2025-03-02 00:00:00';
실제 EXPLAIN 결과는 다음과 같았습니다.
| 항목 | 확인된 값 |
|---|---|
| type | index |
| possible_keys | NULL |
| key | idx_status_created |
| key_len | 6 |
| rows | 85,651 |
| filtered | 11.11 |
| Extra | Using where; Using index |
key에 인덱스 이름이 나타났지만 type=index입니다. 이는 날짜 범위를 직접 찾아 들어간 것이 아니라 (status, created_at) 인덱스를 앞에서부터 넓게 읽고 날짜 조건으로 걸러내는 접근입니다.
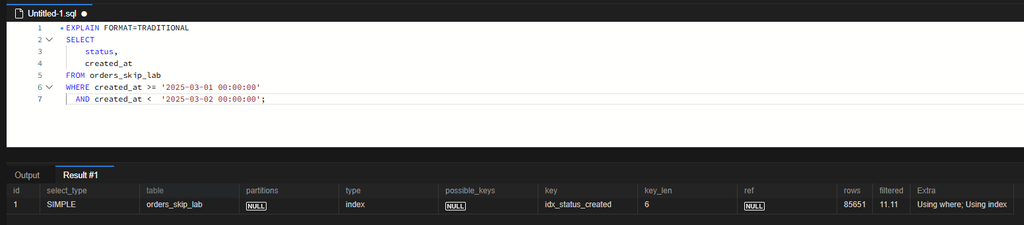
Skip Scan 비활성화 시 idx_status_created 전체 인덱스 스캔이 선택된 실행계획입니다.
EXPLAIN ANALYZE에서는 추정치보다 더 분명한 결과가 확인됐습니다.
Filter: actual time=3.59..13 rows=1440 loops=1
  Covering index scan using idx_status_created:
  actual time=0.413..8.91 rows=100000 loops=1
최종 반환 행은 1,440건이지만 하위 커버링 인덱스 스캔은 100,000건을 모두 읽었습니다. Using index는 커버링 인덱스로 처리했다는 의미일 뿐, 읽은 행이 적다는 뜻은 아닙니다.
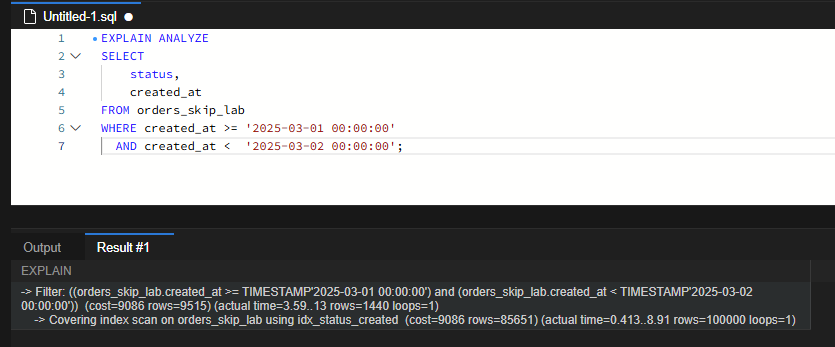
실제 실행에서는 인덱스 100,000건을 읽고 날짜 조건에 맞는 1,440건만 반환했습니다.
두 번째 플랜: skip_scan=on도 사용을 보장하지 않았습니다
이번에는 세션에서 Skip Scan을 활성화하고 같은 쿼리를 실행했습니다.
SET SESSION optimizer_switch = 'skip_scan=on';

EXPLAIN FORMAT=TRADITIONAL
SELECT status, created_at
FROM orders_skip_lab
WHERE created_at >= '2025-03-01 00:00:00'
  AND created_at <  '2025-03-02 00:00:00';
초기 테스트에서는 활성화 이후에도 type=index, key=idx_status_created, rows=85,651, Extra=Using where; Using index 플랜이 유지됐습니다.
EXPLAIN ANALYZE 역시 커버링 인덱스 스캔으로 실제 100,000건을 읽고 1,440건을 반환했습니다. 측정 화면에서는 하위 스캔이 약 12.8ms, 필터까지 약 18.3ms로 나타났습니다.
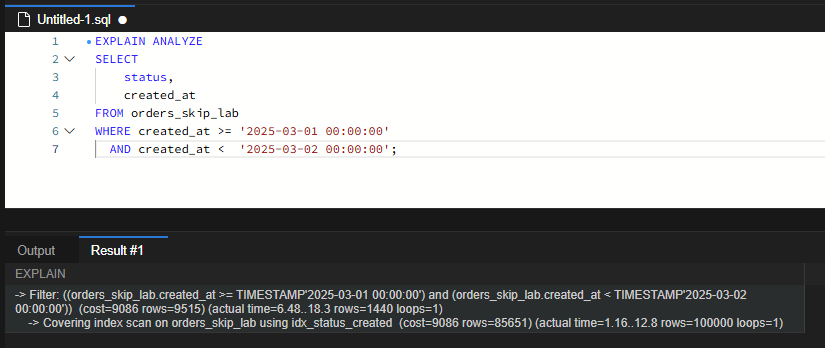
Skip Scan 기능이 켜져 있어도 비용 계산에서 선택되지 않으면 기존 index 플랜이 유지됩니다.
활성화 상태의 실제 실행에서도 100,000건 커버링 인덱스 스캔이 확인됐습니다.
optimizer_switch='skip_scan=on'은 옵티마이저가 Skip Scan을 후보로 검토할 수 있게 합니다. 반드시 선택하라는 강제 명령은 아닙니다. 데이터 분포, 통계, 예상 선택도와 다른 후보 경로의 비용을 비교한 뒤 더 저렴하다고 판단한 경로를 선택합니다.
Skip Scan을 분리하자 Using index for skip scan이 확인됐습니다
뒤에서 추가한 날짜 선두 인덱스를 제외하고 기존 복합 인덱스의 Skip Scan 가능성을 다시 확인했습니다.
EXPLAIN FORMAT=TRADITIONAL
SELECT status, created_at
FROM orders_skip_lab
IGNORE INDEX (idx_created_status)
WHERE created_at >= '2025-03-01 00:00:00'
  AND created_at <  '2025-03-02 00:00:00';
이 비교에서는 실제로 Skip Scan이 선택됐습니다.
| 항목 | 확인된 값 |
|---|---|
| type | range |
| possible_keys | idx_status_created |
| key | idx_status_created |
| key_len | 6 |
| rows | 10,240 |
| filtered | 100 |
| Extra | Using where; Using index for skip scan |
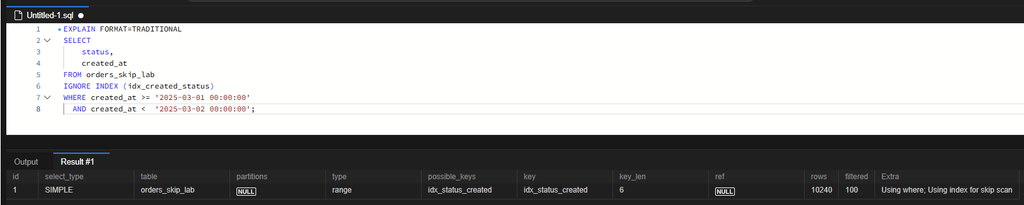
날짜 선두 인덱스를 제외하자 idx_status_created의 Skip Scan과 추정 10,240행이 확인됐습니다.
Skip Scan은 선두 컬럼을 무시하고 두 번째 컬럼만 읽는 기능이 아닙니다. 이번 데이터에서는 status의 서로 다른 네 값을 찾은 뒤 각 값마다 created_at 범위를 구성합니다.
status=0 + 3월 1일 범위
status=1 + 3월 1일 범위
status=2 + 3월 1일 범위
status=3 + 3월 1일 범위
전체 인덱스를 한 번 훑는 대신 네 개의 하위 범위를 반복 탐색하는 구조입니다. 선두 컬럼의 값 종류가 적고 뒤쪽 컬럼의 조회 범위가 좁을수록 유리해질 가능성이 있습니다.
이번 캡처는 일반 EXPLAIN이므로 rows=10,240은 추정치입니다. Skip Scan의 실제 처리 행과 실행 시간까지 비교하려면 동일한 IGNORE INDEX 조건으로 EXPLAIN ANALYZE를 추가 실행해야 합니다.
조회 컬럼 하나를 추가하자 테이블 전체 스캔으로 바뀌었습니다
기존 쿼리는 status와 created_at만 반환하므로 (status, created_at) 인덱스 안에서 결과를 완성할 수 있습니다. 여기에 인덱스에 없는 payload를 추가했습니다.
EXPLAIN FORMAT=TRADITIONAL
SELECT status, created_at, payload
FROM orders_skip_lab
WHERE created_at >= '2025-03-01 00:00:00'
  AND created_at <  '2025-03-02 00:00:00';
실행계획은 type=ALL, key=NULL, rows=85,651, filtered=11.11, Extra=Using where로 바뀌었습니다.
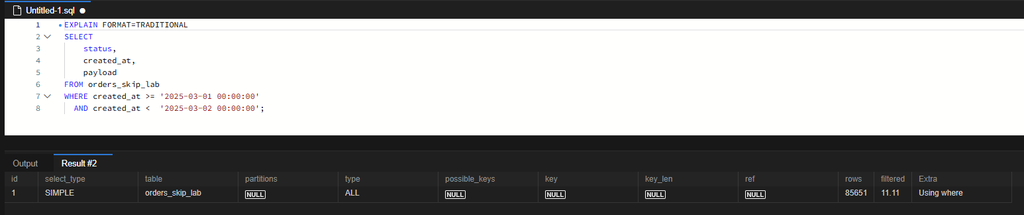
인덱스에 없는 payload를 조회하자 테이블 전체 스캔으로 변경됐습니다.
실제 실행에서는 테이블 100,000건을 읽은 뒤 1,440건을 반환했습니다.
Table scan: actual time=0.188..19.9 rows=100000 loops=1
Filter: actual time=2.2..25.6 rows=1440 loops=1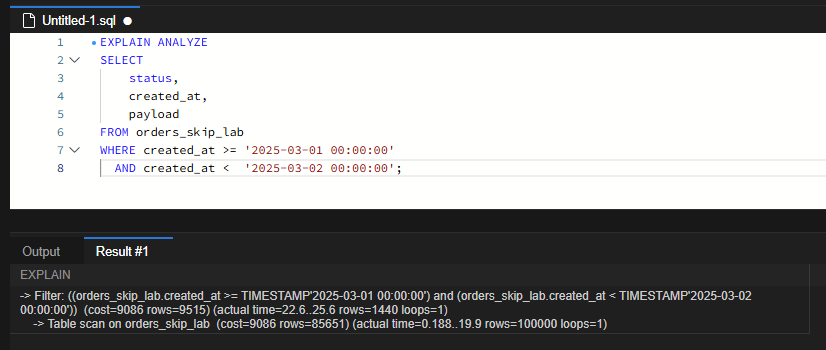
payload 추가 후 실제 테이블 100,000건을 읽고 1,440건을 남긴 결과입니다.
WHERE 절과 기존 인덱스가 그대로여도 SELECT 목록이 바뀌면 플랜이 달라질 수 있습니다. 운영 화면 개편 뒤 같은 검색 조건이 갑자기 느려졌다면 조회 컬럼이 추가돼 커버링 조건이 깨졌는지도 확인해야 합니다.
날짜 선두 인덱스를 추가하자 1,440건만 범위 스캔했습니다
날짜 단독 조회가 반복되는 상황을 가정해 (created_at, status) 인덱스를 추가했습니다.
CREATE INDEX idx_created_status
ON orders_skip_lab (created_at, status);

ANALYZE TABLE orders_skip_lab;
이후 힌트 없이 같은 쿼리를 실행하자 옵티마이저가 새 인덱스를 선택했습니다.
| 항목 | 확인된 값 |
|---|---|
| type | range |
| possible_keys | idx_status_created, idx_created_status |
| key | idx_created_status |
| key_len | 5 |
| rows | 1,440 |
| filtered | 100 |
| Extra | Using where; Using index |
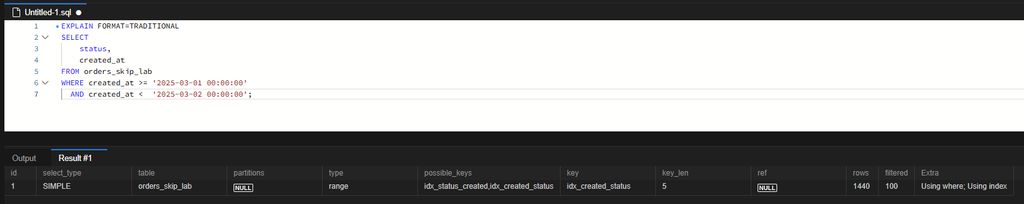
날짜 선두 인덱스가 추가되자 추정 1,440건의 일반 범위 스캔을 선택했습니다.
EXPLAIN ANALYZE에서도 차이가 확인됐습니다.
Covering index range scan using idx_created_status:
actual time=0.0596..0.391 rows=1440 loops=1

Filter: actual time=0.0624..0.632 rows=1440 loops=1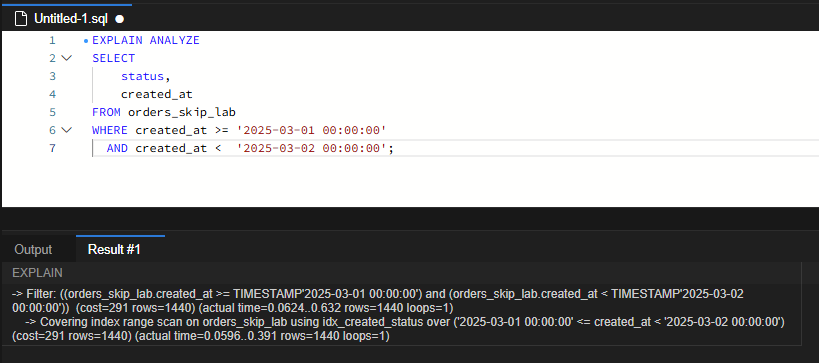
날짜 선두 인덱스는 최종 결과와 같은 1,440건만 실제 범위 스캔했습니다.
기존 전체 커버링 인덱스 스캔은 100,000건을 읽었지만 날짜 선두 인덱스는 1,440건을 읽었습니다. 필터 노드까지의 측정 종료 시각도 약 13ms 또는 18.3ms에서 약 0.632ms로 감소했습니다.
이 시간값은 로컬 환경에서 수행한 단일 실행 결과입니다. 버퍼 풀 상태와 실행 순서의 영향을 받으므로 운영 성능 개선율로 일반화하기보다 접근 행 감소를 확인하는 근거로 사용하는 편이 정확합니다.
FORCE INDEX의 예상 1건을 실제 건수로 해석하면 안 됩니다
날짜 선두 인덱스를 강제했을 때 type=range, key=idx_created_status는 동일했지만 예상 행 수가 1로 표시된 캡처도 확인됐습니다.
EXPLAIN FORMAT=TRADITIONAL
SELECT status, created_at
FROM orders_skip_lab
FORCE INDEX (idx_created_status)
WHERE created_at >= '2025-03-01 00:00:00'
  AND created_at <  '2025-03-02 00:00:00';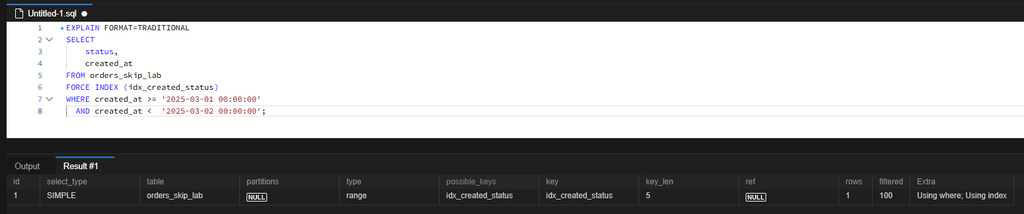
FORCE INDEX 실행에서는 예상 행이 1건으로 표시됐지만 실제 결과는 1,440건입니다.
이 결과는 rows가 실제 처리 건수가 아니라 통계와 비용 모델을 바탕으로 계산한 추정치라는 점을 보여줍니다. 힌트를 사용한 EXPLAIN 한 장만 보고 성능을 판단하면 안 됩니다. 힌트 없는 원래 플랜과 EXPLAIN ANALYZE를 함께 확인해야 합니다.
네 가지 플랜 비교
| 테스트 조건 | 접근 방식 | 예상 rows | 실제 스캔 행 | 실제 반환 행 |
|---|---|---|---|---|
| Skip Scan OFF | idx_status_created 전체 인덱스 스캔 | 85,651 | 100,000 | 1,440 |
| Skip Scan ON 초기 플랜 | 기존 전체 인덱스 스캔 유지 | 85,651 | 100,000 | 1,440 |
idx_created_status 제외 | idx_status_created Skip Scan | 10,240 | 미측정 | 1,440 |
| payload 추가 | 테이블 전체 스캔 | 85,651 | 100,000 | 1,440 |
| 날짜 선두 인덱스 | idx_created_status 범위 스캔 | 1,440 | 1,440 | 1,440 |
가장 중요한 숫자는 실행 시간보다 실제 스캔 행입니다. 전체 인덱스 스캔과 테이블 스캔은 모두 100,000건을 읽었습니다. 날짜 선두 인덱스는 필요한 1,440건만 읽었습니다. Skip Scan은 일반 EXPLAIN에서 추정 10,240건으로 비용 절감 가능성을 보여줬지만 실측 값은 추가 검증이 필요합니다.
실무에서는 Skip Scan과 신규 인덱스 중 무엇을 선택해야 할까요
Skip Scan은 기존 복합 인덱스를 재사용하므로 인덱스를 즉시 추가하기 어려운 상황에서 유용합니다. 선두 컬럼의 NDV가 낮고 뒤쪽 컬럼의 범위가 좁으며 조회 컬럼이 인덱스 안에 있다면 검토할 가치가 있습니다.
날짜 조건 조회가 매우 빈번하고 응답 시간이 중요하다면 날짜를 선두로 한 인덱스가 더 직접적인 접근 경로입니다. 이번 테스트에서도 날짜 선두 인덱스는 실제 1,440건만 읽었습니다.
새 인덱스에는 비용도 있습니다. INSERT와 UPDATE 시 인덱스를 함께 유지해야 하고 버퍼 풀과 디스크 공간도 사용합니다. 하루 한 번 실행하는 배치 쿼리를 위해 인덱스를 추가하는 결정과 초당 반복되는 조회를 개선하는 결정은 달라야 합니다.
| 운영 조건 | 우선 검토할 방향 |
|---|---|
| 날짜 단독 조회가 드뭅니다. | 기존 인덱스의 Skip Scan으로 목표 시간을 충족하는지 확인합니다. |
| 날짜 단독 조회가 빈번합니다. | 날짜 선두 인덱스의 읽기 감소와 쓰기 비용을 비교합니다. |
| 조회 컬럼이 자주 변경됩니다. | 커버링 조건이 쉽게 깨지는지 확인합니다. |
| 예상 행과 실제 행 차이가 큽니다. | 통계와 데이터 분포를 점검합니다. |
| 힌트를 적용해야만 좋은 플랜이 나옵니다. | 통계와 인덱스 설계를 먼저 검토하고 힌트는 제한적으로 사용합니다. |
테스트에서 확인한 DBA 체크포인트
첫째, key에 인덱스가 표시됐다는 사실만으로 효율적인 조회라고 판단하면 안 됩니다. 이번 테스트의 type=index 플랜은 실제 인덱스 100,000건을 읽었습니다.
둘째, Using index와 Using index for skip scan은 구분해야 합니다. 전자는 커버링 여부를 나타낼 수 있고, 후자는 Skip Scan 접근 방식이 실제 선택됐다는 표시입니다.
셋째, skip_scan=on은 사용 허용 설정입니다. 데이터와 비용 계산에 따라 전체 인덱스 스캔이 그대로 선택될 수 있습니다.
넷째, 실행계획의 rows는 추정치입니다. 이번 테스트에서는 일반 플랜 85,651건, Skip Scan 10,240건, FORCE INDEX 1건이 표시됐지만 실제 결과는 1,440건이었습니다.
다섯째, 최종 반환 행보다 하위 스캔 노드의 실제 행을 확인해야 합니다. 최종 1,440건만 보면 세 플랜이 같아 보이지만 하위 단계에서는 100,000건과 1,440건으로 차이가 컸습니다.
MySQL Index Skip Scan은 복합 인덱스의 선두 컬럼 규칙을 없애는 기능이 아닙니다. 선두 키의 서로 다른 값을 찾아가며 뒤쪽 키의 범위를 반복 탐색하는 비용 기반 접근 방식입니다. 운영 튜닝에서는 기능 이름보다 실제 처리 행, 호출 빈도, 쓰기 부하와 목표 응답 시간을 함께 확인해야 합니다.

댓글 0
첫 댓글을 남겨보세요.