MySQL 인덱스 삭제 전 Invisible Index로 검증하기, 함수 기반 인덱스 실측 비교 (MySQL 8.4)

운영에서 사용하지 않는 인덱스를 정리할 때는 sys.schema_unused_indexes로 후보를 찾은 뒤 바로 지우지 않았습니다. 먼저 INVISIBLE로 바꿔 며칠 지켜보고, 특이사항이 없는 것을 확인한 다음에 최종 삭제했습니다.
인덱스는 지운 뒤에 문제가 드러나면 되돌리는 데 시간이 걸립니다. 복합 인덱스를 추가하면서 겹친다고 본 단독 인덱스를 지웠다가 응답 지연이 생겼고, 그 인덱스를 다시 만드는 데 1시간이 걸린 적도 있습니다. 그 과정은 ORDER BY LIMIT 인덱스 오선택 글에 따로 적었습니다.
MySQL 8.0부터 지원하는 Invisible Index를 쓰면 인덱스를 실제로 지우거나 새 인덱스를 공개하기 전에 실행계획이 어떻게 바뀌는지 먼저 볼 수 있습니다. 아래는 MySQL 8.4에서 주문 데이터 100,000건을 만들어 직접 실행한 결과입니다. 삭제 후보를 숨겨 보는 경우와, 함수 기반 인덱스를 숨긴 채 만들어 검증하는 경우를 함께 다뤘습니다.
테스트 테이블과 인덱스 구성
| 항목 | 내용 |
|---|---|
| DBMS | MySQL Community 8.4.11 (Windows 로컬) |
| 스토리지 엔진 | InnoDB |
| 테이블 | orders_refactor_lab, 100,000행 |
| 주요 컬럼 | id, customer_id, created_at, amount, payload |
| 데이터 | 2025-01-01 0시부터 1분 간격으로 생성한 합성 데이터 |
| 측정 방식 | EXPLAIN ANALYZE 단일 실행 (반복 평균 아님) |
| 인덱스 | 구성 | 용도 |
|---|---|---|
| idx_customer_created | (customer_id, created_at) | 고객별 주문 조회 |
| idx_created_at | (created_at) | 일반 날짜 범위 조회 |
| idx_created_day | ((DATE(created_at))) | 함수 기반 날짜 조회 |
조회 컬럼에는 인덱스에 없는 amount를 넣었습니다. 인덱스만 읽고 끝나는 커버링 조회가 아니라, 실제 화면처럼 주문 금액까지 가져오는 SQL로 비교하기 위해서입니다.
삭제 후보 인덱스는 지우기 전에 먼저 숨겨 봅니다
고객별 주문 조회에 쓰이는 idx_customer_created를 삭제 후보라고 가정하고, 숨기기 전과 후의 실행계획을 비교했습니다. 세션의 use_invisible_indexes는 off로 둡니다. 이 값이 on이면 숨긴 인덱스도 실행계획 후보에 들어가서 비교 자체가 의미 없어집니다.
공개 상태: 인덱스로 10행만 조회
SET SESSION optimizer_switch = 'use_invisible_indexes=off';

ALTER TABLE orders_refactor_lab
    ALTER INDEX idx_customer_created VISIBLE;

EXPLAIN ANALYZE FORMAT=TREE
SELECT id, created_at, amount
FROM orders_refactor_lab
WHERE customer_id = 1001;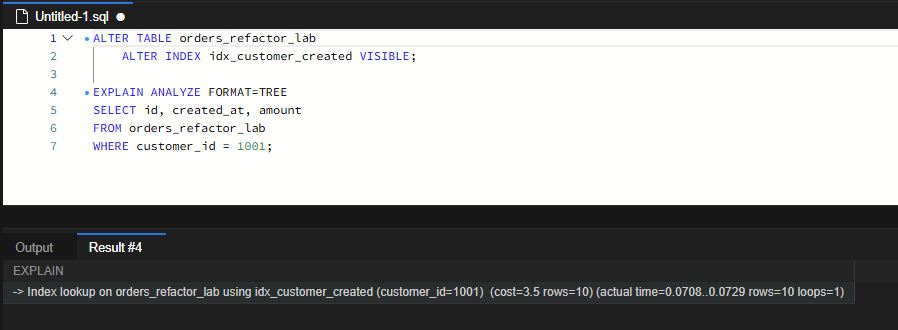
실행계획에 Index lookup on orders_refactor_lab using idx_customer_created가 나옵니다. 복합 인덱스의 선두 컬럼인 customer_id로 바로 찾아 들어갔다는 뜻입니다. 실제 값은 actual time=0.0708..0.0729 rows=10 loops=1로, 10행을 반환하는 데 0.0729ms가 걸렸습니다.
숨긴 상태: 10행을 찾으려고 100,000행 스캔
ALTER TABLE orders_refactor_lab
    ALTER INDEX idx_customer_created INVISIBLE;

EXPLAIN ANALYZE FORMAT=TREE
SELECT id, created_at, amount
FROM orders_refactor_lab
WHERE customer_id = 1001;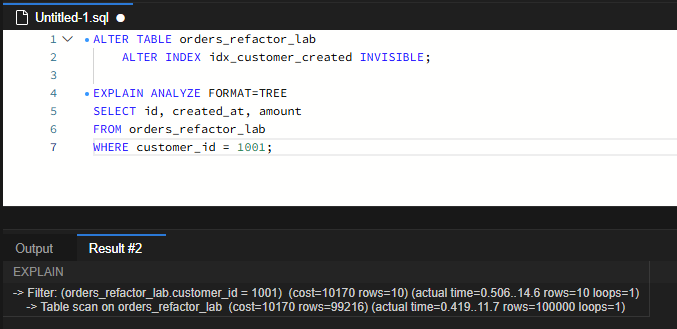
-> Filter: (customer_id = 1001)
   (actual time=0.506..14.6 rows=10 loops=1)
    -> Table scan on orders_refactor_lab
       (actual time=0.419..11.7 rows=100000 loops=1)
반환한 행은 똑같이 10행입니다. 다만 그 10행을 찾으려고 테이블 100,000행을 모두 읽어 필터로 넘겼고, 완료 시간은 0.0729ms에서 14.6ms로 늘었습니다.
이 인덱스는 이 SQL에 꼭 필요하다는 게 실행계획으로 확인된 셈입니다. 사용 기록만 보고 삭제했다면 이 조회는 매번 전체 스캔으로 돌게 됩니다.
rows=100000은 테이블 스캔 노드가 위로 넘긴 행 수입니다. 디스크 I/O가 10만 번 일어났다는 뜻은 아니고, 데이터가 버퍼 풀에 올라와 있으면 메모리에서 읽습니다.
되돌릴 때는 VISIBLE 한 줄이면 됩니다
ALTER TABLE orders_refactor_lab
    ALTER INDEX idx_customer_created VISIBLE;
Invisible은 인덱스를 지우는 게 아니라 옵티마이저 눈에서만 가리는 것이라 인덱스 구조는 그대로 남아 있습니다. 그래서 다시 만들 필요 없이 바로 원래 상태로 돌아갑니다. DROP 전에 이 단계를 한 번 거치는 이유가 여기에 있습니다.
이 명령은 DDL이라 ROLLBACK으로는 되돌릴 수 없고, 반대 방향의 ALTER를 실행해야 합니다.
DATE()를 씌운 조건은 인덱스가 있어도 탐색하지 못합니다
WHERE DATE(created_at) = '2025-03-01'idx_created_at은 created_at 원본 값 순서로 정렬돼 있는데, 이 조건은 원본이 아니라 DATE()로 바꾼 결과를 비교합니다. 정렬 기준과 비교 대상이 다르니 인덱스가 있어도 해당 범위로 바로 찾아 들어갈 수 없습니다. 쿼리 검수에서 이런 조건을 찾아 범위 조건으로 바꾼 운영 사례는 DATE 함수 조건 글에 따로 정리했습니다.
SQL을 고칠 수 있다면 범위 조건이 먼저
인덱스를 새로 만들기 전에 먼저 검토할 방법입니다. 컬럼은 그대로 두고 비교 값 쪽을 범위로 바꿉니다.
SELECT id, created_at, amount
FROM orders_refactor_lab
WHERE created_at >= '2025-03-01 00:00:00'
  AND created_at <  '2025-03-02 00:00:00';
같은 날짜의 행을 찾는 조건이지만 created_at 원본 값에 범위를 주기 때문에, 새 인덱스 없이 기존 idx_created_at으로 범위 탐색을 할 수 있습니다. 인덱스가 하나 늘어나면 쓰기 비용과 저장 공간도 같이 늘어나니, 고칠 수 있는 SQL이라면 이쪽이 운영 부담이 적습니다. 이번 테스트에서 이 SQL의 실행 시간은 따로 측정하지 않았습니다.
고칠 수 없는 SQL이라면 함수 기반 인덱스
리포팅 도구나 공통 모듈이 SQL을 자동으로 만들어서 손댈 수 없는 경우도 있습니다. 이럴 때 쓸 수 있는 것이 MySQL 8.0.13부터 지원하는 함수 기반 인덱스(Functional Key Parts)입니다. 함수 결과 자체를 인덱스 키로 저장합니다.
| 상황 | 우선 검토 |
|---|---|
| 애플리케이션 SQL을 수정할 수 있다 | 좌변 함수를 제거하고 범위 조건으로 변경 |
| SQL을 수정할 수 없다 (도구, 공통 모듈) | 함수 기반 인덱스 추가 |
| DATE() 조회가 드물다 | 인덱스 추가 대신 현재 응답 시간 허용 여부 판단 |
| DATE() 조회가 빈번하다 | 함수 인덱스의 읽기 개선과 쓰기 비용 비교 |
새 인덱스는 숨긴 채로 만들어 내 세션에서만 확인합니다
함수 기반 인덱스를 처음부터 Invisible로 생성했습니다.
CREATE INDEX idx_created_day
    ON orders_refactor_lab ((DATE(created_at))) INVISIBLE;
바깥 괄호는 인덱스 키 목록, 안쪽 괄호는 함수 표현식입니다. 괄호를 하나만 쓰면 문법 오류가 납니다.
숨긴 상태로 만들면 다른 연결의 실행계획은 바뀌지 않습니다. 내 세션만 use_invisible_indexes=on으로 바꿔 새 인덱스를 썼을 때의 플랜을 미리 볼 수 있으니, 운영 중인 다른 SQL이 새 인덱스를 엉뚱하게 골라 느려지는 일 없이 검증할 수 있습니다.
함수 인덱스 없이 실행: 전체 스캔 후 1,440행
ALTER TABLE orders_refactor_lab
    ALTER INDEX idx_created_day INVISIBLE;

SET SESSION optimizer_switch = 'use_invisible_indexes=off';

EXPLAIN ANALYZE FORMAT=TREE
SELECT id, created_at, amount
FROM orders_refactor_lab
WHERE DATE(created_at) = '2025-03-01';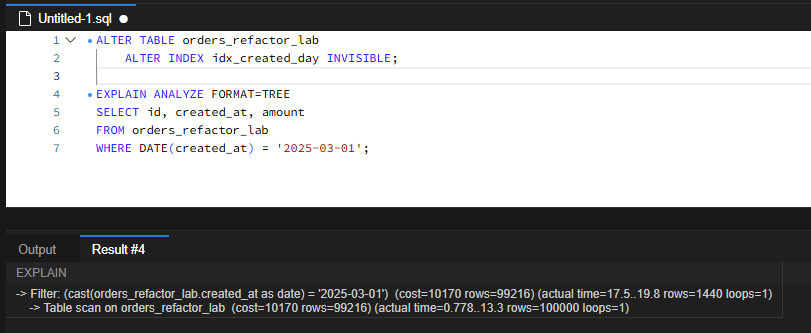
-> Filter: (cast(created_at as date) = '2025-03-01')
   (actual time=17.5..19.8 rows=1440 loops=1)
    -> Table scan on orders_refactor_lab
       (actual time=0.778..13.3 rows=100000 loops=1)
idx_created_at이 있는데도 100,000행을 전부 읽고 날짜가 맞는 1,440행을 걸러 냈습니다. 완료 시간은 19.8ms입니다. 실행계획에서 DATE(created_at)가 cast(created_at as date)로 표시되는데, MySQL 내부에서 같은 의미로 변환한 것입니다.
함수 인덱스를 후보에 넣고 실행: 해당 날짜만 조회
SET SESSION optimizer_switch = 'use_invisible_indexes=on';

EXPLAIN ANALYZE FORMAT=TREE
SELECT id, created_at, amount
FROM orders_refactor_lab
WHERE DATE(created_at) = '2025-03-01';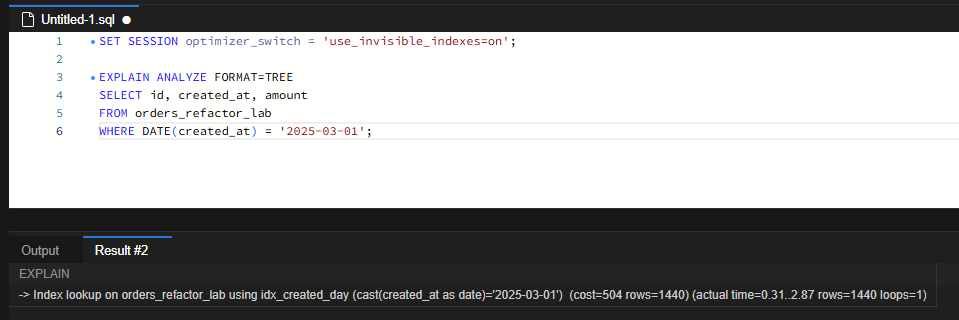
이번에는 Index lookup on orders_refactor_lab using idx_created_day가 나오고, 실제 값은 actual time=0.31..2.87 rows=1440 loops=1입니다. 반환 행은 같은 1,440행이지만 전체 스캔 없이 해당 날짜만 찾아 들어갔고, 완료 시간은 19.8ms에서 2.87ms로 줄었습니다.
숫자로는 약 6.9배 차이지만 단일 실행 값이라 운영에서도 같은 배수가 나온다고 보기는 어렵습니다. 확실하게 말할 수 있는 건 접근 방식이 “전체 스캔 후 필터”에서 “인덱스 조회”로 바뀌었다는 점입니다.
use_invisible_indexes=on은 특정 인덱스를 강제로 쓰게 하는 설정이 아닙니다. 현재 세션에서 숨겨진 인덱스 전부를 후보로 넣을 뿐이라, 어떤 인덱스가 선택됐는지는 실행계획의 인덱스명으로 꼭 확인해야 합니다.
네 번의 실행 결과를 나란히 놓고 보면
| 조회 조건 | 인덱스 상태 | 접근 방식 | 하위 노드 실제 행 | 최종 결과 행 | 완료 시간 |
|---|---|---|---|---|---|
| customer_id = 1001 | 고객 인덱스 공개 | Index lookup | 10 | 10 | 0.0729ms |
| customer_id = 1001 | 고객 인덱스 숨김 | Table scan → Filter | 100,000 | 10 | 14.6ms |
| DATE = 2025-03-01 | 함수 인덱스 미사용 | Table scan → Filter | 100,000 | 1,440 | 19.8ms |
| DATE = 2025-03-01 | 함수 인덱스 사용 | Index lookup | 1,440 | 1,440 | 2.87ms |
EXPLAIN ANALYZE 결과를 읽을 때 헷갈리기 쉬운 부분도 함께 적어 둡니다.
- 완료 시간은 최상위 노드의
actual time=a..b에서 b 값입니다. 부모 노드 시간에 자식 노드 시간이 이미 들어 있으므로 테이블 스캔 시간과 필터 시간을 더하면 안 됩니다. - cost는 밀리초가 아닙니다. 옵티마이저가 경로끼리 비교할 때 쓰는 상대 값입니다.
- 추정 rows와 실제 rows는 다를 수 있습니다. 함수 인덱스가 없을 때 날짜 필터의 추정 행은 99,216이었지만 실제 결과는 1,440이었습니다. 함수 결과에 대한 통계가 없어 선택도를 제대로 예측하지 못한 것입니다. 함수 인덱스를 쓴 플랜에서는 추정과 실제가 모두 1,440으로 맞았습니다.
운영 DB에서 인덱스를 숨기거나 추가하기 전에
지금 숨겨진 인덱스가 있는지부터
SELECT INDEX_NAME, IS_VISIBLE
FROM information_schema.STATISTICS
WHERE TABLE_SCHEMA = DATABASE()
  AND TABLE_NAME = 'orders_refactor_lab'
GROUP BY INDEX_NAME, IS_VISIBLE;
미사용 인덱스 뷰는 후보만 알려 줍니다
SELECT object_schema, object_name, index_name
FROM sys.schema_unused_indexes
WHERE object_schema = DATABASE()
  AND object_name = 'orders_refactor_lab';
이 뷰는 서버가 시작된 뒤 쌓인 사용 기록을 기준으로 합니다. 최근에 재시작했다면 월말 정산이나 주간 배치처럼 가끔 도는 작업의 기록이 빠져 있을 수 있으니, 관측 기간에 대표 업무가 모두 들어 있는지 먼저 봐야 합니다. 도입부에서 말한 것처럼 이 뷰로는 후보만 고르고, INVISIBLE로 며칠 관찰한 뒤에 삭제하는 이유가 여기에 있습니다.
숨기기와 세션 설정은 영향 범위가 다릅니다
| 작업 | 영향 범위 |
|---|---|
ALTER INDEX ... INVISIBLE | 테이블 메타데이터 변경, 모든 연결의 실행계획에 영향 |
SET SESSION optimizer_switch | 현재 연결에만 적용 |
기존 인덱스를 숨기는 건 운영 전체에 영향을 주는 작업입니다. 반면 새 인덱스를 숨긴 채로 만들고 검증 세션에서만 켜는 건 다른 연결에 영향이 없습니다. 같은 Invisible이라도 무게가 다릅니다.
숨겨도 쓰기 비용은 그대로 남습니다
숨긴 인덱스도 INSERT, UPDATE, DELETE 때마다 계속 갱신되고 저장 공간도 차지합니다. UNIQUE 인덱스라면 유일성 검사도 그대로 합니다. 그래서 Invisible 테스트로 “삭제하면 조회가 어떻게 되는가”는 확인할 수 있어도, “삭제하면 쓰기가 얼마나 빨라지는가”까지 확인한 것은 아닙니다.
숨길 수 없거나 따로 확인할 인덱스
- PRIMARY KEY는 Invisible로 만들 수 없습니다.
- 외래 키가 사용하는 인덱스인지 확인합니다.
FORCE INDEX(인덱스명)같은 힌트를 쓰는 SQL이 있는지 봅니다. 숨긴 인덱스를 힌트로 지정하면 오류가 날 수 있습니다.
새 인덱스 생성은 공개 상태 변경보다 무겁습니다
Visible/Invisible 전환은 메타데이터만 바꾸지만, 새 인덱스 생성은 테이블 전체를 읽어 인덱스를 만듭니다. 온라인 DDL이라도 시작과 끝에 메타데이터 잠금을 잡기 때문에, 오래 실행 중인 트랜잭션이 있으면 대기가 생길 수 있습니다. 작업 전에 장기 트랜잭션과 작업 시간대를 확인합니다.
함수 인덱스는 표현식이 정확히 같아야 쓰입니다
idx_created_day는 DATE(created_at) 조건 전용입니다. 시각까지 포함하는 범위 조회에는 여전히 idx_created_at이 필요하므로, 함수 인덱스를 만들었다고 기존 날짜 인덱스를 지울 근거가 되지는 않습니다. DATE_FORMAT(created_at, '%Y-%m-%d')처럼 같은 날짜를 뜻하는 다른 표현식도 이 인덱스를 쓰지 못합니다.
공개한 뒤에는 일반 연결에서 한 번 더
ALTER TABLE orders_refactor_lab
    ALTER INDEX idx_created_day VISIBLE;
공개한 다음에는 use_invisible_indexes=off인 일반 연결에서도 이 인덱스가 선택되는지, 그리고 같은 테이블을 쓰는 다른 SQL의 플랜이 바뀌지 않았는지 확인합니다. 검증 세션에서 본 플랜과 일반 연결의 플랜이 같아야 작업이 끝난 것입니다.



댓글 0
첫 댓글을 남겨보세요.