MySQL CTE와 Derived Table 성능 비교: MERGE·NO_MERGE 실행계획으로 본 구체화 비용

월별 정산 관리자 화면에서 특정 거래처를 조회하면 결과는 몇 행밖에 나오지 않는데 응답이 늦게 오는 문제가 있었습니다. 실행계획을 열어 보니 서브쿼리가 모든 거래처의 정산 데이터를 먼저 집계하고, 바깥 쿼리에서 요청한 거래처만 걸러 내고 있었습니다. 화면에 보이는 결과보다 중간에 집계하는 데이터가 훨씬 큰 구조였습니다.
이런 쿼리를 보면 “WITH 절로 바꾸면 나아지지 않을까”라는 생각이 들기 쉽습니다. 하지만 MySQL에서 Derived Table이든 CTE든, 성능을 가르는 건 문법이 아니라 바깥 쿼리에 병합되는지, 중간 결과를 임시 테이블로 먼저 만드는지입니다. 이 차이를 MySQL 8.4에서 직접 재현해 실행계획과 문장별 메모리 지표로 비교했습니다.
같은 1행을 만드는 네 개의 SQL
네 SQL 모두 서울 고객의 결제 완료(PAID) 주문 건수와 금액 합계를 구합니다. 반환하는 결과도 똑같이 1행입니다. 바뀐 건 SQL 형태(Derived Table / CTE)와 옵티마이저 힌트(MERGE / NO_MERGE)뿐입니다.
| SQL 형태 | 힌트 | 구체화 행 수 | 조인 결과 | 최상위 완료 시간 |
|---|---|---|---|---|
| Derived Table | MERGE | 없음 | 3,000 | 11.5ms |
| Derived Table | NO_MERGE | 225,000 | 3,000 | 1,604ms |
| CTE | MERGE | 없음 | 3,000 | 14.7ms |
| CTE | NO_MERGE | 225,000 | 3,000 | 1,657ms |
표를 세로로 보면 Derived Table과 CTE 사이에는 차이가 거의 없습니다. 가로로 보면 MERGE와 NO_MERGE 사이에 100배 넘는 차이가 납니다. 아래에서는 이 차이가 실행계획의 어디에서 생겼는지 하나씩 확인합니다.
고객 1만 명, 주문 30만 건으로 만든 합성 데이터
| 항목 | 구성 |
|---|---|
| DBMS | 로컬 MySQL 8.4 |
| 고객 테이블 | customers_merge_lab, 10,000행 |
| 주문 테이블 | orders_merge_lab, 300,000행 |
| 서울 고객 | 100명 |
| 전체 PAID 주문 | 225,000행 |
| 조인 결과 | 3,000행 |
| 최종 결과 | COUNT·SUM 1행 |
| 고객 인덱스 | idx_region_customer(region, customer_id) |
| 주문 인덱스 | idx_status_customer(order_status, customer_id), idx_customer_status(customer_id, order_status) |
데이터는 규칙적으로 생성한 합성 데이터이고, 생성 규칙상 서울 고객의 주문은 모두 PAID입니다. 실제 서비스의 지역·상태 분포와는 다릅니다. 시간 값은 모두 단일 실행 결과라서, 운영에서도 같은 개선 폭이 나온다고 보면 안 됩니다.
병합과 구체화, 무엇을 먼저 읽느냐의 차이
MERGE는 Derived Table이나 CTE를 바깥 쿼리 블록에 합칩니다. 합쳐지고 나면 옵티마이저가 고객 조건(c.region = 'SEOUL')과 주문 조건(order_status = 'PAID')을 한꺼번에 보고 조인 순서와 인덱스를 고를 수 있습니다.
NO_MERGE는 병합을 막습니다. 이번 쿼리에서는 안쪽 SELECT의 결과 전체를 먼저 임시 테이블로 만드는 Materialize(구체화) 단계가 나타났습니다. 다만 MySQL은 구체화를 필요한 시점까지 미루거나 구체화 결과에 자동 인덱스를 붙이기도 하므로, NO_MERGE가 곧 전체 스캔이라는 뜻은 아닙니다. 자세한 동작은 MySQL 파생 테이블·CTE 최적화 문서에 정리돼 있습니다.
결국 이번 비교에서 확인하려는 건 하나입니다. 서울 고객 100명부터 찾고 그 고객의 주문만 읽는지, 아니면 PAID 주문 22만 5천 건을 먼저 만들어 두는지입니다.
MERGE일 때: 서울 고객 100명부터 좁혀 들어갑니다
Derived Table + MERGE
EXPLAIN ANALYZE FORMAT=TREE
SELECT /*+ MERGE(dt) */
       COUNT(*) AS order_count,
       SUM(dt.amount) AS total_amount
FROM customers_merge_lab c
JOIN (
    SELECT order_id, customer_id, amount
    FROM orders_merge_lab
    WHERE order_status = 'PAID'
) AS dt
  ON dt.customer_id = c.customer_id
WHERE c.region = 'SEOUL';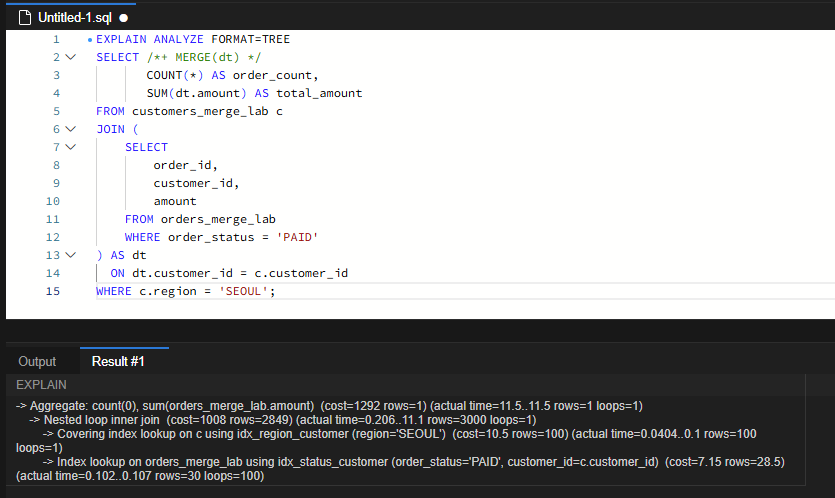
실행계획을 읽는 순서대로 정리하면 이렇습니다.
idx_region_customer로 서울 고객 100명을 Covering index lookup으로 찾습니다.- 고객마다
idx_status_customer에서order_status='PAID'와customer_id를 함께 조건으로 주문을 찾습니다. 두 컬럼 모두 동등 조건이라 상태가 선두인 인덱스로도 정확히 탐색됩니다. - 주문 조회 노드는
rows=30 loops=100입니다. rows는 루프당 평균이므로 조인으로 넘어간 행은 모두 3,000행입니다. - 최상위 Aggregate가 3,000행을 집계해 1행을 반환하며, 완료 시간은 11.5ms입니다.
Materialize 노드는 보이지 않습니다. 서브쿼리 문법으로 썼지만 실제 접근은 일반 조인과 같습니다.
CTE + MERGE
EXPLAIN ANALYZE FORMAT=TREE
WITH paid_orders AS (
    SELECT order_id, customer_id, amount
    FROM orders_merge_lab
    WHERE order_status = 'PAID'
)
SELECT /*+ MERGE(paid_orders) */
       COUNT(*) AS order_count,
       SUM(paid_orders.amount) AS total_amount
FROM customers_merge_lab c
JOIN paid_orders
  ON paid_orders.customer_id = c.customer_id
WHERE c.region = 'SEOUL';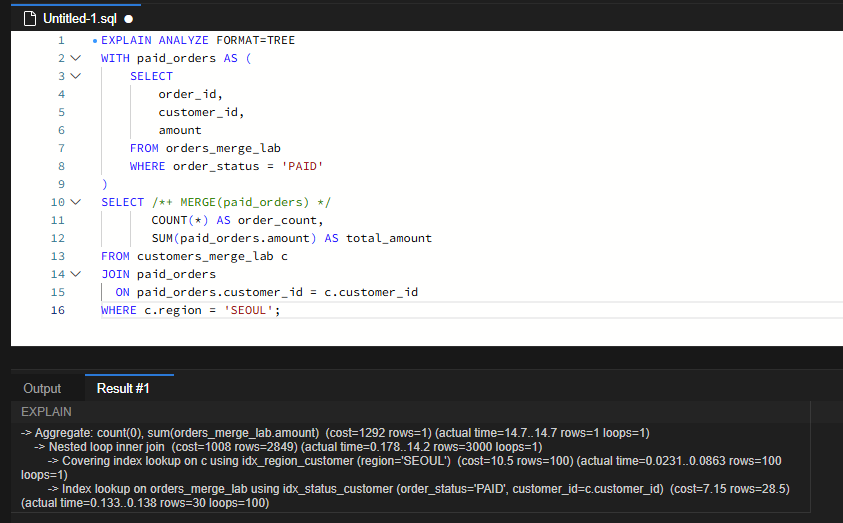
고객 100명 조회, 고객별 주문 인덱스 탐색 100회(평균 30행), 조인 결과 3,000행. Derived Table MERGE와 접근 구조가 똑같고 Materialize 노드도 없습니다. 최상위 완료 시간은 14.7ms입니다. 11.5ms와 14.7ms의 차이는 단일 측정의 편차로 보는 게 맞고, CTE 문법이 더 느리다는 근거는 되지 않습니다.
NO_MERGE일 때: 22만 5천 건을 먼저 만들어 둡니다
Derived Table + NO_MERGE
SQL은 그대로 두고 힌트만 바꿨습니다.
EXPLAIN ANALYZE FORMAT=TREE
SELECT /*+ NO_MERGE(dt) */
       COUNT(*) AS order_count,
       SUM(dt.amount) AS total_amount
FROM customers_merge_lab c
JOIN (
    SELECT order_id, customer_id, amount
    FROM orders_merge_lab
    WHERE order_status = 'PAID'
) AS dt
  ON dt.customer_id = c.customer_id
WHERE c.region = 'SEOUL';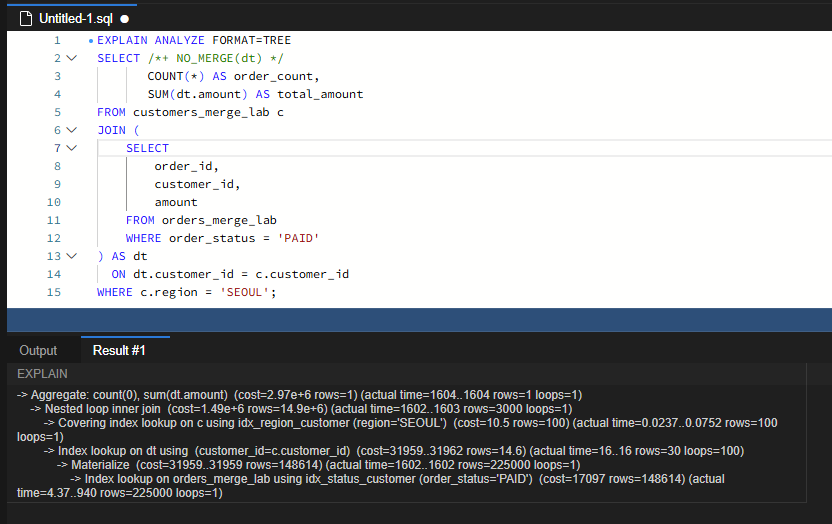
서울 고객 100명을 찾는 부분은 같고, 주문을 가져오는 방식이 달라졌습니다.
| 노드 | 마지막 행까지 actual time | 실제 행 수·반복 |
|---|---|---|
| PAID 주문 인덱스 조회 | 940ms | rows=225000, loops=1 |
| Materialize | 1,602ms | rows=225000, loops=1 |
| Index lookup on dt | 16ms (루프당 평균) | rows=30, loops=100 |
| 최상위 Aggregate | 1,604ms | rows=1, loops=1 |
이 표는 그대로 읽으면 오해하기 쉬운 부분이 있습니다.
시간은 누적값입니다. Materialize의 1,602ms에는 아래 노드의 940ms가 이미 들어 있으니 두 값을 더하면 안 됩니다.
구체화는 한 번만 일어났습니다. Materialize는 loops=1입니다. 225,000행을 고객마다 다시 만든 게 아니라, 한 번 만든 임시 테이블을 고객 번호로 100번 조회했습니다. 구체화 결과를 Index lookup on dt로 찾았다는 건 MySQL이 임시 테이블에 고객 번호 기준의 자동 인덱스를 만들어 썼다는 뜻입니다.
루프 평균 시간에는 일회성 비용이 섞입니다. Index lookup on dt의 16ms는 루프당 평균입니다. 첫 루프에서 실행된 1.6초짜리 구체화가 100번으로 나뉘어 평균에 반영된 것으로 볼 수 있고, 실제로 16ms × 100 ≈ 1,600ms로 Materialize 시간과 맞아떨어집니다. 고객 한 명당 16ms씩 걸렸다고 읽으면 틀립니다.
PAID 주문 조회의 예상 행 수는 148,614행, 실제는 225,000행이었습니다. 추정과 실제의 차이도 EXPLAIN ANALYZE로 실행해 봐야 보이는 정보입니다. 예상 행 수가 어긋나는 원인은 EXPLAIN ANALYZE 예상·실제 행 수 글에서 따로 다뤘습니다.
최종 조인 결과는 MERGE와 같은 3,000행인데, 완료 시간은 11.5ms에서 1,604ms로 늘었습니다.
CTE + NO_MERGE
EXPLAIN ANALYZE FORMAT=TREE
WITH paid_orders AS (
    SELECT order_id, customer_id, amount
    FROM orders_merge_lab
    WHERE order_status = 'PAID'
)
SELECT /*+ NO_MERGE(paid_orders) */
       COUNT(*) AS order_count,
       SUM(paid_orders.amount) AS total_amount
FROM customers_merge_lab c
JOIN paid_orders
  ON paid_orders.customer_id = c.customer_id
WHERE c.region = 'SEOUL';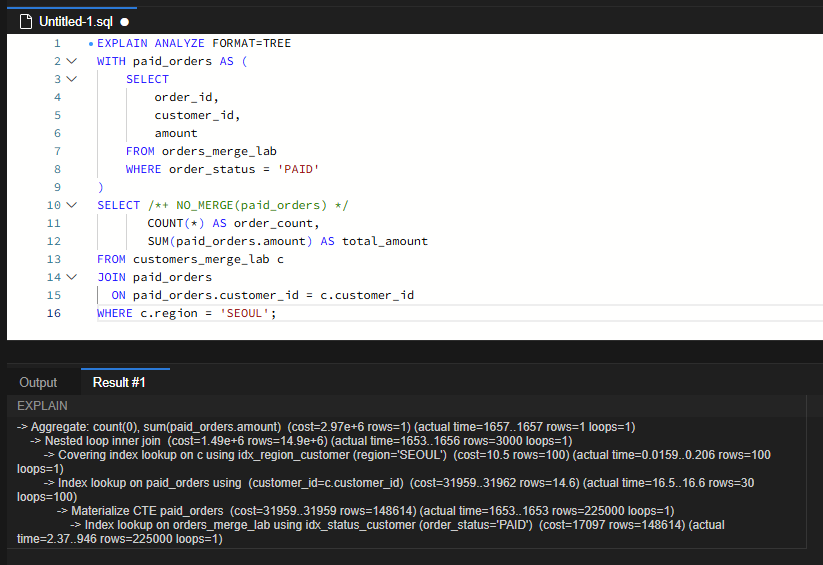
이번에는 Materialize CTE paid_orders 노드가 나타납니다. 원본 PAID 주문 조회가 225,000행을 반환하며 946ms, CTE 구체화 완료가 1,653ms, 최상위 집계 완료가 1,657ms입니다. Derived Table과 마찬가지로 구체화는 한 번 실행됐습니다. WITH 절로 썼다고 해서 구체화 비용이 사라지지는 않습니다.
Performance Schema로 본 임시 테이블과 메모리
실행계획과는 별도로, EXPLAIN ANALYZE 없이 SELECT만 실행한 뒤 Performance Schema의 완료 문장 기록에서 실행 시간, 임시 테이블 수, 최대 메모리를 수집했습니다.
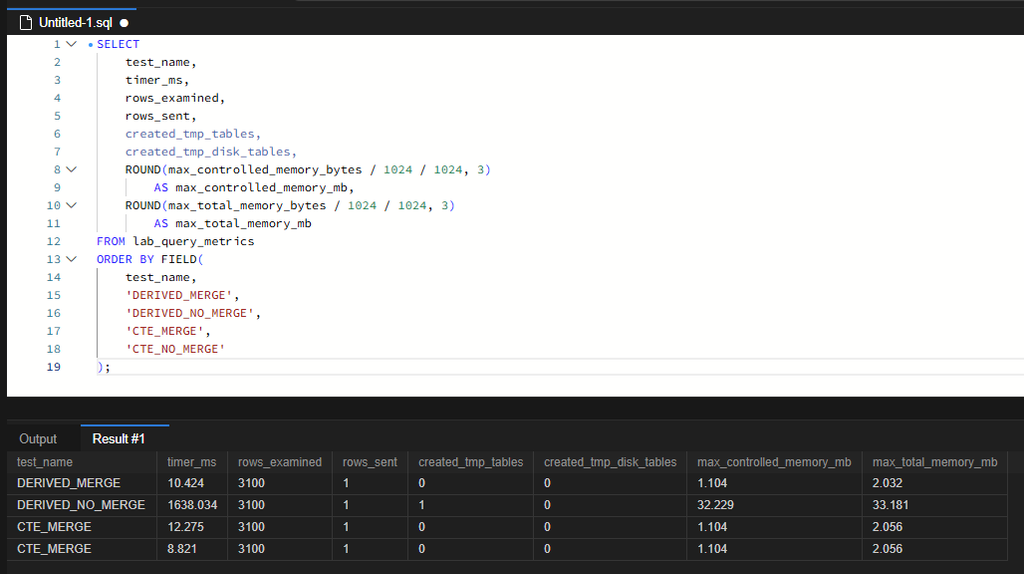
빠진 CTE_NO_MERGE 자리에는 CTE_MERGE가 한 번 더 기록돼 있어서, 아래 표는 Derived MERGE, Derived NO_MERGE, CTE MERGE 세 가지만 놓고 비교합니다.
| 항목 | Derived MERGE | Derived NO_MERGE | CTE MERGE |
|---|---|---|---|
| 문장 실행 시간 | 10.424ms | 1,638.034ms | 12.275ms |
| ROWS_EXAMINED | 3,100 | 3,100 | 3,100 |
| ROWS_SENT | 1 | 1 | 1 |
| 내부 임시 테이블 수 | 0 | 1 | 0 |
| 디스크 임시 테이블 수 | 0 | 0 | 0 |
| 최대 controlled memory | 1.104MiB | 32.229MiB | 1.104MiB |
| 최대 total memory | 2.032MiB | 33.181MiB | 2.056MiB |
측정 SQL의 컬럼명은 _mb로 붙였지만 바이트를 1024로 두 번 나눈 값이라 단위는 MiB입니다.
NO_MERGE에서만 내부 임시 테이블이 1개 생겼고, 최대 total memory는 약 16배 늘었습니다. 이 값은 해당 문장이 실행되는 동안 기록된 최대 메모리 지표라서, 임시 테이블 데이터 크기나 MySQL 프로세스 전체 사용량과는 다릅니다. controlled memory와 total memory는 측정 범위가 다른 지표이므로 서로 더하지 않습니다. 각 컬럼의 의미는 Performance Schema 문장 이벤트 문서에서 확인할 수 있습니다.
디스크 임시 테이블이 0이라는 건 이 문장에서 디스크로 넘어간 기록이 없다는 뜻입니다. 데이터가 더 크거나 메모리 한도가 작으면 결과는 달라질 수 있고, 임시 테이블이 디스크로 넘어가는 조건은 TempTable 디스크 전환 글에서 확인할 수 있습니다.
실행계획의 1,604ms와 Performance Schema의 1,638ms는 서로 다른 실행에서 얻은 값입니다. 측정 방식과 시점이 다르기 때문에 평균처럼 섞지 않았습니다.
ROWS_EXAMINED만 보면 놓치는 비용
이번 측정에서 운영 관점으로 가장 눈여겨볼 부분입니다. 세 경우 모두 ROWS_EXAMINED는 3,100(고객 100 + 주문 3,000)으로 같았습니다. 그런데 NO_MERGE 실행계획에는 225,000행을 읽고 구체화하는 단계가 분명히 있습니다.
ROWS_EXAMINED는 서버 계층의 행 검사 카운터이고, 내부에서 처리한 행을 모두 합산하는 지표가 아닙니다. 이번 결과에서도 구체화 과정에서 읽은 행은 이 값에 드러나지 않았습니다.
슬로우 쿼리 로그나 sys 스키마에서 ROWS_EXAMINED만 보고 “읽는 행이 적으니 가벼운 쿼리”라고 판단하면 이런 비용을 놓치게 됩니다. 행 수에 비해 실행 시간이 지나치게 길다면 EXPLAIN ANALYZE로 Materialize 노드의 실제 행 수를 확인하고, 임시 테이블 수와 메모리 지표도 함께 봐야 합니다.
운영 SQL에 적용할 때
힌트는 대상 이름과 위치를 정확히
Derived Table 별칭이 dt라면 바깥 SELECT에 MERGE(dt)를, CTE 참조 이름이 paid_orders라면 그 CTE를 사용하는 SELECT에 MERGE(paid_orders)를 씁니다. 별칭이 있으면 힌트도 별칭을 대상으로 해야 합니다. 문법은 MySQL 옵티마이저 힌트 문서를 참고하면 됩니다.
힌트보다 기본 플랜 확인이 먼저
이번 비교는 MERGE와 NO_MERGE를 비교한 것이고, 힌트가 없는 SQL과 비교한 것은 아닙니다. 기본 설정에서 이미 병합되고 있다면 MERGE 힌트를 넣어도 달라지는 건 없습니다. 힌트는 기본 플랜이 구체화를 선택해서 문제가 될 때 쓰는 도구입니다.
병합이 안 되는 구조는 힌트로 바뀌지 않습니다
안쪽 쿼리에 GROUP BY, DISTINCT, LIMIT, 집계 함수, 윈도 함수 등이 있으면 MERGE 힌트를 줘도 병합되지 않습니다. 이번 테스트 쿼리는 COUNT·SUM이 바깥 블록에 있고 안쪽에는 집계가 없어서 병합할 수 있었습니다.
MySQL 8.0.22부터는 바깥 WHERE 조건을 파생 테이블 안쪽으로 자동으로 내려 주는 Derived Condition Pushdown도 있습니다. 하지만 모든 쿼리에 적용되는 것은 아니므로, 조건이 실제로 안쪽에서 처리되는지는 실행계획으로 확인해야 합니다.
정산 화면 사례에서 바꾼 것
도입부의 월별 정산 화면 쿼리가 바로 이 경우였습니다. 서브쿼리 안에서 거래처별 집계를 하고 있어서, 모든 거래처의 정산 데이터를 다 집계한 뒤에야 바깥에서 요청한 거래처 하나를 골라냈습니다.
이때는 WITH 절로 형태만 바꾸지 않았습니다. 집계 기준인 거래처 필터 조건을 서브쿼리 안에 명시해서, 처음부터 필요한 거래처만 집계하도록 수정했습니다. 변경 전후에는 같은 조건으로 결과 건수와 정산 합계가 일치하는지 먼저 확인했고, 그다음 실행계획에서 집계에 들어가는 행 수와 실행 시간을 비교했습니다.
이번 재현과 그 사례가 가리키는 방향은 같습니다. CTE냐 서브쿼리냐보다 중요한 건, 집계하기 전에 불필요한 데이터를 얼마나 줄일 수 있는지입니다.
실행계획에서 확인할 항목
- Materialize 노드가 있는지, 있다면 실제 rows가 최종 결과에 비해 얼마나 큰지
rows × loops로 실제 처리 행 수를 계산했는지- Materialize의 loops(구체화 횟수)와 구체화 결과 조회의 loops를 구분했는지
- 루프 평균 시간에 일회성 구체화 비용이 섞여 있지 않은지
- ROWS_EXAMINED 외에 임시 테이블 수와 메모리 지표도 봤는지
- 같은 결과를 여러 번 참조하는 쿼리인지. 이 경우엔 구체화가 오히려 유리할 수 있습니다. MySQL은 같은 문장 안에서 여러 번 참조된 CTE를 한 번만 구체화합니다. 이번 테스트는 단일 참조라 재사용 이점은 검증하지 않았습니다.
- 메모리 피크가 크다면 동시 실행 상황도 확인했는지. 다만 단일 측정값에 연결 수를 곱해 서버 전체 사용량을 단정하지는 않습니다.



댓글 0
첫 댓글을 남겨보세요.