MySQL SELECT FOR UPDATE 락 대기 해결: Lock Escalation 오해와 1205 타임아웃 분석
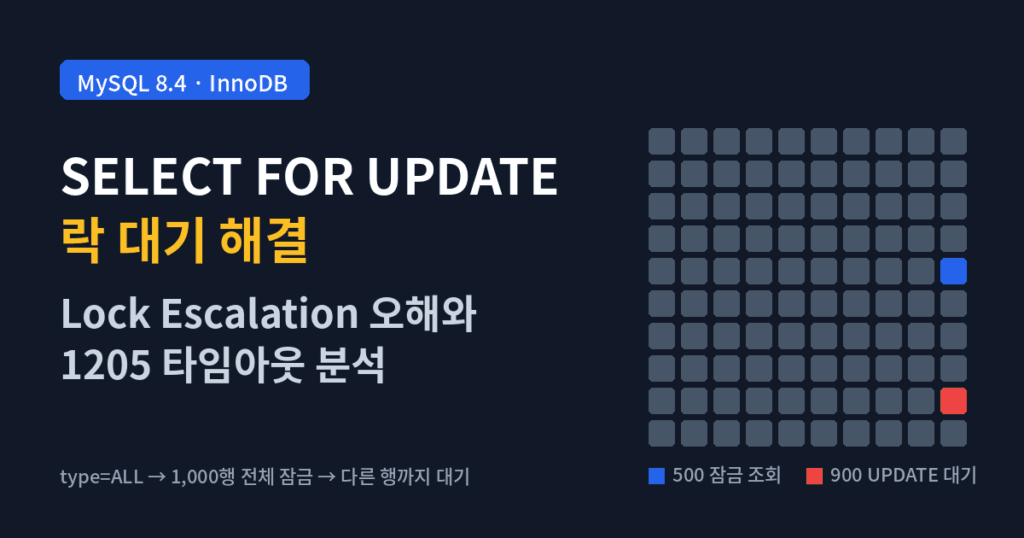
주문 500번을 SELECT ... FOR UPDATE로 잠갔습니다. 그런데 전혀 상관없는 900번 주문의 UPDATE가 멈추더니 30초 뒤 1205 오류로 끝났습니다. 이런 상황에서 data_locks를 열어 TABLE 잠금이 보이면 “행 잠금이 테이블 잠금으로 승격됐다”는 말이 먼저 나옵니다. 하지만 InnoDB에는 그런 승격이 없습니다.
MySQL 8.4.11에서 이 현상을 그대로 재현했습니다. 정말 승격이 일어났는지, 900번 앞의 간격이 문제였는지, 아니면 A가 500번을 찾는 동안 다른 행까지 잠갔는지를 캡처로 하나씩 확인했습니다. 뒤쪽에는 운영에서 잠금 대기 연락을 받았을 때 실제로 확인하는 순서와, 연락이 오지 않는 대기를 점검에서 찾는 방법을 적었습니다.
재현 환경과 테스트 테이블
| 항목 | 재현 조건 |
|---|---|
| MySQL 버전 | 8.4.11 (InnoDB) |
| 격리 수준 | REPEATABLE READ |
| 데이터 | 1,000행, id가 기본키 |
| 초기 인덱스 | order_no에 인덱스 없음 |
| 기본 설정 | autocommit=ON, innodb_lock_wait_timeout=50 |
| 재현 설정 | 세션 B만 락 대기 제한 30초 |
| 타임아웃 처리 | innodb_rollback_on_timeout=OFF |
CREATE TABLE dba_for_update_lab (
    id        INT         NOT NULL,
    order_no  VARCHAR(20) NOT NULL,
    quantity  INT         NOT NULL,
    PRIMARY KEY (id)
) ENGINE = InnoDB DEFAULT CHARSET = utf8mb4;

INSERT INTO dba_for_update_lab (id, order_no, quantity)
WITH RECURSIVE seq (n) AS (
    SELECT 1
    UNION ALL
    SELECT n + 1 FROM seq WHERE n < 1000
)
SELECT n, CONCAT('ORD-', LPAD(n, 6, '0')), 100
FROM seq;
연결은 세 개를 썼습니다. 세션 A가 잠금을 잡고, 세션 B가 다른 행을 수정하고, 세션 C가 잠금 상태를 관찰합니다. autocommit=ON이어도 START TRANSACTION으로 연 트랜잭션은 COMMIT이나 ROLLBACK 전까지 유지됩니다.
현상: 500번을 잠갔는데 900번 UPDATE가 1205로 끝납니다
세션 A에서 500번 주문을 잠금 조회하고 트랜잭션을 열어 둡니다.
START TRANSACTION;

SELECT id, order_no, quantity
FROM dba_for_update_lab
WHERE order_no = 'ORD-000500'
FOR UPDATE;
세션 B에서는 900번 행을 기본키로 수정합니다.
SET SESSION innodb_lock_wait_timeout = 30;

START TRANSACTION;

UPDATE dba_for_update_lab
SET quantity = quantity - 1
WHERE id = 900;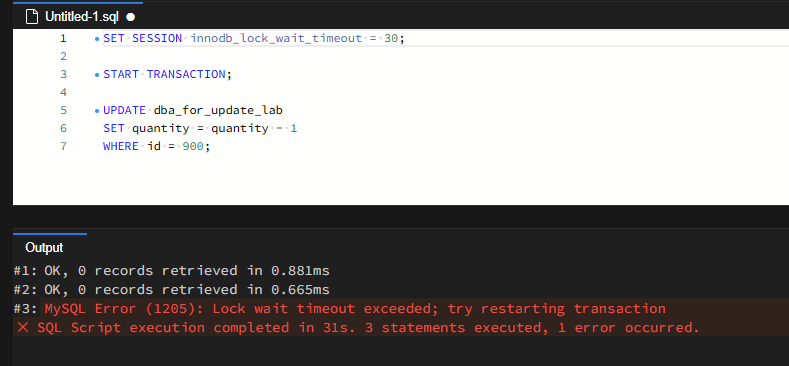
MySQL Error (1205):
Lock wait timeout exceeded; try restarting transaction
기본키로 한 행만 찾는 UPDATE가 30초를 기다린 뒤 실패했습니다. 도구에 찍힌 스크립트 전체 시간은 31초로, 설정한 대기 제한과 거의 같습니다. B의 SQL에는 고칠 곳이 없습니다. 원인은 먼저 잠금을 잡은 A 쪽에 있다고 보고, 후보를 하나씩 확인했습니다.
TABLE/IX는 보였지만 레코드 잠금 1,005개는 그대로였습니다
세션 C에서 테이블의 잠금을 인덱스와 모드별로 집계했습니다. DATABASE()로 거르므로 관찰 연결에서도 테스트 DB를 먼저 선택해야 합니다.
SELECT
    t.PROCESSLIST_ID AS connection_id,
    dl.INDEX_NAME    AS index_name,
    dl.LOCK_TYPE     AS lock_type,
    dl.LOCK_MODE     AS lock_mode,
    dl.LOCK_STATUS   AS lock_status,
    COUNT(*)         AS lock_entries
FROM performance_schema.data_locks AS dl
LEFT JOIN performance_schema.threads AS t
    ON t.THREAD_ID = dl.THREAD_ID
WHERE dl.OBJECT_SCHEMA = DATABASE()
  AND dl.OBJECT_NAME = 'dba_for_update_lab'
GROUP BY
    t.PROCESSLIST_ID, dl.INDEX_NAME,
    dl.LOCK_TYPE, dl.LOCK_MODE, dl.LOCK_STATUS
ORDER BY connection_id, lock_type, index_name, lock_mode;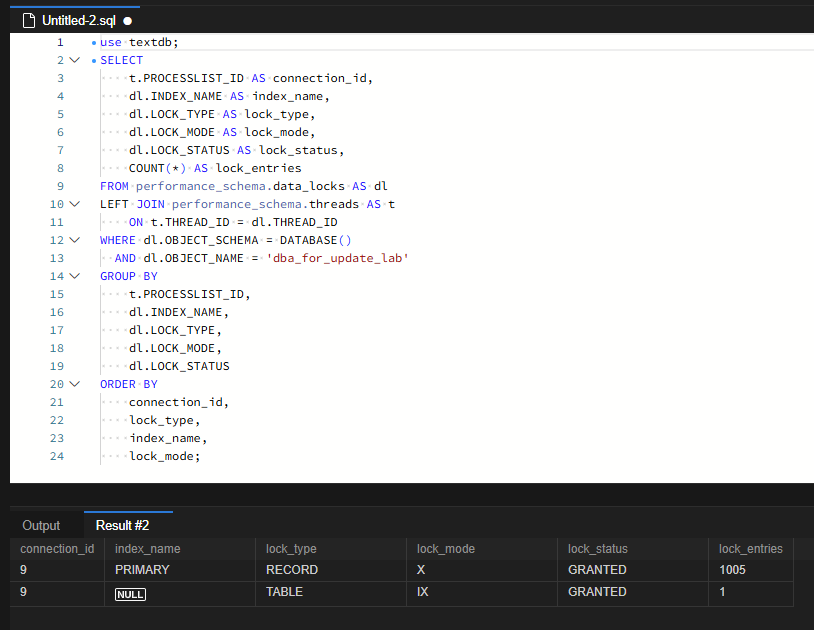
결과는 두 줄입니다. 9번 연결(A)이 PRIMARY에 RECORD/X 항목 1,005개, 그리고 TABLE/IX 1개를 갖고 있습니다.
승격을 의심하게 만드는 것이 TABLE/IX입니다. 그런데 IX는 “이 테이블의 일부 레코드에 배타 잠금을 걸겠다”는 의도 잠금으로, 테이블 전체를 막는 TABLE/X와는 다릅니다. IX끼리는 호환되므로 B도 IX를 문제없이 얻습니다. 게다가 레코드 잠금 1,005개가 그대로 남아 있습니다. 승격이 일어났다면 레코드 잠금이 테이블 잠금 하나로 바뀌었어야 하는데, 그런 흔적이 없습니다. InnoDB는 행 잠금 개수가 많다는 이유로 테이블 잠금으로 승격하지 않습니다.
1,005라는 숫자를 업무 행 1,005개로 읽으면 안 됩니다. data_locks에는 마지막 레코드 뒤를 뜻하는 supremum 같은 내부 의사 레코드도 항목으로 잡힙니다. 1,000을 넘는 5개가 무엇인지는 이 집계만으로 확정하지 않았고, 직접 보려면 숫자가 아닌 LOCK_DATA만 골라 조회하면 됩니다.
SELECT LOCK_MODE, LOCK_DATA
FROM performance_schema.data_locks
WHERE OBJECT_SCHEMA = DATABASE()
  AND OBJECT_NAME = 'dba_for_update_lab'
  AND LOCK_TYPE = 'RECORD'
  AND LOCK_DATA NOT REGEXP '^[0-9]+$';
B가 기다린 잠금은 900번 레코드 하나였습니다
LOCK_MODE X는 레코드와 그 앞 간격을 함께 잠그는 넥스트키 락입니다. 그래서 간격 쪽에서 충돌했을 가능성도 확인해야 했습니다. B가 정확히 무엇을 기다리는지 data_lock_waits로 조회했습니다.
SELECT
    rt.PROCESSLIST_ID AS waiting_connection,
    bt.PROCESSLIST_ID AS blocking_connection,
    r.INDEX_NAME      AS waiting_index,
    r.LOCK_MODE       AS waiting_lock_mode,
    r.LOCK_STATUS     AS waiting_status,
    r.LOCK_DATA       AS waiting_lock_data,
    b.LOCK_MODE       AS blocking_lock_mode,
    b.LOCK_DATA       AS blocking_lock_data
FROM performance_schema.data_lock_waits AS w
JOIN performance_schema.data_locks AS r
    ON r.ENGINE = w.ENGINE
   AND r.ENGINE_LOCK_ID = w.REQUESTING_ENGINE_LOCK_ID
JOIN performance_schema.data_locks AS b
    ON b.ENGINE = w.ENGINE
   AND b.ENGINE_LOCK_ID = w.BLOCKING_ENGINE_LOCK_ID
LEFT JOIN performance_schema.threads AS rt
    ON rt.THREAD_ID = w.REQUESTING_THREAD_ID
LEFT JOIN performance_schema.threads AS bt
    ON bt.THREAD_ID = w.BLOCKING_THREAD_ID
WHERE r.OBJECT_SCHEMA = DATABASE()
  AND r.OBJECT_NAME = 'dba_for_update_lab';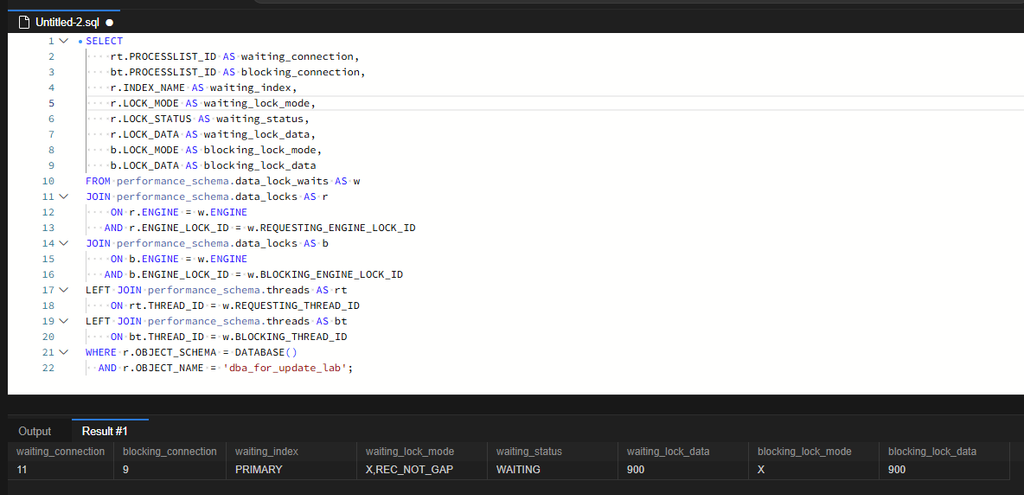
| 항목 | 관측값 |
|---|---|
| 대기 연결 / 차단 연결 | 11 (B) / 9 (A) |
| 대기 인덱스 | PRIMARY |
| 대기 잠금 모드 | X,REC_NOT_GAP (WAITING) |
| 차단 잠금 모드 | X |
| 대기·차단 LOCK_DATA | 모두 900 |
B가 요청한 잠금은 X,REC_NOT_GAP, 즉 900번 레코드 자체만 잠그는 잠금입니다. 간격에는 관심이 없는 요청이니 갭 락과 부딪힐 일이 없습니다. 충돌한 지점은 A가 900번 레코드에 쥐고 있는 X(넥스트키 락)의 레코드 부분입니다. “갭 락 때문”이라는 설명은 이 관측과 맞지 않습니다.
그러면 남는 질문은 하나입니다. 500번을 찾았을 뿐인 A가 왜 900번 레코드를 잠그고 있을까요.
500번을 찾느라 1,000행을 모두 지나갔습니다
A의 조회 경로를 실행계획으로 봤습니다.
EXPLAIN
SELECT id, order_no, quantity
FROM dba_for_update_lab
WHERE order_no = 'ORD-000500'
FOR UPDATE;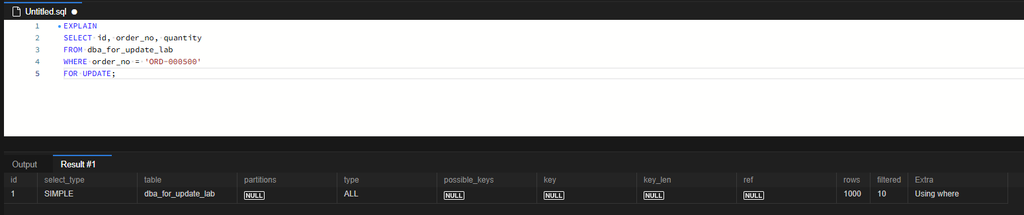
type=ALL, possible_keys=NULL, key=NULL, rows=1000, filtered=10, Extra=Using where입니다. order_no에 인덱스가 없으니 클러스터드 인덱스(PRIMARY)를 처음부터 끝까지 읽습니다.
InnoDB의 잠금 읽기와 UPDATE, DELETE는 WHERE 조건에 맞는지와 상관없이 검색 중에 스캔한 인덱스 레코드에 잠금을 겁니다. REPEATABLE READ에서는 이 잠금이 트랜잭션이 끝날 때까지 유지됩니다. 1,000행을 모두 훑었으니 900번도 A의 잠금 범위에 들어간 것입니다. filtered=10을 보고 “100행쯤 잠겼겠다”고 계산하면 틀립니다. rows와 filtered는 옵티마이저 추정치이고, 잠금은 실제로 읽은 레코드 기준입니다.
스캔 범위 때문이라면 검색 경로를 좁혔을 때 같은 UPDATE가 통과해야 합니다. A와 B를 모두 ROLLBACK하고 order_no에 유일 인덱스를 추가했습니다.
ALTER TABLE dba_for_update_lab
    ADD UNIQUE INDEX uk_order_no (order_no);

EXPLAIN
SELECT id, order_no, quantity
FROM dba_for_update_lab
WHERE order_no = 'ORD-000500'
FOR UPDATE;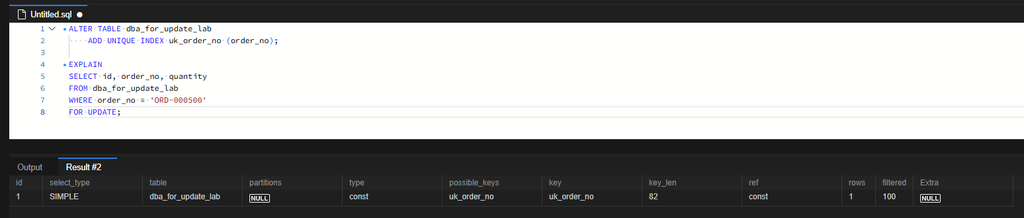
| 항목 | 인덱스 추가 전 | 인덱스 추가 후 |
|---|---|---|
| type | ALL | const |
| key | NULL | uk_order_no |
| 추정 rows | 1000 | 1 |
| filtered | 10 | 100 |
유일 인덱스 전체를 동등 조건으로 검색해 존재하는 한 행을 찾으면, InnoDB는 그 인덱스 레코드만 잠그고 앞 간격은 잠그지 않습니다. 보조 인덱스 레코드와 대응하는 PRIMARY 레코드에 각각 잠금이 걸릴 수 있어 항목이 꼭 1개는 아니지만, 900번까지 번질 이유는 없어집니다. UNIQUE를 고른 건 주문번호가 업무상 유일하다는 전제 때문입니다. 중복이 허용되는 컬럼이면 일반 인덱스를 써야 하고, 그때는 잠금 범위가 이보다 넓을 수 있습니다.
A에서 500번을 다시 FOR UPDATE로 잡아 둔 채, B에서 같은 UPDATE를 실행했습니다.
START TRANSACTION;

UPDATE dba_for_update_lab
SET quantity = quantity - 1
WHERE id = 900;

SELECT id, order_no, quantity
FROM dba_for_update_lab
WHERE id = 900;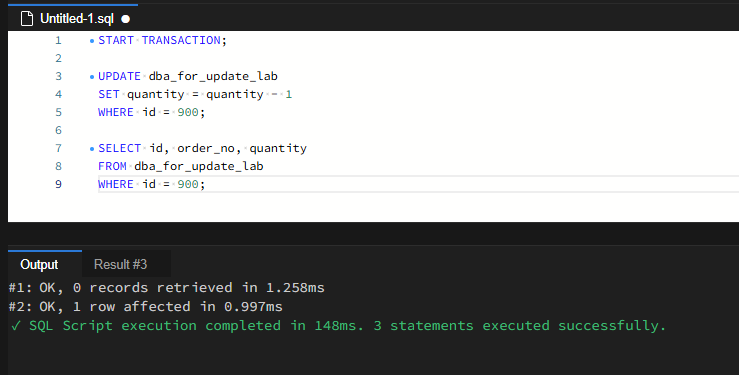
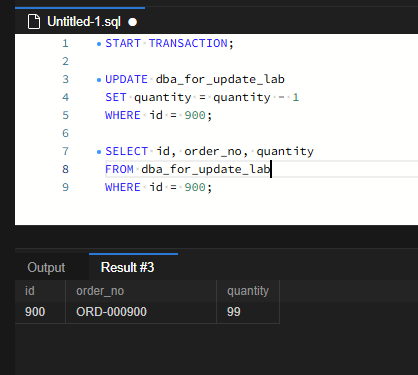
이번에는 기다리지 않고 1행이 수정됐고, quantity가 초기값 100에서 99로 줄었습니다. UPDATE 단계 표시 시간 0.997ms는 이 한 번의 실행값일 뿐이라 성능 개선 폭으로 일반화하지 않았습니다. 같은 세션에서 바뀐 값이 보인다고 COMMIT된 것은 아니므로 확인이 끝난 뒤 A와 B 모두 ROLLBACK했습니다.
인덱스 하나로 같은 UPDATE가 바로 통과했습니다. 900번을 막은 것은 승격된 테이블 잠금이나 간격 잠금이 아니라, 인덱스 없는 잠금 읽기가 전체 스캔을 하면서 지나간 레코드마다 남긴 잠금이었습니다.
1205 뒤에 트랜잭션이 열린 채 남는 문제
innodb_lock_wait_timeout은 행 잠금을 기다리는 시간 제한입니다. SQL 전체 실행 시간이나 애플리케이션 요청 시간을 제한하는 값이 아닙니다.
이번 환경처럼 innodb_rollback_on_timeout=OFF이면 타임아웃은 실패한 문장만 되돌리고 트랜잭션은 열어 둡니다. 같은 트랜잭션에서 먼저 실행한 변경은 남아 있다는 뜻이니, 업무 단위 전체를 실패로 처리하려면 ROLLBACK을 직접 실행해야 합니다. 프레임워크가 예외 시 자동으로 롤백하는지는 트랜잭션 경계 설정에 따라 다르므로 따로 확인해야 합니다. 이번에는 타임아웃 발생까지만 확인했습니다. 1205 뒤에 앞선 변경이 실제로 남는 모습은 1205 이후 트랜잭션 상태 글에서 따로 재현했습니다.
ROLLBACK;운영에서 처리 요청이 오면 세션부터 봅니다
위 재현에서는 잠금 테이블부터 들여다봤지만, 운영에서 “지금 처리가 안 된다”는 연락을 받으면 순서가 다릅니다. 저는 세션 조회부터 합니다. 트랜잭션이 가장 오래된 순으로 정렬해서 의심되는 세션을 먼저 추립니다.
SELECT
    trx.trx_mysql_thread_id AS connection_id,
    trx.trx_started,
    TIMESTAMPDIFF(SECOND, trx.trx_started, NOW()) AS trx_age_seconds,
    trx.trx_state,
    trx.trx_rows_locked,
    trx.trx_query,
    p.USER,
    p.HOST,
    p.COMMAND,
    p.TIME AS process_state_seconds
FROM information_schema.innodb_trx AS trx
LEFT JOIN performance_schema.processlist AS p
    ON p.ID = trx.trx_mysql_thread_id
ORDER BY trx.trx_started;
이 결과를 볼 때 두 가지를 조심합니다. trx_query가 NULL이어도 트랜잭션은 열려 있을 수 있습니다. SQL을 다 실행하고 COMMIT 없이 Sleep 상태로 남은 세션이 여기에 해당하고, 이런 세션을 실제로 찾아낸 과정은 data_locks와 data_lock_waits 글에 적었습니다. 또 p.TIME은 현재 상태가 이어진 시간이라, 트랜잭션이 얼마나 오래 열렸는지는 trx_started로 봐야 합니다. 다른 연결의 정보를 보려면 PROCESS 권한이 필요합니다.
후보를 추린 다음 락 조회로 실제 블로커를 확인합니다. 앞에서 쓴 data_lock_waits 조인 쿼리를 써도 되고, 빠르게 볼 때는 sys 스키마 뷰가 편합니다.
SELECT
    wait_age,
    locked_table,
    locked_index,
    waiting_pid,
    waiting_query,
    blocking_pid,
    blocking_query
FROM sys.innodb_lock_waits;
블로커를 찾았다고 바로 KILL하지는 않습니다. 해당 세션의 담당자에게 무슨 작업인지 확인하고 나서 KILL합니다. KILL하면 그 세션이 진행하던 트랜잭션이 통째로 롤백되는데, 그 작업이 배치나 수작업 데이터 보정이라면 롤백 자체가 또 다른 문제가 될 수 있기 때문입니다. 변경량이 큰 트랜잭션은 롤백에도 시간이 걸려서, KILL 직후 잠금이 바로 풀리지 않을 수도 있습니다. RDS에서는 KILL 대신 CALL mysql.rds_kill(연결번호);를 사용합니다.
급한 불을 끈 뒤에야 블로커가 실행한 SQL의 실행계획을 봅니다. 이번 재현으로 치면 900번 UPDATE가 아니라 500번을 잠근 SELECT … FOR UPDATE를 보는 단계입니다. 대기한 쪽 SQL을 아무리 튜닝해도 차단한 쪽의 검색 경로가 그대로면 같은 일이 반복됩니다.
실시간이 아닐 때는 차트에서 이상 구간부터 찾습니다
모든 잠금 대기가 연락으로 오는 건 아닙니다. 짧게 대기하다 풀리거나 재시도로 넘어간 건은 아무도 알려 주지 않습니다. 그래서 일점검이나 정기 점검 때는 RDS 콘솔 지표와 별도로 쓰는 모니터링 프로그램의 차트를 먼저 봅니다. 평소와 다른 구간이 보이면 그 시간대의 로그를 찾아 어떤 SQL과 세션이 엮였는지 원인을 확인하고 조치합니다.
실시간 대응이 블로커를 찾아 정리하는 일이라면, 점검은 이번 재현의 인덱스 없는 FOR UPDATE처럼 구조적인 원인을 찾아내는 일에 가깝습니다. 인덱스 없는 잠금 SQL은 평소에는 짧게 끝나서 드러나지 않다가, 트랜잭션이 조금 길어지는 날 한꺼번에 대기를 만듭니다.
인덱스 외에 함께 검토할 것
근본 해결은 잠금 SQL의 검색 경로를 좁히는 인덱스입니다. 다만 그것만으로 끝나지 않는 부분이 있어 함께 정리합니다.
인덱스를 바로 못 만들 때. 대형 테이블은 DDL 일정을 바로 잡기 어려울 수 있습니다. 이때는 잠금 없는 조회로 기본키를 먼저 찾고, 기본키와 원래 조건을 함께 걸어 잠그는 방법을 검토할 수 있습니다. 첫 조회는 여전히 전체 스캔이지만 잠금을 걸지 않아 다른 트랜잭션을 막지 않습니다. 두 번째 조회 결과가 없으면 그 사이 데이터가 바뀐 것이니 처음부터 다시 처리합니다.
SELECT id FROM dba_for_update_lab WHERE order_no = 'ORD-000500';

START TRANSACTION;
SELECT id, order_no, quantity
FROM dba_for_update_lab
WHERE id = 500 AND order_no = 'ORD-000500'
FOR UPDATE;
단순 수량 차감. 남은 수량이 있을 때 1개 빼는 정도라면 조회와 잠금을 나누지 않고 한 문장으로 처리할 수 있습니다. 영향받은 행이 1이면 성공, 0이면 대상이 없거나 재고가 부족한 경우입니다. 같은 행끼리의 경합은 남지만 잠금 보유 시간이 짧아집니다. 여러 테이블 상태를 함께 검증하는 업무까지 대신할 수는 없습니다.
UPDATE dba_for_update_lab
SET quantity = quantity - 1
WHERE id = 900
  AND quantity > 0;
잠금을 쥔 채 외부 응답을 기다리지 않기. FOR UPDATE 뒤에 외부 API 호출이나 사용자 입력 대기가 끼면 그 시간만큼 잠금이 유지됩니다. 준비 작업은 트랜잭션 밖에서 끝내고, 트랜잭션 안에서는 다시 검증한 뒤 짧게 변경하고 끝냅니다.
타임아웃 늘리기, NOWAIT, SKIP LOCKED. 대기 한도를 늘려도 넓은 잠금 범위는 그대로이고 대기 연결만 더 오래 쌓입니다. MySQL 8.0부터 쓸 수 있는 NOWAIT과 SKIP LOCKED도 기다리는 방식을 바꿀 뿐 잠금 범위를 줄이지는 않습니다. 재시도를 넣는다면 횟수 제한과 지연을 두고, 외부 결제나 메시지 발행이 섞인 업무는 DB 롤백으로 취소되지 않으니 중복 실행을 막는 설계가 필요합니다.
READ COMMITTED. READ COMMITTED에서는 WHERE 조건에 맞지 않는 행의 잠금을 조건 평가 뒤 풀어 주므로 이번 같은 대기는 줄어듭니다. 하지만 이번 글은 REPEATABLE READ에서만 재현했고, 격리 수준은 애플리케이션 전체의 읽기 일관성을 바꾸는 설정입니다. 인덱스 문제를 피해 가는 용도로 바꿀 값은 아니라고 봅니다.



댓글 0
첫 댓글을 남겨보세요.