MySQL 로그 파티션 하나를 지우면 무엇이 남나: DELETE·TRUNCATE PARTITION·DROP PARTITION

하루치 파티션을 비우고 지워 나가는 정리 프로시저
운영 DB에서는 로그성 테이블을 테이블 구조에 따라 다르게 정리하고 있습니다. 파티션이 없는 일반 테이블은 일자별로 DELETE합니다. 파티션 로그 테이블은 별도로 개발해 둔 프로시저가 일 파티션을 매일 TRUNCATE로 비운 뒤 DROP까지 하고, 새 파티션은 한 달 치를 미리 만들어 둡니다.
세 명령 모두 오래된 로그를 없앤다는 결과는 같습니다. 하지만 DBA 입장에서는 지우는 순간에 끝나지 않는 차이가 있습니다. binlog에 얼마나 남아 복제본과 보관 공간을 차지하는지, 디스크의 파티션 파일이 어떻게 되는지, 파티션 정의가 바뀐 뒤 들어오는 데이터는 어디에 저장되는지입니다. 이번 테스트에서는 같은 로그를 세 방식으로 지우면서 소요 시간과 함께 이 세 가지를 확인했습니다.
9개월 치 API 요청 로그를 세 테이블에 똑같이 담아 두고
테스트 서버는 Windows의 MySQL Community Server 8.4.11이고, Workbench 연결 하나로 진행했습니다. 설정은 손대지 않았습니다. binlog_format은 ROW, binlog_row_image는 FULL, sync_binlog와 innodb_flush_log_at_trx_commit는 1입니다. 자동 커밋은 켜져 있고 격리 수준은 REPEATABLE-READ이며, binlog 보관 기간 binlog_expire_logs_seconds는 2592000초(30일)입니다.
가상의 API 요청 로그 테이블을 같은 정의로 세 개 만들었습니다. 이름은 지우는 방식에 맞춰 api_log_del, api_log_trunc, api_log_drop으로 붙였습니다. 2026년 1월부터 9월까지 월 단위 RANGE COLUMNS 파티션을 두고, 그 뒤에 pmax를 하나 더 두었습니다.
CREATE TABLE api_log_del (
  id           BIGINT       NOT NULL AUTO_INCREMENT,
  req_dt       DATETIME     NOT NULL,
  api_path     VARCHAR(50)  NOT NULL,
  status_code  SMALLINT     NOT NULL,
  elapsed_ms   INT          NOT NULL,
  request_body VARCHAR(300) NOT NULL,
  PRIMARY KEY (id, req_dt),
  KEY ix_path_dt (api_path, req_dt)
) ENGINE=InnoDB
PARTITION BY RANGE COLUMNS (req_dt) (
  PARTITION p202601 VALUES LESS THAN ('2026-02-01'),
  PARTITION p202602 VALUES LESS THAN ('2026-03-01'),
  PARTITION p202603 VALUES LESS THAN ('2026-04-01'),
  PARTITION p202604 VALUES LESS THAN ('2026-05-01'),
  PARTITION p202605 VALUES LESS THAN ('2026-06-01'),
  PARTITION p202606 VALUES LESS THAN ('2026-07-01'),
  PARTITION p202607 VALUES LESS THAN ('2026-08-01'),
  PARTITION p202608 VALUES LESS THAN ('2026-09-01'),
  PARTITION p202609 VALUES LESS THAN ('2026-10-01'),
  PARTITION pmax    VALUES LESS THAN (MAXVALUE)
);
-- api_log_trunc, api_log_drop도 이름만 다르고 정의는 같습니다.
데이터는 테이블마다 270,000건입니다. 한 달에 30,000건씩 들어가도록, 각 월 1일 0시부터 80초 간격으로 req_dt를 찍었습니다. request_body는 MD5 값을 여덟 번 이어 붙인 256자 문자열입니다. 난수를 쓰지 않았기 때문에 같은 SQL을 다시 돌리면 같은 데이터가 만들어집니다. 적재하는 동안에는 세션의 sql_log_bin을 꺼서, 측정 전에 binlog가 적재 데이터로 불어나지 않게 했습니다.
SET SESSION sql_log_bin = 0;
SET SESSION cte_max_recursion_depth = 300000;

INSERT INTO api_log_del (id, req_dt, api_path, status_code, elapsed_ms, request_body)
WITH RECURSIVE seq (n) AS (
  SELECT 1
  UNION ALL
  SELECT n + 1 FROM seq WHERE n < 270000
)
SELECT n,
       TIMESTAMP('2026-01-01 00:00:00')
         + INTERVAL ((n - 1) DIV 30000) MONTH
         + INTERVAL (((n - 1) MOD 30000) * 80) SECOND,
       ELT(1 + n MOD 5, '/v1/orders', '/v1/login', '/v1/products', '/v1/cart', '/v1/payments'),
       CASE WHEN n MOD 50 = 0 THEN 500 WHEN n MOD 10 = 0 THEN 404 ELSE 200 END,
       20 + (n * 37) MOD 900,
       REPEAT(MD5(n), 8)
FROM seq;

INSERT INTO api_log_trunc SELECT * FROM api_log_del;
INSERT INTO api_log_drop  SELECT * FROM api_log_del;

SET SESSION sql_log_bin = 1;
시작 상태는 세 테이블이 같았습니다. 건수는 모두 270,000건이고 그중 1~3월이 90,000건입니다. 데이터가 든 월 파티션 파일은 모두 20,971,520바이트, 빈 pmax는 131,072바이트였습니다.

한 회차에 세 방식을 번갈아 실행
1월, 2월, 3월 파티션을 차례로 지우면서 회차마다 DELETE, TRUNCATE PARTITION, DROP PARTITION을 한 번씩 번갈아 실행했습니다. 측정 도중 서버 상태가 바뀌더라도 한 방식에만 불리하게 작용하지 않게 하려는 순서입니다. 회차마다 지운 데이터는 매번 다른 달의 30,000건이므로, 세 번 모두 해당 데이터를 처음 지우는 측정입니다.
binlog 증가량은 명령 직전과 직후에 performance_schema.log_status의 binlog 파일 이름과 위치를 읽어 그 차이로 계산했습니다. 시간은 두 가지로 쟀습니다. 하나는 SQL 안에서 NOW(6)의 차이를 구한 값이고, 다른 하나는 events_statements_summary_by_digest에 쌓인 서버 쪽 실행 시간입니다. 아래는 1회차 DELETE 블록입니다. TRUNCATE와 DROP 블록은 가운데 명령만 다릅니다.
SELECT COUNT(*) INTO @rows FROM api_log_del PARTITION (p202601);
SELECT LOCAL->>'$.binary_log_file', LOCAL->>'$.binary_log_position'
  INTO @f0, @p0 FROM performance_schema.log_status;
SET @t0 = NOW(6);
DELETE FROM api_log_del WHERE req_dt >= '2026-01-01' AND req_dt < '2026-02-01';
SET @ms = TIMESTAMPDIFF(MICROSECOND, @t0, NOW(6)) / 1000;
SELECT LOCAL->>'$.binary_log_file', LOCAL->>'$.binary_log_position'
  INTO @f1, @p1 FROM performance_schema.log_status;
INSERT INTO cleanup_result (method, part_name, run_no, target_rows, elapsed_ms,
       binlog_file_before, pos_before, binlog_file_after, pos_after, binlog_bytes)
VALUES ('DELETE', 'p202601', 1, @rows, @ms, @f0, @p0, @f1, @p1, @p1 - @p0);

-- TRUNCATE, DROP 블록의 가운데 명령
ALTER TABLE api_log_trunc TRUNCATE PARTITION p202601;
ALTER TABLE api_log_drop DROP PARTITION p202601;
세 번씩 번갈아 지운 시간과 binlog 증가량
| 방식 | 서버 실행 시간 (ms, 1·2·3회) | 서버 기준 대표값 | NOW(6) 중앙값 | 1회 binlog 증가량 |
|---|---|---|---|---|
| DELETE | 3회 합계 2,293.835 | 평균 764.612ms | 843.360ms | 8,717,020바이트 |
| TRUNCATE PARTITION | 55.985 / 67.655 / 84.373 | 중앙값 67.655ms | 163.395ms | 227바이트 |
| DROP PARTITION | 45.891 / 37.611 / 30.676 | 중앙값 37.611ms | 106.507ms | 238바이트 |
DELETE의 서버 실행 시간은 회차별 값 대신 평균만 적었습니다. 세 번의 DELETE가 조건 값만 다르고 문장 구조가 같아서, digest 하나로 묶여 합계만 남았기 때문입니다. 반면 ALTER 문은 파티션 이름이 식별자로 들어가 회차마다 따로 집계됐습니다.
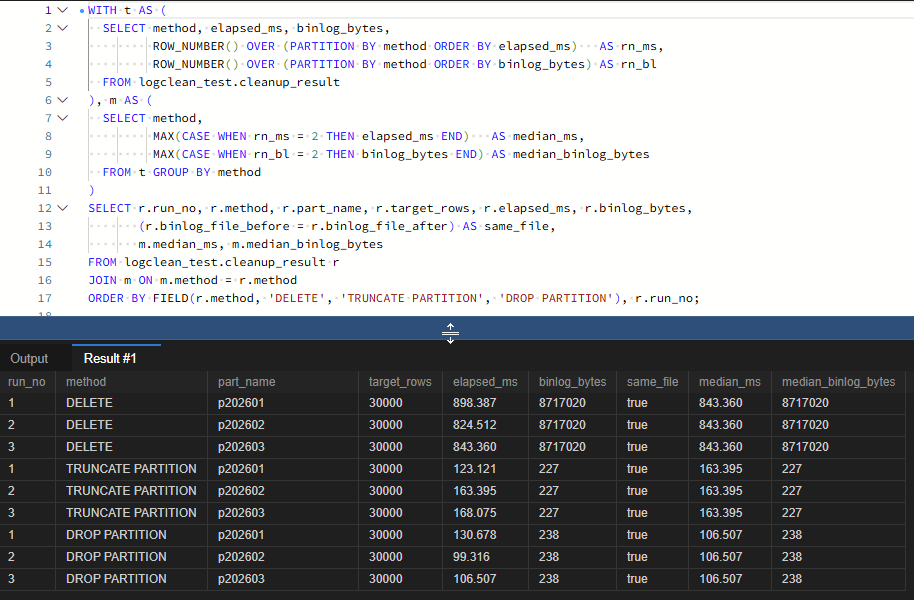
한 달 치 30,000건을 지우는 데 DELETE는 TRUNCATE PARTITION보다 약 11배, DROP PARTITION보다 약 20배 오래 걸렸습니다. 두 DDL끼리는 DROP이 세 번 모두 빨랐고, 두 측정 방식 모두에서 같은 결과였습니다. TRUNCATE는 파티션 파일을 지운 뒤 빈 파일을 다시 만들어야 하고 DROP은 지우는 데서 끝나므로, 그 차이가 시간으로 나타난 것으로 보입니다.
회차별로 보면 TRUNCATE는 55.985ms에서 84.373ms로 늘고, DROP은 45.891ms에서 30.676ms로 줄었습니다. 다만 세 번만으로 추세라고 보기는 어렵고, 원인도 이번에는 확인하지 못했습니다. 측정한 크기도 30,000건 한 가지뿐이어서, 파티션이 커질 때 DELETE와의 격차가 얼마나 벌어지는지는 이번 결과로 말할 수 없습니다.
NOW(6)으로 잰 값은 서버 실행 시간보다 회차마다 60~100ms가량 컸습니다. Workbench가 SET, ALTER, SET을 한 문장씩 서버에 보내면서 생긴 왕복 시간이 섞인 것으로 추정합니다. 그래서 명령 자체의 비용은 서버 기준 값으로 읽었습니다.
binlog를 열어 보면 보이는 이벤트의 차이
시간보다 차이가 컸던 것은 binlog입니다. DELETE는 한 번에 8,717,020바이트를 남겼습니다. 30,000건으로 나누면 행 하나당 약 290바이트입니다. binlog_row_image=FULL이므로, 지워진 행의 모든 컬럼 값이 256자짜리 request_body까지 그대로 binlog에 기록된 것입니다.
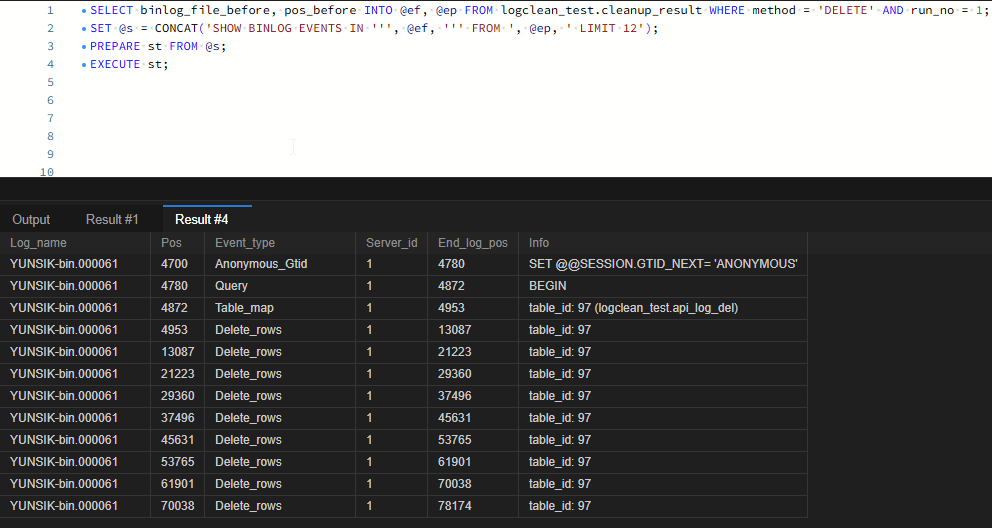
캡처에 보이는 Delete_rows 이벤트 하나는 위치 차이로 보면 8,134~8,137바이트입니다. 증가량 전체를 이 크기로 나누면 30,000건 삭제가 약 1,070개의 이벤트로 나뉘어 기록된 셈입니다. 세 번의 DELETE를 합치면 26,151,060바이트이고, 이 binlog는 보관 기간 30일 동안 디스크에 남습니다. 보관 기간과 PURGE를 다룰 때 따져 볼 점은 binlog 보관 기간과 안전한 PURGE 글에 따로 정리했습니다.
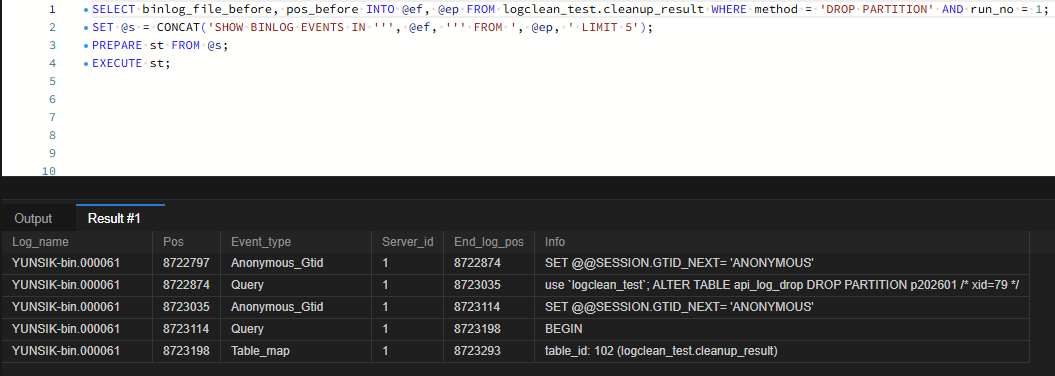
DROP PARTITION은 Anonymous_Gtid 77바이트와 Query 161바이트를 합쳐 238바이트였습니다. TRUNCATE PARTITION도 구조가 같아서 Anonymous_Gtid 77바이트와 Query 150바이트, 합계 227바이트였습니다. binlog에는 30,000건이 아니라 ALTER TABLE ... TRUNCATE PARTITION p202601 문장 하나만 남습니다.
이 차이는 운영에서 두 방향으로 작용합니다. 복제본은 DELETE의 경우 행 이벤트를 모두 받아 적용해야 하지만, DDL은 문장 하나만 실행하면 됩니다. 반대로 DELETE의 행 이미지는 잘못 지운 행을 binlog에서 찾아 되살릴 근거가 되는 반면, TRUNCATE와 DROP의 binlog에는 지운 값이 남지 않습니다. 파티션을 비우는 명령은 실행 전에 대상 파티션 이름을 한 번 더 확인해야 하는 이유입니다.
같은 18만 건이 남았는데 파일과 정의는 달랐다
정리가 끝난 뒤 세 테이블에 남은 건수는 모두 180,000건이고, 1~3월 데이터는 셋 다 0건입니다. 행 기준으로는 결과가 같습니다. 차이는 디스크와 파티션 정의에서 드러났습니다.
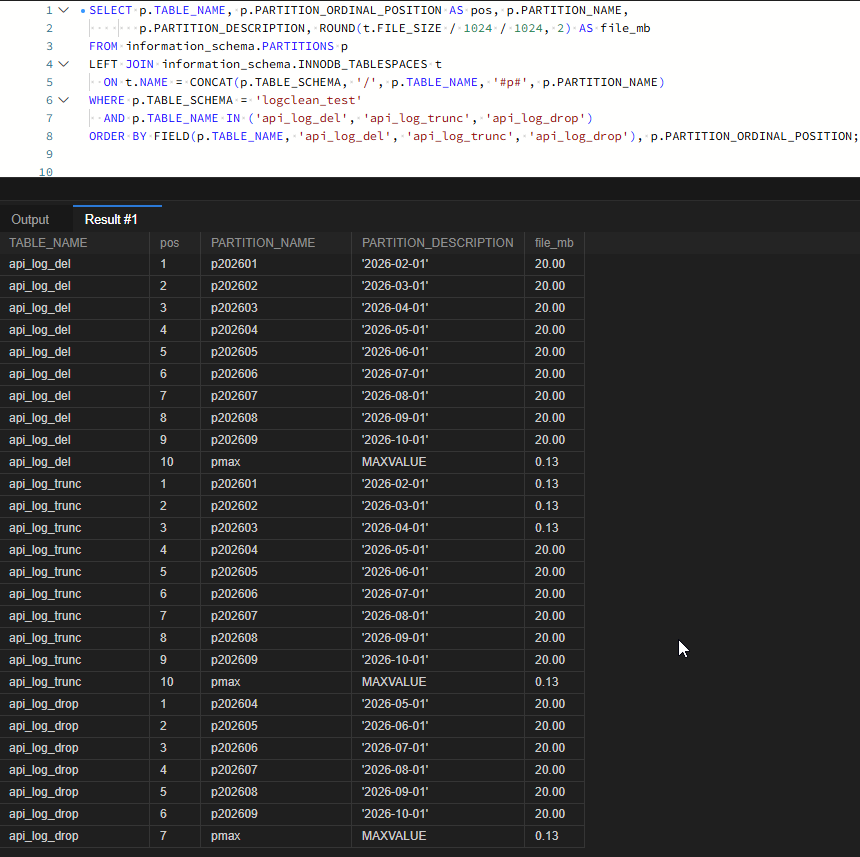
api_log_del의 p202601~p202603은 행이 하나도 없는데 파일은 각각 20.00MB로 남았습니다. 세 개를 합치면 60MB가 빈 공간으로 묶여 있는 셈입니다. DELETE 뒤 파일이 줄지 않는 이유와 공간을 돌려받는 방법은 DELETE 후 파일 크기가 줄지 않는 이유 글에서 다뤘습니다.
api_log_trunc는 같은 세 파티션이 131,072바이트로 바뀌었습니다. 처음부터 비어 있던 pmax와 같은 크기이므로, 파일을 새로 만든 것으로 보입니다. 파티션 이름과 경계값, 순서(pos 1~10)는 그대로 남았습니다. api_log_drop은 파일과 함께 정의도 사라져 p202604가 첫 번째 파티션이 됐습니다.
공간만 놓고 보면 TRUNCATE로도 충분합니다. 다만 비운 파티션을 그대로 두면 정의가 계속 쌓입니다. 운영 프로시저가 TRUNCATE에서 끝내지 않고 DROP까지 하는 구조와 비교해 보면, 공간 회수와 정의 정리가 두 명령에 나뉘어 있다는 점이 이번 결과에서 그대로 보입니다.
DELETE가 맞는 경우도 남아 있습니다. 파티션이 없는 테이블이 그렇고, 한 파티션 안에서 일부만 지워야 하는 경우도 그렇습니다. 예를 들어 500 응답 로그만 더 오래 보관해야 한다면 파티션 단위로는 지울 수 없습니다. 반대로 TRUNCATE와 DROP은 DDL이므로 롤백할 수 없고, 실행하려면 테이블의 메타데이터 잠금을 얻어야 합니다. 커밋하지 않은 세션이 테이블을 잡고 있으면 서비스 쿼리까지 대기에 걸릴 수 있으며, 이 상황은 DDL 메타데이터 잠금 대기 글에서 재현했습니다.
DROP 이후에 들어온 2월 로그 한 건은 어디로 갔나
정리를 마친 세 테이블에 req_dt가 '2026-02-15 10:00:00'인 행을 하나씩 넣었습니다. 수집이 늦어진 로그가 뒤늦게 적재되는 상황을 가정한 것입니다.
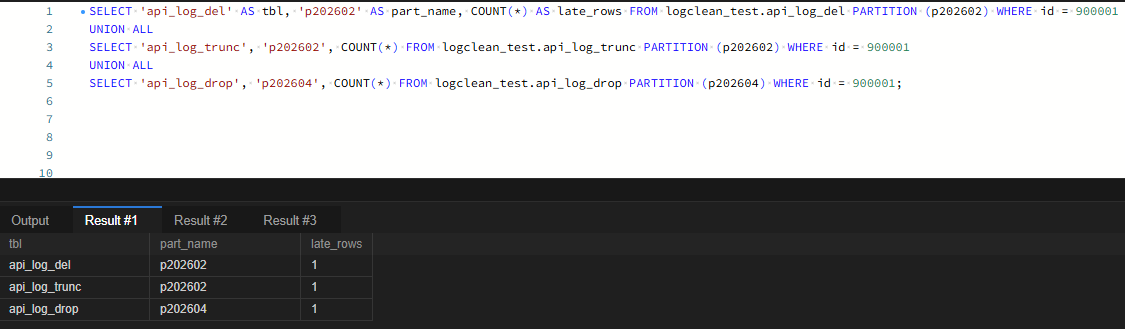
DELETE와 TRUNCATE 쪽은 정의가 남아 있으니 2월 로그가 비어 있는 p202602로 들어갔습니다. DROP 쪽은 2월을 받을 파티션이 없으므로, VALUES LESS THAN ('2026-05-01') 조건을 처음으로 만족하는 p202604에 저장됐습니다. 같은 정의로 다시 만들어 같은 순서로 DROP한 테이블에서 EXPLAIN으로 확인해도 partitions 열에 p202604가 나왔습니다.
EXPLAIN SELECT id, req_dt FROM logclean_test.api_log_drop
WHERE req_dt = '2026-02-15 10:00:00';

id | select_type | table        | partitions | type  | possible_keys      | key        | key_len | ref  | rows | filtered | Extra
1  | SIMPLE      | api_log_drop | p202604    | index | PRIMARY,ix_path_dt | ix_path_dt | 207     | NULL | 1    | 100      | Using where; Using index
오류 없이 들어갔다는 점이 오히려 문제입니다. 이 2월 로그는 보관 정책상 이미 지워졌어야 하는 데이터인데, 4월 파티션이 지워질 때까지 남아 있게 됩니다. 2월 데이터를 조회하는 화면이 있다면 다시 보이기도 합니다. 일 파티션을 매일 지우는 구조라면 같은 일이 하루 단위로 일어납니다. 이미 DROP한 날짜의 로그는 남아 있는 가장 오래된 일 파티션에 섞여 들어갑니다.
그래서 정리 프로시저가 다음 파티션을 DROP하기 전에, 가장 오래된 파티션에 그 경계보다 이른 날짜가 섞여 있는지 확인하는 단계를 넣어 볼 만합니다. 첫 번째 쿼리로 가장 앞 파티션의 이름을 찾고, 두 번째 쿼리로 그 파티션 하한보다 이른 행을 셉니다.
SELECT PARTITION_NAME, PARTITION_DESCRIPTION
FROM information_schema.PARTITIONS
WHERE TABLE_SCHEMA = 'logclean_test'
  AND TABLE_NAME   = 'api_log_drop'
ORDER BY PARTITION_ORDINAL_POSITION
LIMIT 1;

SELECT COUNT(*) AS late_rows
FROM logclean_test.api_log_drop PARTITION (p202604)
WHERE req_dt < '2026-04-01';
이번 테스트라면 캡처 6에서 p202604에 들어간 2월 로그 1건이 그대로 이 값이 됩니다. 이 값이 0이 아니라면 파티션을 지우기 전에, 과거 날짜로 적재하는 배치나 재전송 로직이 어디인지부터 확인해야 합니다. 원인을 두고 다음 DROP만 진행하면 늦게 들어온 행이 매번 엉뚱한 날짜의 파티션과 함께 지워지기 때문입니다.


댓글 0
첫 댓글을 남겨보세요.