LIKE ‘%검색어%’를 ngram FULLTEXT로 바꿨더니 ‘앱 로그인’이 0건: 2글자 토큰이 놓친 한글 검색어

관리 화면 검색창 뒤에 붙어 있던 LIKE '%검색어%'
관리 화면에서 이름이나 제목을 LIKE '%검색어%'로 조회하는 SQL이 느려진 사례가 있었습니다. 그때는 실행계획과 조회 범위를 확인한 뒤, 기간과 상태 조건으로 검색 대상을 줄이는 방향으로 개발팀과 협의했습니다.
같은 화면에 다른 선택지로 놓아 볼 수 있는 것이 InnoDB FULLTEXT 인덱스와 ngram 파서입니다. 한글은 공백으로 잘라서는 단어 중간을 찾을 수 없어서, ngram 파서는 글자를 두 개씩 묶은 토큰으로 인덱스를 만듭니다. 이번 테스트에서 먼저 본 것은 속도가 아니라, 같은 검색어를 넣었을 때 LIKE와 같은 행이 돌아오는지였습니다. 띄어쓰기가 다른 표현, 한 글자 검색어, 커밋하지 않은 행을 차례로 넣어 봤습니다.
고객 문의 20만 건에 심어 둔 일곱 가지 문장
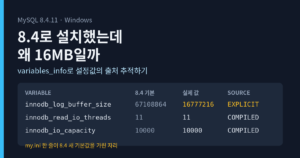
Windows에 설치한 MySQL Community 8.4.11에서 Workbench 연결 하나로 진행했습니다. ngram_token_size는 서버 시작 때만 정해지는 읽기 전용 변수라 손대지 않았고, 아래 화면처럼 출처가 COMPILED인 기본값 2 그대로입니다.

같은 화면의 innodb_ft_min_token_size는 3이지만 ngram 파서는 이 값을 따르지 않습니다. 뒤에 나오는 토큰 목록에 두 글자 토큰이 그대로 들어간 것으로도 확인됩니다.
가상의 고객 문의 테이블 cs_inquiry에 20만 건을 넣고, 문의 본문 가운데에 아래 구절을 정해진 건수만큼 심었습니다. 나머지 193,800건은 배송 조회, 쿠폰, 포인트 같은 일반 문의 문장이고, 그중 19,400건 끝에 환불 가능한가요를 붙였습니다. 난수 대신 일련번호의 나머지로 패턴을 정해서, 다시 만들어도 같은 데이터가 나옵니다.
| pattern_cd | 본문에 들어간 구절 | 건수 |
|---|---|---|
| A_CONTIG | 결제실패 알림이 왔어요 | 1,000 |
| B_SPACE | 결제 실패 문자를 받았습니다 | 1,000 |
| C_PARTICLE | 결제가 실패했다고 나옵니다 | 1,000 |
| D_FAIL_ONLY | 주소 저장 실패가 반복됩니다 | 1,000 |
| E_PAY_ONLY | 결제 수단을 바꾸고 싶어요 | 1,000 |
| F_APP_CONTIG | 앱로그인이 안 돼요 | 600 |
| G_APP_SPACE | 앱 로그인이 안 돼요 | 600 |
CREATE TABLE cs_inquiry (
  inquiry_id  INT UNSIGNED NOT NULL PRIMARY KEY,
  pattern_cd  VARCHAR(12)  NOT NULL,
  body        VARCHAR(300) NOT NULL,
  created_at  DATETIME     NOT NULL
) ENGINE=InnoDB;

-- 데이터 적재 후
CREATE FULLTEXT INDEX ft_body ON cs_inquiry (body) WITH PARSER ngram;
SHOW WARNINGS;

-- Warning 124: InnoDB rebuilding table to add column FTS_DOC_ID
인덱스 생성에 33초가 걸렸고 경고 124가 남았습니다. 테이블에 처음 FULLTEXT 인덱스를 만들면 문서 번호용 숨은 컬럼 FTS_DOC_ID를 넣으려고 테이블을 통째로 다시 만든다는 뜻입니다. 인덱스 하나 추가로 끝나는 작업이 아니어서, 운영 테이블이라면 이 재생성 시간을 작업 계획에 따로 잡아 둬야 합니다.
인덱스에 실제로 들어간 토큰
검색 결과를 보기 전에 토큰부터 열어 봤습니다. 네 행짜리 ft_token_probe 테이블에 결제실패, 결제 실패, 앱로그인, 앱 로그인을 넣고 같은 ngram 인덱스를 만든 다음, innodb_ft_aux_table로 대상을 지정해 INFORMATION_SCHEMA를 조회했습니다.
SET GLOBAL innodb_ft_aux_table = 'ngram_search_test/ft_token_probe';

SELECT 'INDEX_TABLE' AS src, t.DOC_ID, p.body, t.WORD, t.POSITION
FROM information_schema.INNODB_FT_INDEX_TABLE t
JOIN ft_token_probe p ON p.FTS_DOC_ID = t.DOC_ID
UNION ALL
SELECT 'INDEX_CACHE', c.DOC_ID, p.body, c.WORD, c.POSITION
FROM information_schema.INNODB_FT_INDEX_CACHE c
JOIN ft_token_probe p ON p.FTS_DOC_ID = c.DOC_ID
ORDER BY DOC_ID, POSITION;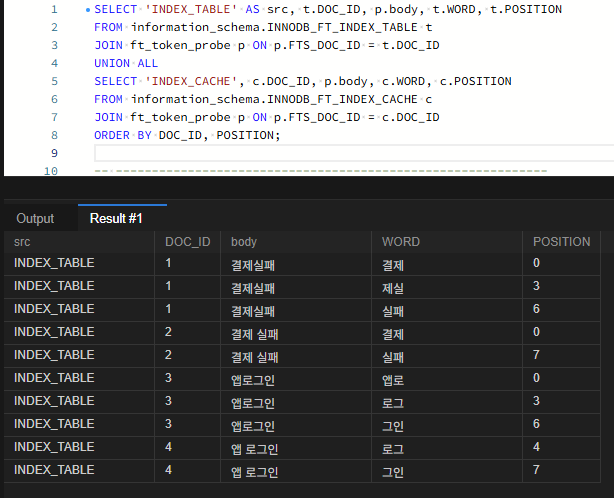
붙여 쓴 결제실패는 결제, 제실, 실패 세 토큰이 되고, 띄어 쓴 결제 실패에는 제실이 없습니다. 공백을 사이에 둔 두 글자는 하나로 묶이지 않습니다. POSITION이 0, 3, 6으로 3씩 늘어나는 것은 글자 순번이 아니라 바이트 위치이기 때문입니다. utf8mb4에서 한글 한 글자가 3바이트이고, 띄어 쓴 행의 실패가 7에서 시작하는 것은 공백 1바이트가 끼어서입니다.
뒤의 검색 결과를 가른 것은 마지막 두 행입니다. 앱 로그인의 토큰은 로그와 그인뿐이고 앱은 어디에도 없습니다. 공백 앞에 혼자 떨어진 한 글자는 2글자 토큰을 만들 수 없어 버려진 것입니다. 붙여 쓴 앱로그인은 앱로라는 토큰 안에 앱이 남아 있습니다.
같은 검색어를 LIKE, BOOLEAN, NATURAL로 세어 보니
20만 건 테이블에서 검색어별로 LIKE, BOOLEAN 모드, NATURAL LANGUAGE 모드의 건수를 UNION ALL 한 번으로 뽑았습니다.

붙여 쓴 결제실패
LIKE '%결제실패%', BOOLEAN '"결제실패"', 따옴표 없는 '+결제실패'가 모두 1,000건이었습니다. 따옴표 없는 쪽을 패턴별로 다시 나눠 보니 A_CONTIG 1,000건만 찾았습니다(이 조회는 트랜잭션 테스트를 마친 다음에 해서, 그때 커밋한 Z_TX 1건이 함께 나왔습니다). BOOLEAN 모드는 따옴표가 없어도 검색어를 결제·제실·실패가 이어진 구문으로 바꿔 찾았습니다.
NATURAL LANGUAGE 모드는 5,000건이었습니다. 어떤 행이 끌려왔는지 패턴별 점수로 나눠 봤습니다.

A_CONTIG가 11.0291로 가장 높고, B_SPACE와 C_PARTICLE이 5.7499로 같습니다. 실패만 있는 D와 결제만 있는 E도 2.875로 같은 점수를 받았습니다. 검색어를 결제, 제실, 실패로 나눈 뒤 하나라도 맞으면 가져오고, 맞은 토큰이 많을수록 점수를 올리는 것으로 보입니다. 결제 실패와 결제가 실패했다고는 문장이 다르지만, 두 행 모두 결제와 실패는 있고 제실은 없다는 점이 같습니다.
점수 순으로 상위 몇 건만 보여 주는 화면이라면 이 순서는 쓸 만합니다. 반대로 건수를 세거나 목록 전체를 내려받는 화면이라면, 결제실패를 검색했는데 결제 수단을 바꾸고 싶다는 문의 1,000건이 결과에 섞입니다.
띄어 쓴 결제 실패
LIKE '%결제 실패%'와 BOOLEAN '"결제 실패"'는 둘 다 1,000건이었고, BOOLEAN 쪽도 패턴별로 보면 B_SPACE만 찾았습니다. 여기까지는 LIKE와 같습니다. 그런데 바로 앞 결과와 겹쳐 보면, 결제실패로 찾으면 A만, 결제 실패로 찾으면 B만 나옵니다. 띄어쓰기가 섞인 데이터에서 둘을 함께 찾으려면 FULLTEXT로 바꿔도 검색어를 두 번 던져야 하고, 한 번에 찾으려면 앞에서 본 노이즈를 감수하고 NATURAL 모드를 써야 합니다. 이 부분은 LIKE를 쓸 때와 달라지지 않았습니다.
한 글자 앱과 띄어 쓴 앱 로그인
LIKE '%앱%'은 F_APP_CONTIG와 G_APP_SPACE를 합친 1,200건입니다. NATURAL '앱'은 0건이었습니다. 토큰이 두 글자이니 한 글자 검색어로는 맞출 토큰이 없습니다. 접두어 검색 '앱*'은 600건이었고, 패턴별로 보면 모두 F_APP_CONTIG였습니다. 앱로 토큰이 앱으로 시작하니 붙여 쓴 행은 찾았지만, 앱이 버려진 G_APP_SPACE 600건은 이번에 써 본 FULLTEXT 방식 어느 것으로도 앱이라는 검색어로 찾지 못했습니다.
예상과 가장 크게 어긋난 것은 '"앱 로그인"'이었습니다. LIKE '%앱 로그인%'은 600건인데 BOOLEAN 구문 검색은 0건이었고, 패턴별 조회도 빈 결과였습니다. 테스트 전에는 앱이 빠진 채 로그·그인만으로 찾아 600건, 많으면 앱로그인 행까지 1,200건이 나올 것으로 봤습니다. 이번 결과로는 구문 안에 토큰 크기보다 짧은 단어가 끼어 있으면 구문 전체가 한 행도 찾지 못하는 것으로 보입니다. 화면 사용자가 앱 로그인처럼 한 글자 단어를 띄어 쓴 검색어를 넣으면, 데이터가 600건 있어도 검색 결과는 비어 있게 됩니다.
넓은 검색어 환불
LIKE와 BOOLEAN 모두 19,400건으로 같았습니다. 붙어 있는 두 글자 단어 하나를 찾을 때는 결과 차이가 없었습니다.
줄어든 시간과, EXPLAIN ANALYZE가 감춘 시간
시간은 프로시저로 네 가지 COUNT를 3회씩 돌리며 SYSDATE(6) 차이로 쟀습니다. 바꾼 조건은 검색 방식 하나이고, 3회 중 최솟값과 최댓값을 뺀 값을 중앙값으로 썼습니다.

| 조회 | 건수 | 1회 | 2회 | 3회 | 중앙값 |
|---|---|---|---|---|---|
| LIKE 결제실패 | 1,000 | 214,523µs | 283,795µs | 305,121µs | 283,795µs |
| FULLTEXT 결제실패 | 1,000 | 30,496µs | 23,186µs | 21,848µs | 23,186µs |
| LIKE 환불 | 19,400 | 296,252µs | 228,930µs | 302,495µs | 296,252µs |
| FULLTEXT 환불 | 19,400 | 69,342µs | 68,670µs | 55,868µs | 68,670µs |
중앙값으로 보면 결제실패는 약 12배, 환불은 약 4.3배 차이입니다. LIKE는 검색어가 무엇이든 20만 건을 모두 훑으니 두 검색어의 시간이 비슷했고, FULLTEXT는 찾을 행이 1,000건에서 19,400건으로 늘자 23,186µs에서 68,670µs로 느려졌습니다. 이번 두 검색어에서는 결과가 적은 쪽의 차이가 더 컸습니다.
첫 실행이 가장 느릴 것으로 예상했지만, LIKE 결제실패는 1회차가 214,523µs로 세 번 중 가장 빨랐습니다. 인덱스 생성 직후라 테이블이 이미 버퍼 풀에 올라와 있었을 것이고, 2·3회차가 더 느렸던 원인은 따로 추적하지 않았습니다. FULLTEXT는 1회차 30,496µs 뒤로 23,186µs, 21,848µs로 줄었습니다. 서비스를 재시작한 직후의 상태는 측정에 넣지 않았습니다.
EXPLAIN ANALYZE는 두 방식을 전혀 다르게 보여 줬습니다. LIKE 쪽은 20만 행을 모두 읽고 필터에서 1,000행만 남기는 경로가 한눈에 보입니다. 필터의 예상 행 수는 22,047이었습니다. 이런 전체 스캔 쿼리를 sys 스키마로 골라내는 방법은 sys 스키마로 풀 테이블 스캔을 진단했던 테스트에서 다뤘습니다.
-> Aggregate: count(0)  (cost=24003 rows=1) (actual time=247..247 rows=1 loops=1)
    -> Filter: (cs_inquiry.body like '%결제실패%')  (cost=21798 rows=22047) (actual time=0.0863..247 rows=1000 loops=1)
        -> Table scan on cs_inquiry  (cost=21798 rows=198442) (actual time=0.08..94.1 rows=200000 loops=1)
같은 COUNT를 FULLTEXT로 바꾸자 결과가 한 줄로 끝났습니다.
-> Rows fetched before execution (cost=0..0 rows=1) (actual time=400e-6..500e-6 rows=1 loops=1)실행 단계에 들어가기 전에 개수를 이미 구해 둔 것이어서 실행 시간이 0.0005ms로 찍혔습니다. 프로시저로 잰 23ms와는 거리가 먼 숫자이고, 이 화면만 보고 FULLTEXT COUNT가 사실상 비용이 없다고 판단하면 틀립니다. COUNT를 빼고 inquiry_id를 가져오게 바꾸자 FULLTEXT 인덱스를 읽는 단계가 나타났습니다.
EXPLAIN ANALYZE SELECT 'TC17' AS tag, inquiry_id
FROM cs_inquiry WHERE MATCH(body) AGAINST('"결제실패"' IN BOOLEAN MODE);

-> Filter: (match cs_inquiry.body against ('"결제실패"' in boolean mode))  (cost=1.1 rows=1) (actual time=0.135..1.78 rows=1001 loops=1)
    -> Full-text index search on cs_inquiry using ft_body (body='"결제실패"')  (cost=1.1 rows=1) (actual time=0.129..1.72 rows=1001 loops=1)
여기서도 예상 행 수는 1이고 실제는 1,001입니다. 이번에는 단일 테이블이라 이 차이가 결과에 영향을 주지 않았습니다. 다른 테이블과 조인하는 SQL이라면 이 예상 1행이 조인 순서에 어떻게 반영되는지 실행계획으로 함께 봐야 합니다.
커밋하지 않은 결제실패 재문의 한 건
같은 연결에서 트랜잭션을 열고 결제실패 재문의 드립니다 한 건을 넣은 뒤, 커밋하기 전에 두 방식으로 세었습니다.
START TRANSACTION;

INSERT INTO cs_inquiry (inquiry_id, pattern_cd, body, created_at)
VALUES (900001, 'Z_TX', '결제실패 재문의 드립니다', '2026-11-09 10:00:00');

SELECT 'TC20' AS tag, 'LIKE before commit' AS m, COUNT(*) AS cnt
FROM cs_inquiry WHERE body LIKE '%결제실패%'
UNION ALL
SELECT 'TC21', 'FT before commit', COUNT(*)
FROM cs_inquiry WHERE MATCH(body) AGAINST('"결제실패"' IN BOOLEAN MODE);
LIKE는 자기 트랜잭션에서 넣은 행까지 1,001건으로 셌고, FULLTEXT는 1,000건이었습니다. COMMIT 뒤에 같은 조회를 하자 둘 다 1,001건이 되었습니다. 문서상 InnoDB는 FULLTEXT 인덱스를 커밋 시점에 반영하고, 이번 결과도 그대로였습니다. 문의를 저장하고 같은 트랜잭션 안에서 비슷한 문의가 있는지 검색하는 로직이라면, LIKE를 MATCH로 바꾸는 순간 방금 저장한 건이 검색에서 빠집니다.
다시 관리 화면 검색창 앞에서
검색용 인덱스 요청을 받으면 저는 정확히 일치하는 검색인지, 앞부분 검색인지, 중간 문자열 검색인지를 먼저 확인했습니다. 그다음에 검색어 길이, 대상 데이터 건수, 함께 쓰는 조건, 정렬·페이징 방식, 목표 응답 시간을 검토했습니다.
이번 결과를 놓고 보면, ngram FULLTEXT를 검토할 때 검색어 길이는 최소 몇 글자라는 숫자 하나로 받기에는 부족합니다. 앱 로그인은 네 글자짜리 검색어인데도 0건이었습니다. 화면 사용자가 실제로 넣는 검색어를 수십 개 받아 두고, 공백 사이에 한 글자 단어가 끼는지, 결제실패와 결제 실패처럼 띄어쓰기가 갈리는 표현이 섞이는지 대조해 보는 편이 더 확실합니다. 받은 검색어를 이번 테스트처럼 BOOLEAN과 LIKE로 나란히 세어 보면, 건수가 갈리는 검색어를 곧바로 골라낼 수 있습니다.
이번에 확인하지 못한 것도 남아 있습니다. 앞의 관리 화면처럼 기간과 상태 조건으로 범위를 줄이는 SQL에 MATCH를 함께 걸면, 옵티마이저가 FULLTEXT 인덱스와 기간 컬럼 인덱스 중 어느 쪽을 먼저 쓰는지는 보지 않았습니다. FULLTEXT를 그런 화면에 섞을 계획이라면, COUNT를 뺀 형태로 EXPLAIN ANALYZE를 떠서 그 조합부터 확인하는 것이 순서입니다.


댓글 0
첫 댓글을 남겨보세요.