업서트 한 줄이 id를 바꾸고 자식 행을 지운다: REPLACE INTO와 ON DUPLICATE KEY UPDATE

SKU-001 한 행을 덮어쓴 뒤 사라진 것들
같은 SKU가 다시 들어오면 새 값으로 덮어쓰는 업서트는 MySQL에서 REPLACE INTO와 INSERT ... ON DUPLICATE KEY UPDATE(이하 ODKU) 두 가지로 쓸 수 있습니다. 둘 다 키가 충돌하면 기존 행이 새 값으로 바뀌고, 영향 행 수도 똑같이 2를 돌려줍니다. 그런데 REPLACE로 SKU-001의 수량만 바꾼 뒤 다시 조회해 보니 id와 메모 컬럼이 처음과 다른 값으로 남아 있었습니다.
그래서 같은 키로 충돌시킨 뒤 두 문장이 행, AUTO_INCREMENT 번호, 자식 테이블, 내부 처리 카운터에 각각 무엇을 남기는지 하나씩 비교했습니다.
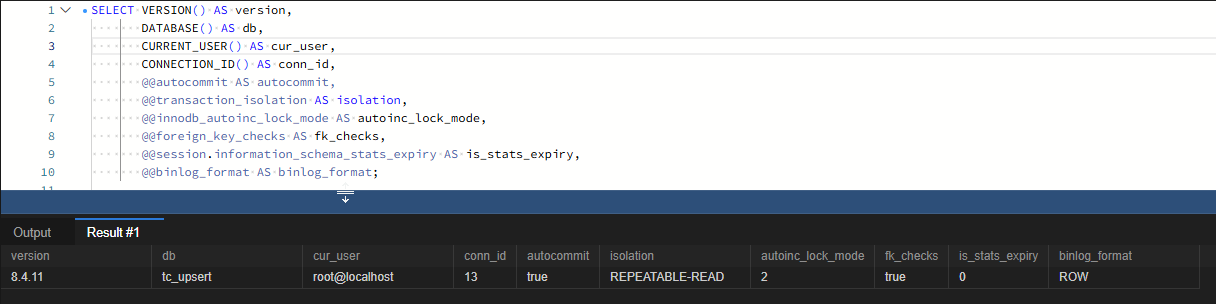
서버는 Windows에 설치한 MySQL 8.4.11이고, Workbench 연결 하나에서 자동 커밋을 켠 채 실행했습니다. 번호 할당 방식에 영향을 주는 innodb_autoinc_lock_mode는 8.4 기본값인 2였고 외래키 검사는 켜져 있었습니다. information_schema의 AUTO_INCREMENT 값이 캐시 때문에 늦게 갱신되지 않도록 세션의 information_schema_stats_expiry를 0으로 두고 조회했습니다.
가상의 재고 테이블 product_stock에는 PK(id)와 sku 유니크 키를 두고 SKU-001부터 SKU-010까지 10건을 넣었습니다. 메모 컬럼에는 행마다 입고 메모를 채웠습니다. 외래키 동작을 보려고 id 2를 참조하는 stock_hold(ON DELETE CASCADE) 3건과 id 3을 참조하는 order_line(ON DELETE RESTRICT) 2건을 자식으로 붙였습니다.
CREATE TABLE product_stock (
  id    INT UNSIGNED NOT NULL AUTO_INCREMENT,
  sku   VARCHAR(20)  NOT NULL,
  qty   INT          NOT NULL,
  memo  VARCHAR(50)  NULL,
  PRIMARY KEY (id),
  UNIQUE KEY uk_sku (sku)
) ENGINE=InnoDB;

CREATE TABLE stock_hold (
  hold_id  INT UNSIGNED NOT NULL AUTO_INCREMENT PRIMARY KEY,
  stock_id INT UNSIGNED NOT NULL,
  hold_qty INT NOT NULL,
  CONSTRAINT fk_hold_stock FOREIGN KEY (stock_id)
    REFERENCES product_stock (id) ON DELETE CASCADE
) ENGINE=InnoDB;

CREATE TABLE order_line (
  line_id   INT UNSIGNED NOT NULL AUTO_INCREMENT PRIMARY KEY,
  stock_id  INT UNSIGNED NOT NULL,
  order_qty INT NOT NULL,
  CONSTRAINT fk_line_stock FOREIGN KEY (stock_id)
    REFERENCES product_stock (id) ON DELETE RESTRICT
) ENGINE=InnoDB;
영향 행 수 2만으로는 구분되지 않는 두 문장
업서트 문장마다 바로 뒤에서 SET @rc = ROW_COUNT();로 영향 행 수를 받아 그 시점의 AUTO_INCREMENT 값과 함께 로그 테이블에 남겼습니다.
-- TC03: REPLACE, sku 충돌 (id와 memo는 적지 않음)
REPLACE INTO product_stock (sku, qty) VALUES ('SKU-001', 15);

-- TC04: ODKU, sku 충돌 (qty 40 -> 45)
INSERT INTO product_stock (sku, qty) VALUES ('SKU-004', 45) AS new
ON DUPLICATE KEY UPDATE qty = new.qty;

-- TC05: TC04와 같은 값으로 한 번 더
INSERT INTO product_stock (sku, qty) VALUES ('SKU-004', 45) AS new
ON DUPLICATE KEY UPDATE qty = new.qty;

-- TC06: REPLACE, 기존 행과 모든 값이 같은 입력
REPLACE INTO product_stock (id, sku, qty, memo) VALUES (5, 'SKU-005', 50, '입고 메모 5');

-- TC07: REPLACE, id 6과 SKU-007(id 7)이 서로 다른 행과 충돌
REPLACE INTO product_stock (id, sku, qty, memo) VALUES (6, 'SKU-007', 67, '두 키 충돌');

-- TC08: ODKU, id 8과 SKU-009(id 9)가 서로 다른 행과 충돌
INSERT INTO product_stock (id, sku, qty, memo) VALUES (8, 'SKU-009', 89, '두 키 충돌') AS new
ON DUPLICATE KEY UPDATE qty = new.qty, memo = new.memo;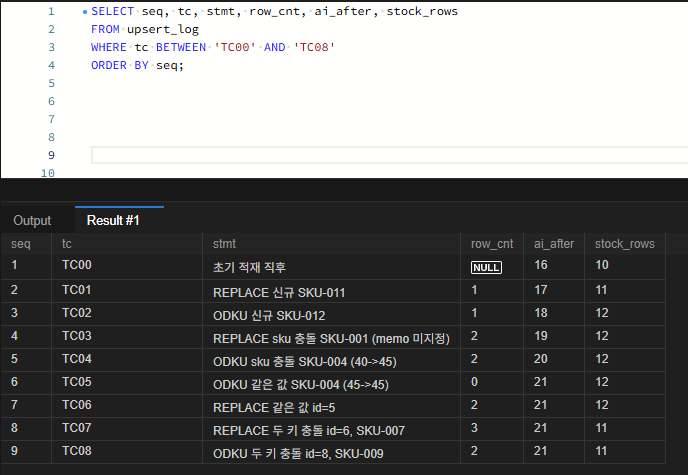
| TC | 문장 | ROW_COUNT | AUTO_INCREMENT |
|---|---|---|---|
| TC01 | REPLACE, 충돌 없음 | 1 | 16 → 17 |
| TC02 | ODKU, 충돌 없음 | 1 | 17 → 18 |
| TC03 | REPLACE, sku 충돌 | 2 | 18 → 19 |
| TC04 | ODKU, sku 충돌 (40 → 45) | 2 | 19 → 20 |
| TC05 | ODKU, 같은 값 (45 → 45) | 0 | 20 → 21 |
| TC06 | REPLACE, 같은 값 (id 지정) | 2 | 21 → 21 |
| TC07 | REPLACE, 두 키 충돌 (id 지정) | 3 | 21 → 21 |
| TC08 | ODKU, 두 키 충돌 (id 지정) | 2 | 21 → 21 |
TC03과 TC04는 영향 행 수가 둘 다 2라서 이 숫자만 보는 코드는 두 문장을 같은 결과로 받아들입니다. 차이가 숫자로 드러난 것은 값이 바뀌지 않는 경우였습니다. ODKU는 같은 값으로 다시 실행하자 0을 돌려주었고, REPLACE는 모든 컬럼이 기존 행과 같아도 2를 돌려주었습니다.
ODKU의 0은 접속 시 CLIENT_FOUND_ROWS 플래그를 쓰면 1로 바뀐다고 문서에 나와 있어서, 애플리케이션 드라이버 설정에 따라 같은 문장이 다른 숫자를 받을 수 있습니다. 영향 행 수가 1 이상인지로 성공 여부를 판단하는 코드라면 ODKU의 0을 실패로 처리하지 않는지 확인이 필요합니다.
AUTO_INCREMENT 쪽은 더 의외였습니다. TC04와 TC05는 새 행을 만들지 않았는데도 번호가 각각 1씩 올라갔습니다. id를 직접 적은 TC06부터 TC08까지는 21에서 움직이지 않았습니다. id를 비워 둔 문장은 충돌 여부를 알기 전에 번호를 먼저 받고, 업데이트로 끝나도 그 번호를 돌려주지 않는 것으로 보입니다. 맨 위 TC00의 16은 10건을 넣은 직후 값인데, 이 숫자는 뒤의 1,000건 결과와 함께 다시 보겠습니다.
sku 기준으로 전후 행을 맞대어 보면
적재 직후 상태를 ps_before에 복사해 두고, 업서트를 마친 product_stock과 sku로 이어 붙여 한 화면에 놓았습니다.
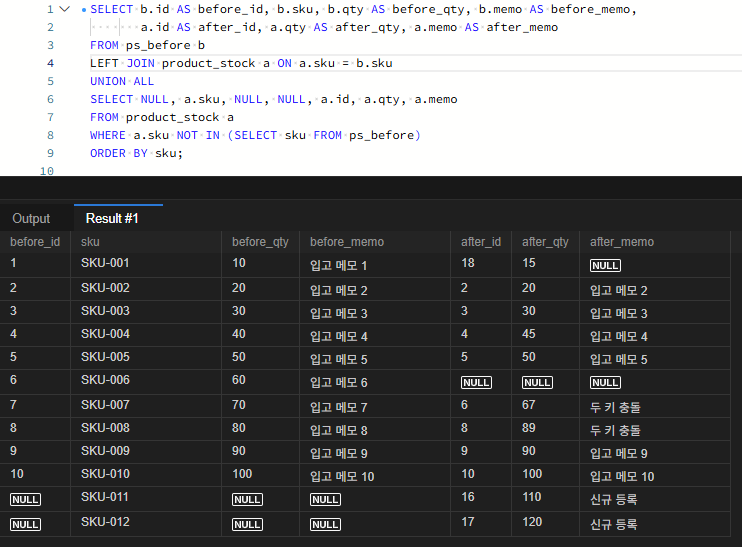
SKU-001은 id가 1에서 18로 바뀌고 메모가 NULL이 되었습니다. REPLACE에 메모를 적지 않았으니 그 컬럼은 기본값으로 다시 채워졌고, id도 적지 않았으니 새 번호를 받았습니다. 기존 행을 지우고 새 행을 넣었을 때와 같은 모양입니다. ODKU를 거친 SKU-004는 id 4와 메모를 그대로 두고 수량만 45로 바뀌었습니다.
두 키가 서로 다른 행을 가리킨 경우에는 결과가 더 크게 갈렸습니다.
- REPLACE(TC07): id 6 행과 SKU-007 행을 모두 지우고 한 행만 넣었습니다. SKU-006은 테이블에서 사라졌고, SKU-007은 id 6 자리로 옮겨졌습니다. 영향 행 수 3은 삭제 2건과 입력 1건으로 읽힙니다.
- ODKU(TC08): id 8 행 하나만 수량 89와 새 메모로 바뀌었습니다. 입력값에 담긴 SKU-009는 어디에도 반영되지 않았고, id 9의 SKU-009 행도 손대지 않았습니다. 오류 없이 2가 돌아왔기 때문에 결과만으로는 입력이 일부만 반영됐다는 사실을 알 수 없습니다.
유니크 키가 둘 이상인 테이블에서는 업서트 입력값 하나가 서로 다른 두 행을 가리킬 수 있습니다. 이때 REPLACE는 행을 지워 버리고, ODKU는 한 행만 조용히 바꿉니다. 어느 쪽도 의도한 결과가 아니므로, 이런 테이블은 업서트 전에 입력값이 같은 행을 가리키는지부터 맞춰야 합니다. 유니크 키 충돌이 잠금 대기로 이어지는 경우는 커밋되지 않은 INSERT와 유니크 키 대기에서 따로 다뤘습니다.
부모 행을 REPLACE하면 자식 테이블에서 일어나는 일
자식 3건이 걸린 id 2에는 ODKU를 먼저, REPLACE를 나중에 실행했습니다. RESTRICT 자식 2건이 걸린 id 3에는 REPLACE를 먼저 시도했는데, 오류를 로그 테이블에 남기려고 이 문장만 예외 처리기를 둔 프로시저 안에서 실행했습니다.
-- TC09: ODKU, id 2 (CASCADE 자식 3건)
INSERT INTO product_stock (id, sku, qty) VALUES (2, 'SKU-002', 25) AS new
ON DUPLICATE KEY UPDATE qty = new.qty;

-- TC10: REPLACE, 같은 id 2
REPLACE INTO product_stock (id, sku, qty, memo) VALUES (2, 'SKU-002', 25, '입고 메모 2');

-- TC11: REPLACE, id 3 (RESTRICT 자식 2건), 프로시저 안에서 실행
REPLACE INTO product_stock (id, sku, qty, memo) VALUES (3, 'SKU-003', 30, '입고 메모 3');

-- TC12: ODKU, 같은 id 3
INSERT INTO product_stock (id, sku, qty) VALUES (3, 'SKU-003', 35) AS new
ON DUPLICATE KEY UPDATE qty = new.qty;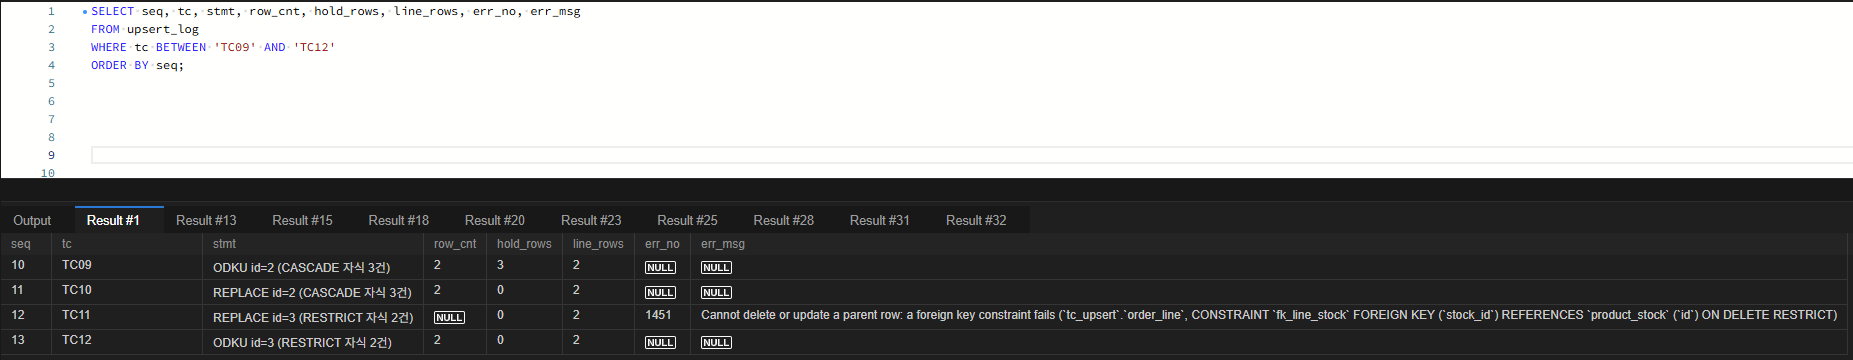
ODKU를 실행한 TC09 뒤에는 stock_hold가 3건 그대로였습니다. 이어서 같은 id 2, 같은 sku로 REPLACE를 실행하자 자식 3건이 모두 사라졌습니다. 부모 행의 id는 여전히 2이고 영향 행 수도 2라서, product_stock과 영향 행 수만 보면 사라진 자식 3건은 드러나지 않습니다.
RESTRICT 쪽에서는 Cannot delete or update a parent row로 시작하는 1451 오류가 났습니다. 업데이트를 요청한 문장인데 삭제 제약에 걸렸다는 것은, REPLACE가 부모 행 삭제를 시도한다는 뜻입니다. 같은 행에 ODKU를 실행한 TC12는 자식 2건을 그대로 둔 채 수량만 바꿨습니다.
값을 바꾸려던 문장이 자식 데이터를 지우는 셈이라, 부모 테이블에 REPLACE가 보이면 그 테이블을 참조하는 외래키와 ON DELETE 규칙을 먼저 확인해야 합니다. CASCADE면 자식이 조용히 지워지고, RESTRICT면 업서트 자체가 실패합니다.
1,000건을 한꺼번에 덮어썼을 때 카운터가 보여 준 내부 처리
단건 결과를 대량 처리에서도 확인하려고 구조가 같은 테이블 세 개(ps_plain, ps_fkref, ps_odku)에 id를 직접 지정해 1,000건씩 넣었습니다. 세 테이블 모두 AUTO_INCREMENT는 1001에서 시작했고, ps_fkref만 행이 하나도 없는 자식 테이블이 외래키로 참조하게 했습니다. 원본 stock_feed에는 같은 sku 1,000건을 수량 20으로 준비했습니다.
각 문장 직전과 직후에 performance_schema.session_status에서 Handler_write, Handler_delete, Handler_update를 읽어 차이를 구했습니다.
-- B1: REPLACE, 외래키 참조가 없는 테이블
REPLACE INTO ps_plain (sku, qty) SELECT feed_sku, feed_qty FROM stock_feed;

-- B2: REPLACE, 외래키로 참조되는 테이블 (자식 행 0건)
REPLACE INTO ps_fkref (sku, qty) SELECT feed_sku, feed_qty FROM stock_feed;

-- B3: ODKU, 외래키 참조가 없는 테이블
INSERT INTO ps_odku (sku, qty) SELECT feed_sku, feed_qty FROM stock_feed
ON DUPLICATE KEY UPDATE qty = feed_qty;

-- 문장 전후로 읽은 카운터
SELECT SUM(IF(VARIABLE_NAME = 'Handler_write',  VARIABLE_VALUE, 0)),
       SUM(IF(VARIABLE_NAME = 'Handler_delete', VARIABLE_VALUE, 0)),
       SUM(IF(VARIABLE_NAME = 'Handler_update', VARIABLE_VALUE, 0))
  INTO @w0, @d0, @u0
FROM performance_schema.session_status
WHERE VARIABLE_NAME IN ('Handler_write', 'Handler_delete', 'Handler_update');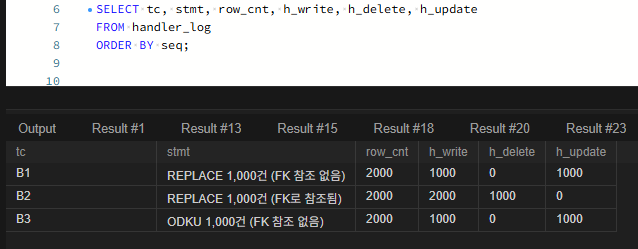
외래키 참조가 없는 ps_plain의 REPLACE(B1)는 쓰기 1,000, 삭제 0, 갱신 1,000으로 ODKU(B3)와 숫자가 똑같았습니다. 반면 자식 행이 하나도 없는데 외래키로 참조만 되는 ps_fkref(B2)에서는 쓰기 2,000, 삭제 1,000, 갱신 0이 나왔습니다. 같은 REPLACE 문이 테이블이 외래키로 참조되는지에 따라 다른 내부 경로를 탄 것으로 보입니다. B2는 행마다 실패한 입력 1번, 삭제 1번, 다시 입력 1번이 쌓인 모양이고, B1은 삭제 없이 기존 행을 갱신한 모양입니다. 영향 행 수는 세 문장 모두 2,000이었습니다.
카운터만 보면 B1과 B3이 같은 일을 한 것처럼 보이지만, 처리 후 테이블은 달랐습니다.
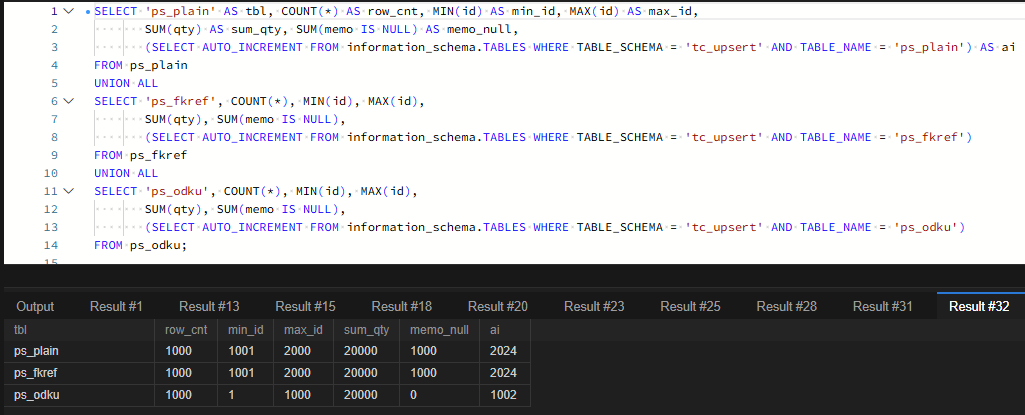
ps_plain은 내부적으로 삭제가 0건이었는데도 id가 1001부터 2000으로 바뀌었고 메모 1,000건이 모두 NULL이 되었습니다. 내부에서 갱신 경로를 탔더라도 REPLACE가 남기는 결과는 행 교체였습니다. ps_odku는 id 1부터 1000과 메모를 그대로 유지했습니다.
세 테이블의 수량 합계는 모두 20,000으로 같았습니다. 업서트 후 건수와 수량 합계만 대조하는 검증이라면 세 테이블이 모두 정상으로 통과합니다. id가 바뀌었는지, 적지 않은 컬럼이 비었는지는 따로 확인해야 드러납니다.
1,000건을 넣는 동안 번호 1,023개가 지나간 이유
INSERT ... SELECT로 1만 건씩 적재하는 배치에서 실제로 적재된 행 수보다 AUTO_INCREMENT 값이 크게 늘어 있는 것을 확인한 적이 있습니다. 왜 번호를 건너뛰었는지는 그동안 짐작만 하고 있었는데, 이번 테스트에서 같은 현상이 연결 하나에서 순차로 실행한 문장에서도 나타났습니다.
REPLACE 일괄 처리 후 ps_plain과 ps_fkref는 새 id 1,000개(1001~2000)를 받았는데 AUTO_INCREMENT는 2024였습니다. 1001부터 2023까지 1,023개 번호가 지나갔고, 그중 23개는 쓰이지 않았습니다. 처음 10건을 넣은 직후 값 16도 같은 방식으로 읽힙니다. 1부터 15까지 15개 번호가 지나갔고 10개만 쓰였습니다. 그래서 다음에 들어온 SKU-011은 11이 아니라 16번을 받았습니다.
두 숫자는 번호를 1, 2, 4, 8개처럼 두 배씩 묶어 미리 잡는다고 보면 정확히 맞습니다. 10건은 1+2+4+8로 15개, 1,000건은 1+2+4+…+512로 1,023개입니다. 행 수를 미리 알 수 없는 INSERT ... SELECT는 번호를 이렇게 묶음으로 확보하고, 문장이 끝날 때 남은 번호를 되돌리지 않는 것으로 보입니다. id를 직접 지정해 1,000건을 넣은 세 테이블의 초기 적재 후에는 AUTO_INCREMENT가 1001이었으므로, 번호를 받지 않는 입력에서는 이런 간격이 생기지 않았습니다.
ODKU는 반대 방향으로 눈에 띄었습니다. 1,000건을 전부 갱신으로 처리한 B3 뒤의 AUTO_INCREMENT는 1001에서 1002로 하나만 늘었습니다. 단건 ODKU가 문장마다 1씩 번호를 쓴 TC04, TC05와 비교하면, 이번 결과에서 번호 소모는 처리한 행 수보다 실행한 문장 수를 따랐습니다. 행마다 ODKU를 한 번씩 호출하는 구조라면 갱신만 반복해도 번호가 호출 횟수만큼 늘어날 수 있다는 뜻입니다.
업서트 대상 테이블을 먼저 걸러 내는 SQL 두 개
REPLACE나 ODKU가 들어간 쿼리를 받으면 대상 테이블이 이번 결과의 위험 조건에 해당하는지부터 확인할 수 있습니다. 첫 번째는 다른 테이블이 외래키로 참조하는 부모 테이블과 ON DELETE 규칙을 찾는 SQL입니다.
SELECT rc.REFERENCED_TABLE_NAME AS parent_table,
       rc.TABLE_NAME            AS child_table,
       rc.CONSTRAINT_NAME,
       rc.DELETE_RULE
FROM information_schema.REFERENTIAL_CONSTRAINTS rc
WHERE rc.CONSTRAINT_SCHEMA = 'your_schema'
ORDER BY parent_table, child_table;
여기에 이름이 나온 부모 테이블에 REPLACE가 걸려 있다면, DELETE_RULE이 CASCADE인 자식은 TC10처럼 조용히 지워지고 RESTRICT나 NO ACTION인 자식이 있으면 TC11처럼 1451로 막힙니다. 자식 행이 0건이어도 참조만 되어 있으면 B2처럼 삭제 경로를 탔습니다.
두 번째는 유니크 키가 둘 이상인 테이블을 찾는 SQL입니다. PK도 유니크 키로 세어지므로 PK와 유니크 키가 하나씩 있는 테이블부터 걸립니다.
SELECT TABLE_NAME,
       COUNT(DISTINCT INDEX_NAME) AS unique_key_cnt,
       GROUP_CONCAT(DISTINCT INDEX_NAME ORDER BY INDEX_NAME) AS unique_keys
FROM information_schema.STATISTICS
WHERE TABLE_SCHEMA = 'your_schema'
  AND NON_UNIQUE = 0
GROUP BY TABLE_NAME
HAVING COUNT(DISTINCT INDEX_NAME) >= 2
ORDER BY TABLE_NAME;
이 목록에 있는 테이블은 업서트 입력값 하나가 서로 다른 두 행과 충돌할 수 있어, REPLACE면 TC07처럼 행이 하나 사라지고 ODKU면 TC08처럼 입력 일부가 반영되지 않습니다. 두 목록에 모두 들어 있는 테이블이라면 REPLACE 대신 ODKU로 바꾸고 갱신할 컬럼을 명시하는 쪽이 이번 결과에서는 남는 피해가 적었습니다. 트리거가 걸린 테이블과 여러 세션이 같은 키로 동시에 업서트하는 경우는 이번에 확인하지 않았습니다.



댓글 0
첫 댓글을 남겨보세요.