LIMIT 1인데 29만 행을 읽는다: MySQL 옵티마이저가 PK 역순 스캔을 고른 순간

A 단독 인덱스를 지운 뒤 응답 지연이 시작됐습니다
운영 중인 테이블에 WHERE A = ? ORDER BY PK DESC LIMIT 1 형태로 조건에 맞는 가장 최근 1건을 가져오는 쿼리가 있었습니다. 이 쿼리는 A 컬럼 단독 인덱스를 쓰고 있었습니다. 같은 테이블에 (A, B) 보조 인덱스를 하나 추가하면서 A 단독 인덱스를 삭제했는데, 그 뒤 서비스 응답 지연이 발생했습니다. 지연된 쿼리의 실행계획은 PK 인덱스를 타고 있었습니다.
원복이 더 힘들었습니다. 인스턴스 클래스가 매우 낮은 타입이었고 테이블도 커서 인덱스 생성 자체에 오랜 시간이 걸렸습니다. 게다가 지연된 서비스 쿼리들이 IOPS 최대치를 다 쓰고 있어서 인덱스 생성이 진행되지 않았습니다. 결국 서비스를 내린 상태에서 인덱스를 만들고 다시 서비스를 올렸고, 삭제한 A 단독 인덱스를 되살리기까지 1시간이 걸렸습니다.
그 이후로는 A 컬럼 조건에 ORDER BY PK가 붙는 쿼리가 있으면 A 단독 인덱스에 손을 대지 않고 보호하고 있습니다. 이 운영 기준이 옵티마이저 동작으로도 설명되는지 확인하려고, MySQL 8.4.11에서 같은 모양의 테이블을 만들어 장애를 재현했습니다.
택배 스캔 로그 30만 건으로 만든 재현 환경
| 항목 | 값 |
|---|---|
| DBMS | MySQL Community Server 8.4.11 (Windows, MySQL Workbench) |
| 격리 수준 / autocommit | REPEATABLE-READ / ON |
| prefer_ordering_index | on (기본값) |
| 버퍼 풀 | 128MB, 재시작 시 버퍼 풀 로드 ON |
| 테이블 크기 | 데이터 43.6MB, 인덱스 12.0MB |

테이블 전체가 버퍼 풀 안에 들어가는 크기라서 디스크 I/O는 거의 섞이지 않습니다. 그래서 아래 수치는 실행 시간보다 실제로 읽은 행 수를 기준으로 비교했습니다.
CREATE TABLE parcel_scan_log (
  scan_id     BIGINT UNSIGNED   NOT NULL AUTO_INCREMENT,
  carrier_id  SMALLINT UNSIGNED NOT NULL,
  hub_code    CHAR(4)           NOT NULL,
  scan_status TINYINT UNSIGNED  NOT NULL,
  scanned_at  DATETIME          NOT NULL,
  memo        VARCHAR(100)      NOT NULL,
  PRIMARY KEY (scan_id)
) ENGINE=InnoDB;

SET SESSION cte_max_recursion_depth = 300000;

INSERT INTO parcel_scan_log (carrier_id, hub_code, scan_status, scanned_at, memo)
WITH RECURSIVE seq (n) AS (
  SELECT 1 UNION ALL SELECT n + 1 FROM seq WHERE n < 300000
)
SELECT CASE WHEN n <= 294000 THEN (n % 50) + 1 ELSE 77 END,
       CONCAT('H', LPAD(n % 120, 3, '0')),
       n % 5,
       TIMESTAMP('2026-01-01 00:00:00') + INTERVAL n MINUTE,
       RPAD(CONCAT('scan-', n), 100, 'x')
FROM seq;

CREATE INDEX idx_carrier ON parcel_scan_log (carrier_id);
CREATE INDEX idx_scanned ON parcel_scan_log (scanned_at);
ANALYZE TABLE parcel_scan_log;

-- 과거 구간에만 존재하는 거래처 88번
UPDATE parcel_scan_log SET carrier_id = 88 WHERE scan_id BETWEEN 1 AND 6000;
ANALYZE TABLE parcel_scan_log;
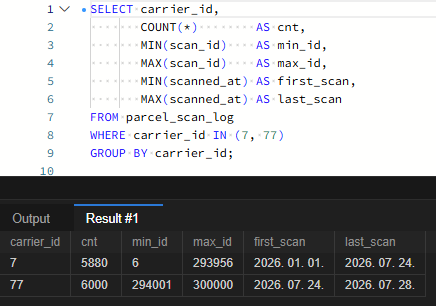
데이터는 난수 없이 순번으로 만들었습니다. 거래처 1~50번은 기간 전체에 고르게 퍼져 있고, 77번은 마지막 6,000건(scan_id 294,001~300,000)에만 있습니다. 88번은 반대로 맨 앞 6,000건(scan_id 1~6,000, 2026-01-01~01-05)에만 있습니다. 신규 계약 거래처와 해지된 거래처를 흉내 낸 분포입니다.
규모를 30만 건으로 잡은 이유는 두 가지입니다. 정상 경로(6,000건 정렬)와 잘못된 경로(약 29만 건 스캔)의 차이가 수십 배로 벌어지고, Windows 노트북에서도 데이터 적재가 금방 끝나기 때문입니다. idx_carrier의 통계상 카디널리티는 49로 잡혔습니다. 실제 고유값은 51개입니다.
A 단독 인덱스 하나 차이로 1행과 294,001행이 갈렸습니다
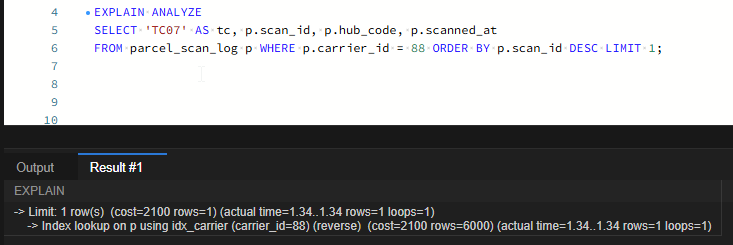
운영에서 문제가 된 쿼리와 같은 모양으로, 과거 구간에만 데이터가 있는 88번의 가장 최근 1건을 조회했습니다.
SELECT p.scan_id, p.hub_code, p.scanned_at
FROM parcel_scan_log p
WHERE p.carrier_id = 88
ORDER BY p.scan_id DESC
LIMIT 1;
A 단독 인덱스(idx_carrier)가 있을 때는 그 인덱스를 거꾸로 읽어서 1행 만에 끝났습니다. 예상 rows는 6,000이었지만 실제로 읽은 행은 1개였고, 1.34ms가 걸렸습니다.
이어서 운영과 같은 순서로 (A, B) 인덱스를 추가하고 A 단독 인덱스를 뺐습니다. 다만 DROP 대신 INVISIBLE로 숨겨서 원복할 수 있게 해 두었습니다.
CREATE INDEX idx_carrier_hub ON parcel_scan_log (carrier_id, hub_code);
ALTER TABLE parcel_scan_log ALTER INDEX idx_carrier INVISIBLE;
이 시점에 보이는 인덱스는 PRIMARY, idx_scanned, idx_carrier_hub, 그리고 뒤에서 다룰 idx_carrier_scanned(carrier_id, scanned_at)였습니다. carrier_id로 시작하는 복합 인덱스가 두 개나 남아 있었는데도 옵티마이저는 PRIMARY를 역순으로 훑는 쪽을 골랐습니다.
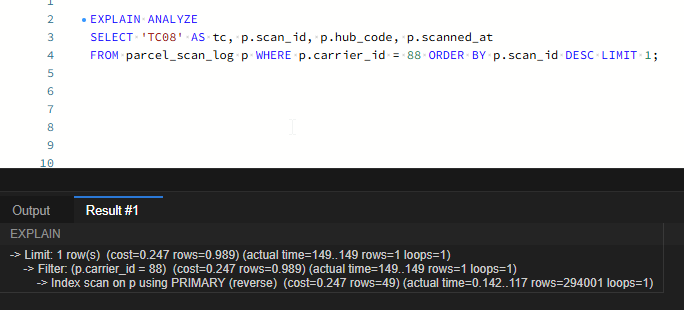
같은 쿼리를 반복해도 결과는 같았습니다. performance_schema 기준으로 첫 실행은 145.3ms였고, 이후 8회는 67.1~120.4ms(중앙값 약 99.6ms) 사이였습니다. ROWS_EXAMINED는 매번 294,001이었습니다. optimizer trace에도 정렬 인덱스로 계획을 바꿨다는 기록이 그대로 남았습니다.
"index_order_summary": {
  "index": "PRIMARY",
  "access_type": "index",
  "plan_changed": true,
  "order_direction": "desc",
  "index_provides_order": true
}
옵티마이저가 기대한 49행은 어디서 나왔나
통계상 carrier_id 값은 49종류입니다. 그래서 옵티마이저는 값 하나가 전체의 약 1/49을 차지하고 고르게 퍼져 있다고 봅니다. 이 가정이면 PK를 뒤에서부터 49행쯤 읽었을 때 88번이 한 건은 나와야 합니다. 정렬도 필요 없으니 6,000건을 찾아 정렬하는 것보다 싸다고 판단한 것입니다.
실제로는 88번이 PK 맨 앞에만 있었습니다. 그래서 88번이 아닌 294,000행을 모두 지나친 뒤에야 첫 건을 만났습니다. 같은 인덱스 상태에서 77번으로 바꾸자 PRIMARY 역순 스캔이 1행, 0.0556ms에 끝났습니다. 같은 계획이 어떤 값에서는 가장 빠른 계획이고 어떤 값에서는 장애가 됩니다. 평소에는 멀쩡하다가 특정 조건값에서만 응답이 늘어지는 이유가 여기에 있습니다.
A 단독 인덱스는 사실상 (A, PK) 인덱스였습니다
InnoDB 보조 인덱스에는 PK 값이 붙어 있습니다. 그래서 (carrier_id) 인덱스는 같은 carrier_id 안에서 scan_id 순서로 정렬되어 있고, ORDER BY scan_id DESC LIMIT 1은 그 구간 끝의 한 행만 읽으면 됩니다.
반면 (carrier_id, hub_code)는 같은 carrier_id 안에서 hub_code 순서이기 때문에 PK 정렬을 제공하지 못합니다. 이 인덱스를 쓰면 6,000건을 모두 읽고 정렬해야 합니다. 옵티마이저는 이 비용과 PK 역순 스캔(예상 49행)을 비교해 후자를 골랐습니다. (A, B)가 A를 선두로 가지고 있어도, A 단독 인덱스가 하던 정렬 역할까지 대신하지는 못합니다.
보조 인덱스마다 PK가 함께 저장되는 이 구조 때문에, PK를 무엇으로 정하느냐가 모든 보조 인덱스의 크기에도 영향을 줍니다. 그 영향은 UUID를 PK로 썼을 때 파일 크기와 입력 순서를 비교한 글에서 따로 확인했습니다.
SELECT 목록만 바꿔도 다른 계획이 나왔습니다
처음 반복 측정은 SELECT 목록을 scan_id 하나로 줄인 쿼리로 했습니다. 그런데 ROWS_EXAMINED가 294,001이 아니라 6,001로 나왔습니다. EXPLAIN ANALYZE로 확인해 보니 이 쿼리는 idx_carrier_scanned를 커버링 인덱스로 6,000행 읽고 정렬해 2.58ms에 끝났습니다.
조회 컬럼이 인덱스 안에서 해결되면 테이블 접근 비용이 사라져 계산이 달라진 것입니다. 장애 쿼리를 재현할 때 컬럼을 줄여서 확인하면 문제가 안 보일 수 있으므로, SELECT 목록까지 운영 쿼리 그대로 가져와야 합니다.
조건은 맞는데 기대한 인덱스를 쓰지 않는 경우는 이것만이 아닙니다. 조인 컬럼끼리 캐릭터셋이나 콜레이션이 다를 때도 인덱스를 놓치는데, 그 사례는 조인 컬럼 캐릭터셋 불일치로 인덱스를 타지 못한 사례를 분석한 글에 정리했습니다.
ORDER BY가 PK가 아닌 컬럼이어도 같은 판단이 나옵니다
정렬 컬럼을 scanned_at으로 바꾸고, 최근 구간에만 있는 77번을 오름차순으로 10건 조회했습니다. 이때 A 단독 인덱스는 살아 있고, 복합 인덱스는 없는 상태입니다.
SELECT p.scan_id, p.hub_code, p.scanned_at
FROM parcel_scan_log p
WHERE p.carrier_id = 77
ORDER BY p.scanned_at
LIMIT 10;
전통 EXPLAIN에서 이미 이상한 점이 보였습니다. possible_keys에는 idx_carrier만 있는데, 실제 key는 idx_scanned였고 type은 index, rows는 495, filtered는 2.02였습니다. 조건 후보에 없던 인덱스가 정렬을 이유로 선택된 것입니다.

Handler_read_first 1, Handler_read_next 294,009로, 합치면 EXPLAIN ANALYZE의 실제 rows와 정확히 일치합니다. performance_schema 기준 첫 실행은 1,016.8ms였고, 이후 9회는 1,062.0~1,216.5ms(중앙값 1,140.5ms)였습니다. 첫 실행이 가장 빨랐던 것은 데이터가 이미 버퍼 풀에 올라와 있었기 때문으로 보입니다. 그렇다면 이 1초는 디스크 대기보다는 29만 행을 넘기는 CPU 시간으로 보는 것이 맞습니다.

| 조건 | 사용 인덱스 | 예상 rows | 실제 읽은 행 | 시간 |
|---|---|---|---|---|
| 77번, scanned_at 오름차순 | idx_scanned | 495 | 294,010 | 1,062ms |
| 7번(균등 분포), 오름차순 | idx_scanned | 505 | 456 | 1.25ms |
| 77번, scanned_at 내림차순 | idx_scanned (reverse) | 495 | 10 | 1.56ms |
세 쿼리 모두 같은 정렬 인덱스를 훑는 계획입니다. 옵티마이저의 예상도 7번에서는 거의 맞았습니다. 차이를 만든 것은 계획이 아니라, 찾는 값이 정렬 순서의 어느 끝에 있느냐였습니다.
LIMIT을 줄일수록 옵티마이저는 더 낙관적이었습니다
| LIMIT | 선택 인덱스 | 예상 rows | 실제 |
|---|---|---|---|
| 1 | idx_scanned | 49 | 294,001행, 1,132ms |
| 10 | idx_scanned | 495 | 294,010행, 1,062ms |
| 100 | idx_scanned | 4,955 | 계획만 확인 |
| 500 / 1,000 / 2,000 / 5,000 | idx_carrier + Sort | 6,000 | 계획만 확인 |
LIMIT이 작을수록 몇 행만 읽으면 된다는 예상이 줄어들고, 정렬 인덱스 쪽이 유리해 보입니다. 이번 데이터에서는 LIMIT 100까지 idx_scanned를 고르다가 500부터 idx_carrier + Sort로 돌아왔습니다. 정렬 인덱스로 읽을 예상 행 수가 77번 전체 6,000행을 넘어서는 구간에서 바뀐 것으로 보입니다. 다만 100과 500 사이의 정확한 전환 지점은 측정하지 않았습니다.
운영 장애 쿼리가 LIMIT 1이었다는 점도 이 결과와 맞물립니다. 1건만 가져오는 쿼리라 가벼워 보이지만, 옵티마이저 입장에서는 정렬 인덱스로 갈아탈 동기가 가장 강한 형태입니다.
같은 쿼리에 해결책 네 가지를 대 봤습니다
| 방법 | 계획 | 읽은 행 | 시간 |
|---|---|---|---|
세션에서 prefer_ordering_index=off | idx_carrier + Sort | 6,000 | 첫 실행 6.1ms, 반복 중앙값 약 9.2ms |
NO_ORDER_INDEX(p idx_scanned) 힌트 | idx_carrier + Sort | 6,000 | 11.9ms |
| (carrier_id, scanned_at) 복합 인덱스 | idx_carrier_scanned | 10 | 1.13ms, 반복 중앙값 약 1.6ms |
| PK 정렬 쿼리에서 A 단독 인덱스 VISIBLE 원복 | idx_carrier (reverse) | 1 | 0.52ms |

스위치를 끄는 방법과 힌트는 결과가 같았습니다. 힌트를 쓴 뒤 SHOW WARNINGS도 비어 있었습니다. 두 방법 모두 29만 행을 6,000행으로 줄였지만 정렬 비용은 남습니다.
둘 중에서는 힌트의 적용 범위가 좁습니다. optimizer_switch를 전역으로 끄면 7번처럼 정렬 인덱스 덕에 456행만 읽던 쿼리까지 같은 영향을 받습니다. 그 경우 얼마나 느려지는지는 이번에 측정하지 않았습니다. 반대로 힌트는 인덱스 이름에 묶여 있어서, 나중에 인덱스를 정리할 때 함께 챙겨야 하는 부담이 생깁니다.

복합 인덱스가 가장 확실했습니다. Handler_read_key 1, Handler_read_next 9로 딱 10행을 읽었고, 균등 분포인 7번도 10행, 1.4ms에 끝났습니다. 다만 이 효과는 WHERE와 ORDER BY의 순서가 인덱스와 정확히 맞을 때만 납니다. 정렬 기준이 PK라면 A 단독 인덱스가 이미 그 역할을 하고 있으므로, 새로 만들 것은 없고 지우지 않는 것이 답입니다.
원복 시간 차이: 14ms와 1시간
INVISIBLE로 숨겼던 idx_carrier를 ALTER INDEX ... VISIBLE로 되돌리는 데 14.49ms가 걸렸고, 계획도 바로 1행짜리로 돌아왔습니다. 비교를 위해 실제로 DROP(29.056ms)하고 다시 CREATE INDEX하자 30만 건 테이블에서 1.28초가 걸렸습니다.
이 1.28초를 운영의 1시간과 비례로 비교할 수는 없습니다. 운영에서는 지연된 서비스 쿼리가 IOPS를 다 쓰고 있어서 인덱스 생성 자체가 진행되지 않았습니다. 장애 중에는 인덱스를 다시 만드는 일 자체가 가장 비싼 작업이 됩니다. 반면 INVISIBLE 상태로 두면, 문제가 생겨도 디스크를 거의 쓰지 않고 바로 되돌릴 수 있습니다.
중복 인덱스 정리 목록에서 A 단독 인덱스를 빼 두는 이유
(A, B) 인덱스가 생기면 A 단독 인덱스는 선두 컬럼이 겹쳐 중복처럼 보입니다. 하지만 A 조건에 PK 정렬과 LIMIT이 붙은 쿼리가 있다면, A 단독 인덱스는 조건 검색과 정렬을 한 번에 해결하던 인덱스입니다. 단독 인덱스를 정리하기 전에는 다음 순서로 확인합니다.
- 그 컬럼을 조건으로 쓰면서
ORDER BY PK나 다른 정렬 컬럼에 LIMIT이 붙은 쿼리가 있는지 - 남는 인덱스가 그 정렬 순서를 그대로 제공하는지
- 조건값별로 PK나 정렬 컬럼의 MIN/MAX를 봤을 때, 한쪽 끝에 몰린 값(해지 고객, 신규 거래처 등)이 있는지
- 삭제하기 전에 INVISIBLE로 바꿔 두고, 실제 SELECT 목록 그대로 EXPLAIN ANALYZE를 확인했는지
이번 재현은 단일 세션, 30만 건, 완전히 한쪽 끝에 몰린 인위적 분포에서 나온 결과입니다. 데이터가 모두 버퍼 풀에 있었는데도 PRIMARY 역순 스캔 한 번에 약 100~150ms가 들었습니다. 디스크에서 읽어야 하는 큰 운영 테이블이라면 같은 294,001행이 I/O 요청으로 바뀌어 더 무거워질 것으로 예상하지만, 이 부분은 측정하지 않은 추정입니다.
옵티마이저는 49행이면 끝난다고 믿었고, 그 믿음을 깨는 것은 쿼리 모양이 아니라 데이터가 놓인 위치였습니다. 그래서 A 단독 인덱스를 보호하는 운영 기준은 이번 재현에서도 그대로 유지할 만한 판단이었습니다.



댓글 0
첫 댓글을 남겨보세요.