MySQL 8.4 콜레이션 비교 규칙: 대소문자는 같고 뒤 공백은 다른 이유와 유니크 키 충돌

8.4 기본 콜레이션은 뒤 공백이 붙은 a를 별도 값으로 저장했다
MySQL은 문자열 끝의 공백을 무시하고 비교한다는 설명이 있습니다. utf8mb4_general_ci 같은 콜레이션 기준으로는 맞는 말입니다. 그런데 MySQL 8.4.11에서 콜레이션을 지정하지 않고 만든 테이블에 'a'와 'a '를 넣어 보니 두 값이 모두 저장됐습니다. 반대로 'A'는 중복으로 막혔습니다.
대소문자는 같은 값으로 보고 뒤 공백은 다른 값으로 보는 이 판정은 콜레이션이 정합니다. 그리고 그 판정이 유니크 키의 중복 여부, WHERE 검색 결과, 콜레이션 변경 ALTER의 성공 여부까지 그대로 결정합니다. 아래 내용은 이 세 가지를 같은 값 6개로 차례대로 확인한 기록입니다.
비교 기준부터 고정한 테스트 환경
MySQL Community Server 8.4.11, Windows, MySQL Workbench에서 진행했습니다. 리터럴끼리 비교할 때는 컬럼이 아니라 연결 콜레이션(collation_connection)이 기준이 됩니다. 그래서 Workbench가 잡은 세션 값을 먼저 기록했습니다.

SHOW SESSION VARIABLES
WHERE Variable_name IN ('character_set_server','collation_server',
                        'character_set_connection','collation_connection',
                        'character_set_database','collation_database',
                        'default_collation_for_utf8mb4');

character_set_connection        utf8mb4
character_set_database          utf8mb4
character_set_server            utf8mb4
collation_connection            utf8mb4_0900_ai_ci
collation_database              utf8mb4_0900_ai_ci
collation_server                utf8mb4_0900_ai_ci
default_collation_for_utf8mb4   utf8mb4_0900_ai_ci
서버, 연결, DB가 모두 utf8mb4_0900_ai_ci였습니다. SET NAMES utf8mb4를 실행한 뒤에도 연결 콜레이션은 같은 값으로 유지됐습니다. 콜레이션을 지정하지 않고 만든 coll_lab DB 역시 utf8mb4_0900_ai_ci를 상속했습니다.
테이블은 닉네임 컬럼 하나에 유니크 키를 건 구조로 4개를 만들었습니다. 이 주제는 건수와 상관없는 판정 규칙을 보는 것이라, 결과가 한 화면에 다 보이도록 테이블마다 같은 값 6개만 넣었습니다.
CREATE TABLE nick_default (          -- 콜레이션 미지정
  id     INT UNSIGNED NOT NULL AUTO_INCREMENT PRIMARY KEY,
  handle VARCHAR(30) NOT NULL,
  UNIQUE KEY uk_handle (handle)
) ENGINE=InnoDB;

-- nick_general : handle VARCHAR(30) COLLATE utf8mb4_general_ci
-- nick_as_cs   : handle VARCHAR(30) COLLATE utf8mb4_0900_as_cs
-- nick_char    : handle CHAR(30), 콜레이션 미지정

INSERT IGNORE INTO nick_default (handle)
VALUES ('a'),('A'),('a '),('á'),('ss'),('ß');
SHOW WARNINGS;
콜레이션 6개에 같은 질문을 던진 결과
먼저 각 콜레이션이 뒤 공백을 어떻게 다루는지 information_schema.COLLATIONS의 PAD_ATTRIBUTE로 확인했습니다.
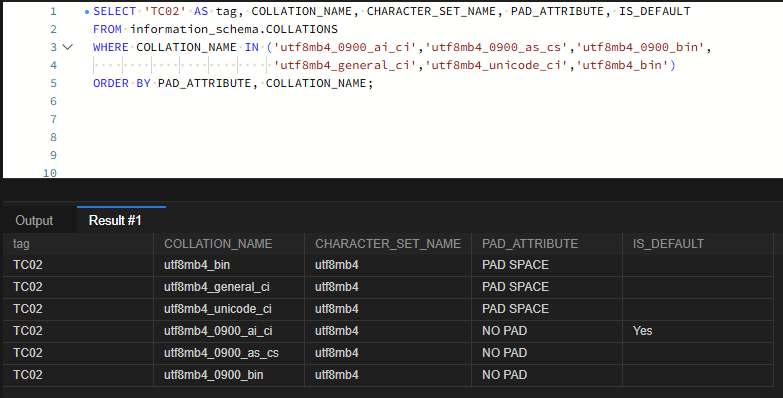
이어서 같은 값 쌍을 콜레이션만 바꿔 가며 비교했습니다. 각 식은 'a' = 'a ' COLLATE utf8mb4_0900_ai_ci처럼 오른쪽 리터럴에 콜레이션을 명시하는 형태입니다.
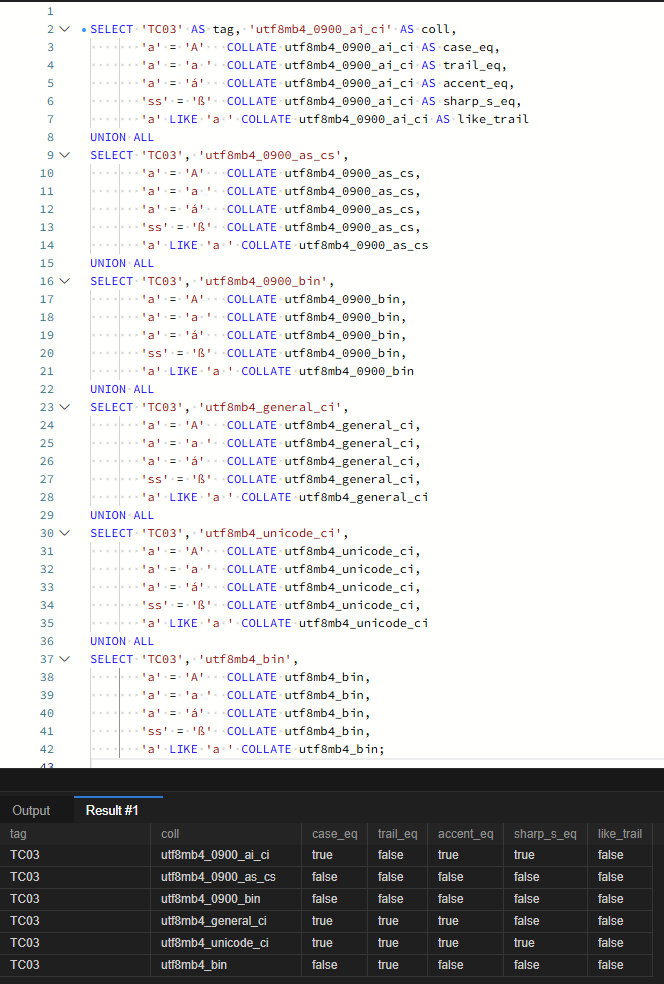
| 콜레이션 | 'a'='A' | 'a'='a ' | 'a'='á' | 'ss'='ß' | 'a' LIKE 'a ' |
|---|---|---|---|---|---|
| utf8mb4_0900_ai_ci | true | false | true | true | false |
| utf8mb4_0900_as_cs | false | false | false | false | false |
| utf8mb4_0900_bin | false | false | false | false | false |
| utf8mb4_general_ci | true | true | true | false | false |
| utf8mb4_unicode_ci | true | true | true | true | false |
| utf8mb4_bin | false | true | false | false | false |
표를 열 단위로 보면 판정 기준이 두 갈래로 나뉩니다. 대소문자와 악센트는 이름의 ci/cs, ai/as가 결정합니다. 뒤 공백은 PAD 속성이 결정하며, PAD SPACE 세 개만 true였습니다.
주의할 결과는 utf8mb4_bin입니다. 대소문자와 악센트를 모두 구분하면서도 뒤 공백 비교는 true로 나왔습니다. 이름에 bin이 붙었다고 바이트 단위로 완전히 같은지 비교한다고 볼 수 없다는 뜻입니다. 같은 bin이라도 utf8mb4_0900_bin은 NO PAD라서 모든 비교가 false였습니다.
'ss'='ß'는 utf8mb4_general_ci에서만 false였고, 같은 PAD SPACE 계열인 utf8mb4_unicode_ci는 true였습니다. LIKE는 여섯 콜레이션 모두 false였습니다. = 비교에서는 뒤 공백을 무시하는 PAD SPACE 콜레이션이라도, LIKE 패턴 비교에서는 뒤 공백을 무시하지 않았습니다.
비교 규칙이 유니크 키에서는 중복 판정으로 바뀐다
같은 6개 값을 테이블 4개에 INSERT IGNORE로 넣고, 살아남은 행을 HEX 값과 함께 조회했습니다.

| 테이블 | 컬럼 | 저장된 값 | 중복으로 막힌 값 |
|---|---|---|---|
| nick_default | VARCHAR, 0900_ai_ci | a, a␠(6120), ss | A, á, ß |
| nick_general | VARCHAR, general_ci | a, ss, ß | A, a␠, á |
| nick_as_cs | VARCHAR, 0900_as_cs | 6개 모두 | 없음 |
| nick_char | CHAR, 0900_ai_ci | a, ss | A, a␠, á, ß |
nick_default와 nick_general은 행 수가 3개로 같지만 저장된 값의 구성은 다릅니다. 기본 콜레이션은 'a '를 받고 'ß'를 막았습니다. general_ci는 정반대로 'ß'를 받고 'a '를 막았습니다. 5.7에서 넘어온 테이블과 8.4에서 새로 만든 테이블이 섞여 있으면, 같은 데이터를 넣어도 테이블마다 다른 행이 남을 수 있습니다.
nick_as_cs에서는 INSERT를 실수로 두 번 실행했습니다. 첫 실행에서 6개가 모두 저장됐고, 두 번째 실행에서는 6개 전부 1062 경고가 났습니다. 이후 SHOW CREATE TABLE에 찍힌 값은 AUTO_INCREMENT=13이었습니다. 행은 6개뿐인데 다음 번호가 13이라, 중복으로 실패한 INSERT도 자동 증가 번호를 소비한 것으로 보입니다.
CHAR 컬럼은 NO PAD 콜레이션인데도 뒤 공백 값을 막았다
nick_char는 nick_default와 콜레이션이 같은 utf8mb4_0900_ai_ci입니다. 그런데도 'a '가 중복으로 막혔고, 경고 메시지에는 입력값이 Duplicate entry 'a'로 찍혔습니다. 저장된 a의 HEX도 61, 길이 1이었습니다.
CHAR는 값의 끝 공백을 제거한 형태로 다루기 때문에, 콜레이션의 PAD 속성과 상관없이 'a '가 'a'와 같은 값이 된 것으로 해석됩니다. 뒤 공백 비교 규칙을 이야기할 때는 콜레이션과 함께 컬럼 타입도 확인해야 합니다.
오류 메시지에는 기존 값이 아니라 새로 넣은 값이 나온다
IGNORE 없이 'A'를 넣으면 MySQL Error (1062): Duplicate entry 'A' for key 'nick_default.uk_handle'가 발생합니다. 테이블에 실제로 있는 값은 소문자 a인데 메시지에는 대문자 A가 표시됩니다. 애플리케이션 로그만 보고 'A'를 찾으려 하면 원인을 놓치기 쉽습니다. 이런 경우에는 같은 콜레이션으로 WHERE handle = 'A'를 조회해서, 어떤 기존 값과 충돌했는지 확인하는 편이 빠릅니다.
대문자로 검색하면 소문자 행이 나오고, 대소문자 구분 검색은 인덱스를 다르게 쓴다
SELECT id, CONCAT('[', handle, ']') FROM nick_default WHERE handle = 'A';   -- 1, [a]
SELECT id, CONCAT('[', handle, ']') FROM nick_default WHERE handle = 'a ';  -- 2, [a ]
SELECT id, CONCAT('[', handle, ']') FROM nick_general WHERE handle = 'a ';  -- 1, [a]
기본 콜레이션에서는 대문자로 검색해도 소문자 행이 나옵니다. 반면 'a '로 검색하면 공백이 붙은 행만 정확히 찾아옵니다. general_ci 테이블은 같은 'a ' 검색에 공백 없는 a를 돌려줬습니다. 로그인 ID나 쿠폰 코드처럼 정확히 일치해야 하는 값이라면, 이 차이가 곧 다른 사용자의 행을 찾아오는 문제로 이어집니다.
컬럼은 그대로 두고 쿼리에서 대소문자를 구분하려면 보통 COLLATE를 붙입니다. 세 가지 작성 방식을 EXPLAIN으로 비교했습니다.
-- TC05d
EXPLAIN SELECT id, handle FROM nick_default WHERE handle = 'A';
type=const  key=uk_handle  ref=const  rows=1  filtered=100  Extra=Using index

-- TC05e
EXPLAIN SELECT id, handle FROM nick_default
WHERE handle = 'A' COLLATE utf8mb4_0900_as_cs;
type=index  key=uk_handle  ref=NULL  rows=3  filtered=33.33  Extra=Using where; Using index

-- TC05f
EXPLAIN SELECT id, handle FROM nick_default
WHERE handle = 'A' AND handle COLLATE utf8mb4_0900_as_cs = 'A';
Extra=Impossible WHERE noticed after reading const tables
TC05e처럼 비교 전체를 다른 콜레이션으로 바꾸면 유니크 인덱스로 한 건을 찾지 못합니다. 인덱스 전체를 훑은 뒤(type=index, rows 3) 조건으로 걸러냈습니다. 콜레이션이 달라 인덱스 탐색을 못 하는 원리는 조인 컬럼의 문자셋·콜레이션 불일치와 인덱스 글에서 조인 쪽으로 다룬 내용과 같습니다.
TC05f는 기존 콜레이션 조건으로 먼저 유니크 인덱스를 const 조회한 뒤, 그 한 행에 대소문자 구분 조건을 적용하는 방식입니다. 옵티마이저는 실행 전에 const 행(a)을 읽어 두 번째 조건이 거짓임을 확인했고, Impossible WHERE로 끝냈습니다. 결과는 0건으로 정확하고, 인덱스 전체를 읽지도 않았습니다.
이번 테이블은 3행이라 TC05e의 비용 차이는 숫자로 드러나지 않았습니다. 행이 많아질수록 index 스캔 범위가 커질 것이라는 점은 측정이 아니라 실행계획 형태에서 나온 추정입니다.
콜레이션을 ci로 맞추려는 ALTER가 1062에서 멈춘다
운영 중 테이블 간 조인 쿼리에서 오류가 나서 확인해 보니, 테이블마다 콜레이션이 섞여 있었던 적이 있습니다. 그 뒤 장기 과제로 콜레이션을 맞추는 작업을 진행했습니다. 컬럼별로 바꿔 보니 온라인 DDL로 처리되는 경우도 있었지만, 인덱스가 걸린 컬럼은 COPY 방식으로 해야 했습니다. 서비스를 멈출 수 없는 테이블은 AWS RDS 환경이어서 Blue/Green 환경을 구성하고 그린 쪽에서 변경했습니다.
이 작업에서 시간이 오래 걸리는 것도 문제지만, 변경 자체가 실패할 수도 있습니다. 대소문자를 구분하던 nick_as_cs를 기본 콜레이션으로 바꾸려 하자 ALTER가 1062로 중단됐습니다.

실패 후 SHOW CREATE TABLE을 확인하니 컬럼은 여전히 utf8mb4_0900_as_cs였습니다. 테이블 정의는 바뀌지 않았지만, 오류 메시지가 알려 주는 충돌 값은 'A' 하나뿐입니다. 이 값만 고치고 다시 실행하면 다음 충돌에서 또 멈춥니다. 대형 테이블에서 COPY가 오래 돌다가 실패하는 일을 반복하지 않으려면, 충돌 그룹 전체를 ALTER 전에 뽑아야 합니다.
SELECT handle COLLATE utf8mb4_0900_ai_ci AS norm_key,
       COUNT(*) AS cnt,
       GROUP_CONCAT(CONCAT('[', handle, ']') ORDER BY id SEPARATOR ' , ') AS members
FROM nick_as_cs
GROUP BY norm_key
HAVING COUNT(*) > 1;
사전 점검에서는 충돌 그룹이 2개 나왔습니다. a 그룹에 a, A, á 3건, ss 그룹에 ss, ß 2건입니다. ALTER 오류 메시지만 보고는 알 수 없던 ß까지 미리 드러났습니다.
반대로 'a '는 어떤 그룹에도 묶이지 않았습니다. 목표 콜레이션인 utf8mb4_0900_ai_ci가 NO PAD라서 뒤 공백 값을 다른 값으로 보기 때문입니다. 목표가 utf8mb4_general_ci였다면 'a '도 같은 그룹에 들어갔을 것입니다. 이 점검 쿼리는 반드시 실제로 바꿀 콜레이션 이름 그대로 실행해야 합니다.
점검 결과로 판단할 것
- 충돌 그룹이 나오면 어느 값을 남길지를 데이터를 쓰는 업무 담당자와 먼저 정해야 합니다. 값이 정리되기 전에는 ALTER를 다시 걸어도 같은 1062에서 멈춥니다.
- 대소문자 구분이 업무 규칙이라면(쿠폰 코드, 외부 시스템 키 등) 컬럼을 ci로 맞추는 것 자체가 잘못된 선택일 수 있습니다. 이 경우 조인 상대 쪽을 cs로 맞추는 방향을 검토합니다.
ALTER 전에 돌려 보는 GROUP BY 한 번
콜레이션 대상 컬럼이 여러 테이블에 흩어져 있으면 점검도 컬럼 단위로 해야 합니다. ALTER를 걸기 전에 아래 순서로 확인합니다.
먼저 바꿀 대상 컬럼의 타입과 현재 콜레이션을 한 번에 뽑습니다.
SELECT TABLE_NAME, COLUMN_NAME, DATA_TYPE, COLLATION_NAME
FROM information_schema.COLUMNS
WHERE TABLE_SCHEMA = 'coll_lab'
  AND COLLATION_NAME IS NOT NULL
ORDER BY COLLATION_NAME, TABLE_NAME, COLUMN_NAME;- 목록에서 CHAR 컬럼은 따로 표시해 둡니다. nick_char처럼 콜레이션이 NO PAD여도 뒤 공백 값을 같은 값으로 보기 때문입니다.
- 유니크 키나 PK에 포함된 컬럼은 앞의 GROUP BY 점검을 실행해, 결과가 0건일 때만 ALTER 대상에 올립니다.
- 충돌 그룹이 나온 컬럼은 남길 값을 정해 정리한 뒤, 같은 조회를 한 번 더 돌려 0건을 확인합니다.
운영에서 Blue/Green의 그린 쪽에서 콜레이션을 바꿨던 테이블도 마찬가지입니다. 그린에 ALTER를 걸기 전에 이 조회를 먼저 돌려 두면, 전환 일정 안에서 1062로 다시 시작하는 일을 줄일 수 있습니다.



댓글 0
첫 댓글을 남겨보세요.